
如何使用VS Code的语言API在TypeScript中构建代码图表
现代的代码库变得越来越难以浏览。这并不一定是因为开发人员自己编写了更多的代码,而主要是因为编码辅助工具会生成成百上千行代码,因此代码审查成为了了一个亟待解决的问题。 在大型语言模型出现之前,你可能需要花费数天的时间才能编写出几行代码。这意味着你的参与会让某个项目的代码结构逐渐丰富起来;只有当你加入新的团队或开始新的工作时,才需要去审查和了解那些新添加的代码。 但如今,一个简单的指令就能在几分钟内生成数千行代码,这些代码分散在上百个文件中。在这种规模下,传统的代码审查方式已经不再适用了——你花费在审查代码上的时间,实际上比编写代码的时间还要多。 例如,如果你打开一个庞大的TypeScript项目
现代的代码库变得越来越难以浏览。这并不一定是因为开发人员自己编写了更多的代码,而主要是因为编码辅助工具会生成成百上千行代码,因此代码审查成为了了一个亟待解决的问题。
在大型语言模型出现之前,你可能需要花费数天的时间才能编写出几行代码。这意味着你的参与会让某个项目的代码结构逐渐丰富起来;只有当你加入新的团队或开始新的工作时,才需要去审查和了解那些新添加的代码。
但如今,一个简单的指令就能在几分钟内生成数千行代码,这些代码分散在上百个文件中。在这种规模下,传统的代码审查方式已经不再适用了——你花费在审查代码上的时间,实际上比编写代码的时间还要多。
例如,如果你打开一个庞大的TypeScript项目,想要回答这样一个看似简单的问题:“是什么调用了这个函数?”
“是什么调用了这个函数?”
你可能会首先开始搜索文件,使用编辑器的“查找引用”功能,或者在不同的定义之间跳转,同时也会搜索导入、导出以及函数名称等信息。
但其实还有另一种思考问题的方式。我们不必将代码库视为一组独立的文件,而可以将其抽象成一个图结构。
在这里,函数就代表着节点,而函数之间的调用关系则对应着边。
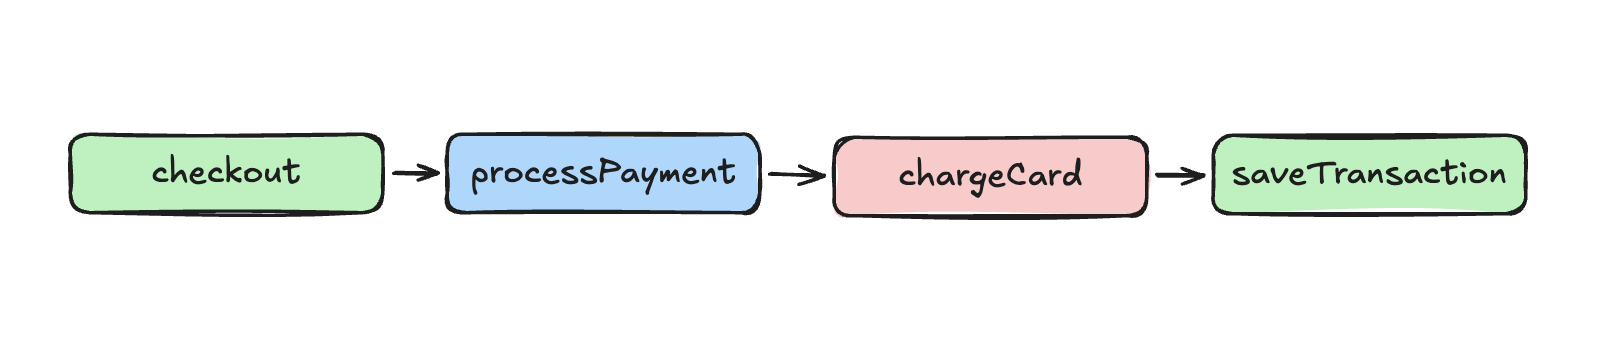
一旦代码被表示成图结构,像“是什么调用了这个函数?”或者“这个函数最终会调用什么函数?”这样的问题,就变成了图遍历问题。
在本教程中,我们将使用TypeScript以及VS Code内置的语言API来构建代码图的框架。我们不会自己编写TypeScript解析器,而是直接利用VS Code和已安装的语言扩展所提供的功能。最终得到的结果将是一个包含文件、函数、方法以及它们之间调用关系的图结构,这个图结构可以在VS Code的Webview中显示出来。
目录
我们正在构建什么
我们将开发一个小型代码图引擎,该引擎会利用VS Code的调用层次结构API来识别函数与方法之间的关系,并能够跨越多个层级来分析这些关系。在开发过程中,我们需要处理并发问题、过时的语言工具引用、缓存机制以及重复遍历的情况,以确保代码图的准确性和效率。
先决条件
在开始学习之前,您需要掌握以下内容:
TypeScript语法以及使用`async`/`await`进行异步编程的基础知识
任何能与VS Code兼容的代码、VS Code扩展API,以及`vscodecommands.executeCommand`函数
关于图论的基本概念,比如节点、边以及广度优先搜索算法
在TypeScript中使用映射、数组和泛型函数进行编程的能力
那我们开始吧!
假设我们有以下代码:
function checkout() {
  processPayment();
}

function processPayment() {
  chargeCard();
}

function chargeCard() {
  saveTransaction();
}

function saveTransaction() {
  // 保存交易信息
}
我们希望将这段源代码转换成一张代码图。对于实际的代码库来说,这张代码图可能会涵盖多个文件:
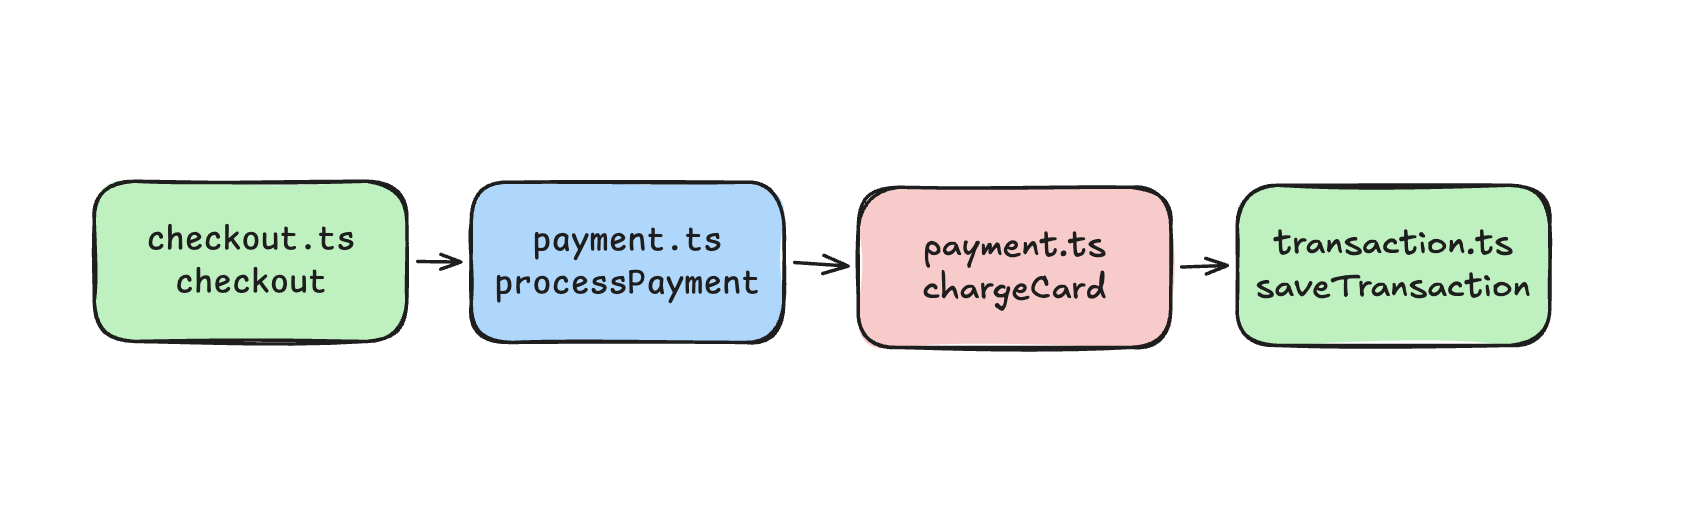
这个实现主要由两部分组成:扩展程序宿主会利用VS Code的语言API来生成代码图,而Webview则会负责显示生成的代码图。其中最值得关注的部分就是用于构建代码图的那个模块。
1. 了解VS Code的语言API
VS Code已经提供了多种扩展程序可以使用的命令,这些命令可用于查询语言相关信息。对于这个项目来说,有四个命令特别有用:
| 命令 | 用途 |
|---|---|
vscode.executeDocumentSymbolProvider |
在文档中查找符号 |
vscode.prepareCallHierarchy |
将某个位置解析为调用层次结构中的相应项 |
vscode.provideIncomingCalls |
查找调用者 |
vscode.provideOutgoingCalls |
查找被调用者 |
这些API位于特定语言实现层之上。对于TypeScript和JavaScript来说,TypeScript语言服务会提供底层所需的信息;而对于其他语言,它们也会通过各自的语言扩展程序和语言服务器来提供类似的功能,例如Go语言的gopls、Rust语言的rust-analyser,以及Python语言的Pyright或Pylance。
这一点非常重要,因为我们不需要为每种语言都单独开发解析器和代码图生成引擎。如果某种语言的扩展程序能够通过VS Code提供文档符号和调用层次结构相关的支持,那么同样的代码图构建架构就可以直接使用这些信息了。
AST可以帮助我们判断某个函数是否包含调用表达式,但它无法自动确定这种调用是在哪些文件、模块或语言结构中发生的。
语言服务器已经完成了大部分这类语义分析工作。因此,我们无需再编写额外的解析器或符号解析工具,而是可以直接向VS Code请求它已掌握的信息。
2. 设置扩展程序
在我们的`package.json`文件中,我们定义了一个命令:
{
"main": "./out/extension.js",
"engines": {
"vscode": "^1.85.0"
},
"activationEvents": [],
"contributes": {
"commands": [
{
"command": "codeGraphView.open",
"title": "代码图:打开当前文件的代码结构图",
"icon": "$(type-hierarchy)"
}
],
"menus": {
"editor/title": [
{
"command": "codeGraphView.open",
"group": "navigation",
"when": "resourceLangId == typescript"
}
]
}
},
"dependencies": {
"elkjs": "^0.9.3"
}
}
扩展程序的宿主部分与Webview运行在不同的环境中,因此它们需要被分别打包。一个简化的esbuild配置文件如下所示:
const extensionConfig = {
entryPoints: ['src/extension.ts'],
bundle: true,
outfile: 'out/extension.js',
external: ['vscode'],
format: 'cjs',
platform: 'node',
};
const webviewConfig = {
entryPoints: ['webview/main.ts'],
bundle: true,
outfile: 'out/webview/main.js',
format: 'iife',
platform: 'browser',
};
扩展程序的代码是在Node环境中运行的,而Webview的代码则运行在浏览器环境中。
3. 设计图数据模型
在调用语言相关的API之前,我们首先需要确定代码结构图的形态。一个实用的模型如下所示:
export interface SymbolRow {
id: string;
name: string;
kind: 'function' | 'method';
line: number;
character: number;
}
export interface FileNode {
id: string;
label: string;
file: string;
symbols: SymbolRow[];
}
export interface CallEdge {
id: string;
source: string;
target: string;
}
export interface GraphData {
rootFileId: string;
rootSymbolId?: string;
roots: string[];
files: FileNode[];
edges: CallEdge[];
truncated: boolean;
}
这里有两个重要的概念需要了解:
`FileNode`代表文件中包含的所有函数或方法。
`CallEdge`表示两个符号之间的关联关系。
我们统一了边的方向规则:
caller → callee
因此,如果`checkout()`函数调用了`processPayment()`函数,那么在代码结构图中,这条边的方向一定是“checkout → processPayment”。
即使我们在查看来电信息时发现了这种关联关系,也是如此。
稳定的符号标识符
函数名称并不具有唯一性。一个项目中很可能会存在以下情况:
// users.ts
function save() {}
以及:
payments.ts
function save() {}
因此,我们需要根据符号在代码中的位置来为其生成唯一的标识符。
function idOf(
uri: vscode.Uri,
pos: vscode.Position
): string {
return `${uri.toString()}#${pos.line}:${pos.character}`;
}
对于那些属于调用层次结构中的元素,我们可以使用它们的selectionRange属性来获取标识符:
function itemId(
item: vscode.CallHierarchyItem
): string {
return idOf(
item.uri,
item_selectionRange.start
);
}
使用selectionRange之所以有用,是因为它能够识别符号的名称,而不是整个代码段或声明范围。这种稳定的标识符是实现去重功能的基础。如果通过代码图中的不同路径发现了同一个函数,我们就可以确定这些发现实际上都是指向同一个节点。
4. 查找函数和方法
构建代码图的第一步就是找出当前激活文件中所有的符号。VS Code通过以下方式提供了对这些符号的访问接口:
vscode.executeDocumentSymbolProvider
我们可以这样调用它:
/*
* 使用VS Code内置的语言服务来获取文档中的所有符号,而无需自行解析代码。这样一来,我们就能得到文档中的方法、函数和变量等信息。
*/
async function getDocumentSymbols(
uri: vscode Uri
): Promise<vscode.DocumentSymbol[]>> {
/*
* `vscode.executeDocumentSymbolProvider`会将分析任务委托给为该文档所支持的语言注册的语言服务提供商。
*/
const result =
await vscodecommands.executeCommand<
vscode.DocumentSymbol[] | undefined
>>(
'vscodeexecuteDocumentSymbolProvider',
uri
);
// 如果没有找到任何符号,就返回一个空数组。
return result ?? [];
}
返回出来的这些符号会形成一个层次结构。例如:
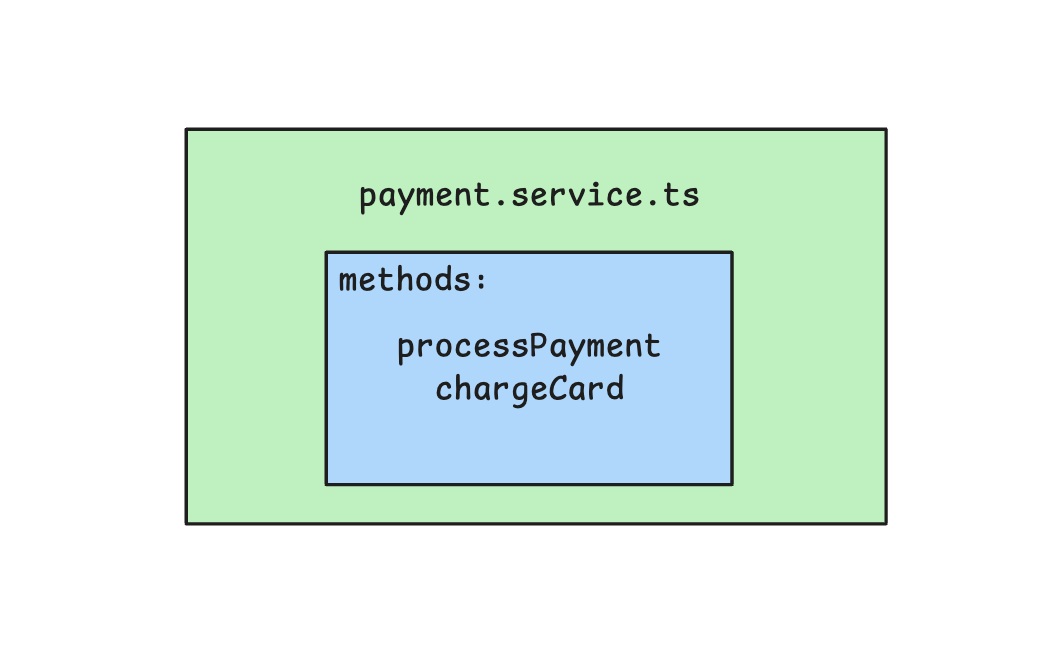
我们需要遍历这个层次结构,并收集那些可能代表可执行代码的符号。
// 判断某个符号是否属于可执行的节点。
const isCallableKind = (
kind: vscode.SymbolKind,
includeConstructors: boolean
) =>
kind === vscode.SymbolKind.Function ||
kind === vscode.SymbolKind.Method ||
(
includeConstructors && kind === vscode.SymbolKind.Constructor
);
我们可以递归地遍历符号树:
// 递归地从符号树中收集函数、方法和变量
function collectCandidates(
symbols: vscode.DocumentSymbol [],
isCallable: (
kind: vscode.SymbolKind
) => boolean,
out: vscode.DocumentSymbol[] = []
) {
for (const symbol of symbols) {
if (
isCallable(symbol.kind) ||
symbol.kind === vscode.SymbolKind.Variable
) {
out.push(symbol);
} else if (
symbol.children.length > 0
) {
collectCandidates(
symbol.children,
isCallable,
out
);
}
}
return out;
}
变量值得被重点考虑,因为赋值给变量的函数可能会被语言工具以不同的方式呈现出来。例如:
const handler = () => {
// ...
};
即使某个符号参与了调用层次结构,它仍然可能被识别为变量。
5. 在指定位置查找符号
当用户打开某个方法的代码图时,我们需要确定哪个符号对应着光标所在的位置。由于文档符号具有层次结构,我们可以递归地找到包含该位置的最底层符号。
// 查找包含特定位置的最具体符号
function symbolAt(
symbols: vscode.DocumentSymbol [],
position: vscode.Position
) {
for (const symbol of symbols) {
if (symbol.range.contains(position)) {
return (
symbolAt(
symbol.children,
position
) ?? symbol
);
}
}
return undefined;
}
这一机制使得编辑器与代码图能够顺利连接起来:用户在源文件中选定一个位置,系统会将该位置对应到某个符号,然后再将该符号转化为调用层次结构中的相应节点。
6. 解析调用层次结构
调用层次结构的API分为两个阶段来执行。首先:
position → CallHierarchyItem
然后:
CallHierarchyItem → 入站/出站调用关系
我们可以按照以下方式准备这些数据:
async function prepare(
uri: vscode Uri,
position: vscode.Position
) {
// VS Code的语言工具已经掌握了如何解析源文件中的符号,
// 因此我们可以利用它来生成该位置处的调用层次结构。
const items =
await vscodecommands.executeCommand<
vscode.CallHierarchyItem[] | undefined
>(
'vscode.prepareCallHierarchy',
uri,
position
);
// 这个命令会返回一个包含层次结构信息的数组。在我们的例子中,
// 我们只需要获取光标所在位置下的那个符号,因此直接使用数组的第一个元素即可。
// 可选链式调用也能处理在指定位置无法找到任何符号的情况。
return items?.[0];
}
一旦我们获得了某个元素,就可以查询调用它的符号:
async function callers(item: vscode.CallHierarchyItem) {
// 向 VS Code 请求所有调用该元素的符号。
const calls =
await vscodecommands.executeCommand<
vscode.CallHierarchyIncomingCall[] | undefined
>(
'vscode.provideIncomingCalls',
item
);
// 返回调用该元素的符号;如果没有找到任何符号,则返回一个空列表。
return (
calls ?? []
).map(call => call.from);
}
或者,也可以查询被该元素调用的符号:
async function callees(item: vscode.CallHierarchyItem) {
// 向 VS Code 请求所有被该元素调用的符号。
const calls =
await vscodecommands.executeCommand<
vscode.CallHierarchyOutgoingCall[] | undefined
>(
'vscode.provideOutgoingCalls',
item
);
// 返回被该元素调用的符号;如果没有找到任何符号,则返回一个空列表。
return (
calls ?? []
).map(call => call.to);
}
如果我们有这样的图结构:
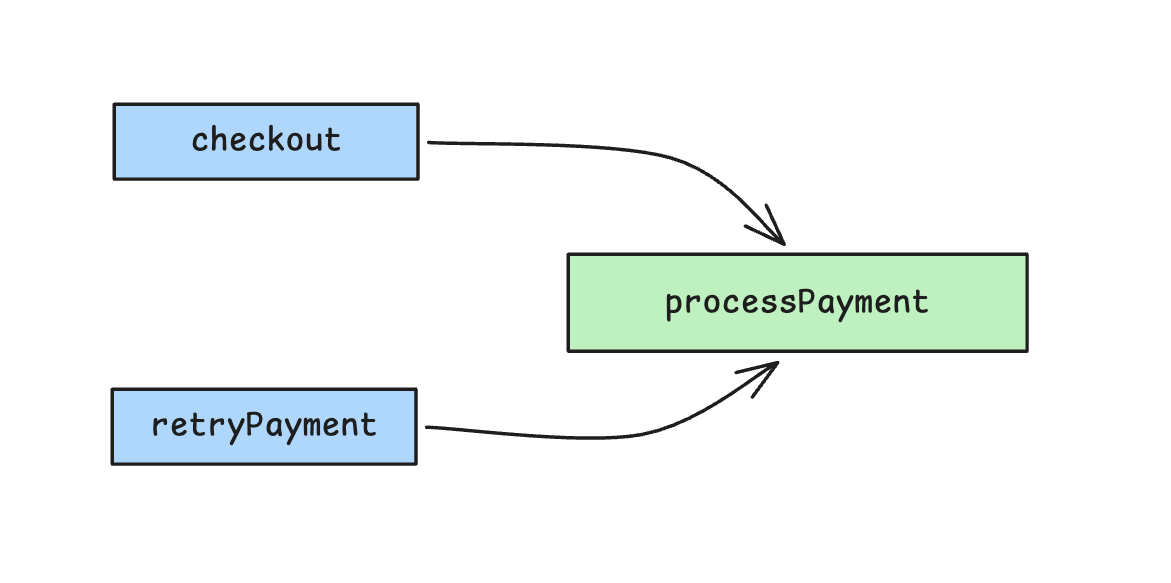
并且我们查询 processPayment 的调用者,那么语言 API 会返回:
checkout
retryPayment
我们将这些结果整理成如下形式:
checkout → processPayment
retryPayment → processPayment
因此,同样的图结构既可以用来表示调用关系,也可以用来表示被调用关系。
7. 构建符号注册表
在遍历这个图结构的过程中,同一个符号可能会多次出现。例如:
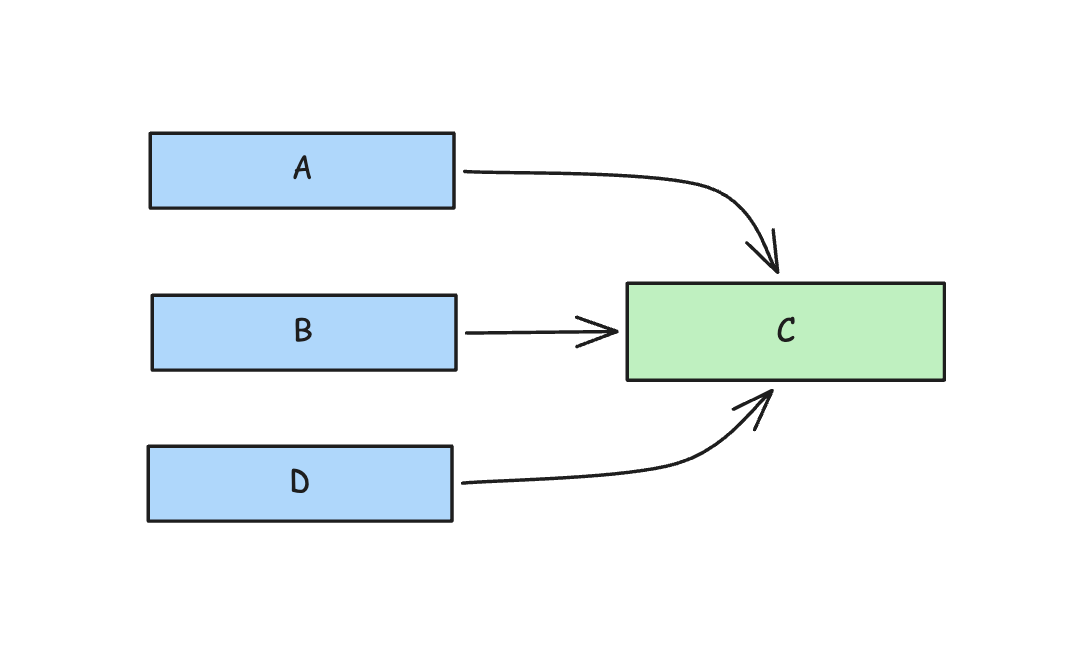
我们应该为 C 创建一个节点,而不是三个。注册表正好起到了去除重复数据的作用。
class Registry {
// 将文件及其对应的符号分开存储,这样就可以在图结构中重复使用这些信息。
private readonly files =
new Map();
// 按符号ID进行存储,以便快速查找和检测重复项。
private readonly rows =
new Map();
get size() {
return this.rows.size;
}
has(id: string) {
return this.rows.has(id);
}
register(
uri: vscode.Uri,
name: string,
kind: vscode.SymbolKind,
position: vscode.Position
): string {
// 根据文件路径和符号位置生成一个唯一的ID。
const id =
idOf(uri, position);
// 避免重复注册同一个符号。
if (this.rows.has(id)) {
return id;
}
const fileId =
uri.toString();
let file =
this.files.get(fileId);
// 如果文件还不存在,就创建一个新的文件条目。
if (!file) {
file = {
id: fileId,
label:
vscodeworkspace
.asRelativePath(uri),
file: uri.fsPath,
symbols: [],
};
this.files.set(
fileId,
file
);
}
// 将 VS Code 中定义的符号类型转换为图结构中更简洁的形式。
const row: SymbolRow = {
id,
name,
kind:
kind === vscode.SymbolKind.Method
? 'method'
: 'function',
line: position.line,
character:
position.character,
};
// 将这个符号存储到全局映射中,同时也会将其添加到对应的文件条目中。
this.rows.set(id, row);
file.symbols.push(row);
return id;
}
}现在,图结构构建工具就可以重复注册符号了,而不用担心会出现重复数据的问题。 8. 使用广度优先搜索遍历图结构
一次调用关系查询只能让我们了解图中的一层连接关系。而一个有用的代码图结构需要展示多层的关联关系。例如,A()调用了B(),但这并不能告诉我们B()接下来会调用哪些函数。
为了构建出一个有用的代码图结构,我们需要反复追踪这些调用关系,比如A → B → C → D。每次这样的查询都会使图的结构扩展一层,因此我们需要像广度优先搜索这样的遍历策略,才能高效地探索多层的连接关系。
举个例子:
// 假设这个图结构包含4层连接关系
A --> B --> C --> D --> E
如果我们从A开始遍历,并且指定遍历深度为3层,那么我们期望得到的结果应该是:
深度0: A
深度1: B
深度2: C
深度3: D
广度优先搜索是一种非常适合这种需求的方法,因为这个图结构本身就是按照调用层次来组织的。在遍历过程中,会始终保持一个“当前边界”节点:
当前边界节点
↓
发现相邻节点
↓
下一个边界节点
↓
发现相邻节点
其基本实现代码如下:
const walk = async (
start: Handle,
direction: 'incoming' | 'outgoing',
limit: number
) => {
// 从给定的节点开始,逐层遍历代码图结构。
let frontier: Handle[] = [start];
for (
let depth = 0;
depth < limit && frontier.length > 0;
depth++;
) {
// 同时处理多层的查询任务,但并发数量最多为6个。
const results =
await mapLimit(
frontier,
6,
handle =>
oneHop(
handle,
direction
)
);
const next: Handle[] = [];
frontier.forEach(
(handle, index) => {
for (
const other of results[index]
) {
// 在添加新的连接关系之前,先将其加入注册表中。
if (!registry.has(other.node.id)) {
registry.register(
other.node.uri,
other.node.name,
other.node.kind,
other.node.pos
);
}
// 保持图中调用关系的方向不变。
if (direction === 'outgoing') {
addEdge(handle.node.id, other.node.id);
} else {
addEdge(other.node.id, handle.node.id);
}
next.push(other);
}
}
);
// 从这一层发现的节点继续进行遍历。
frontier = next;
}
};
mapLimit这个辅助函数能够有效控制同时进行的语言服务器请求数量:
async function mapLimit(
items: T[],
limit: number,
fn: (item: T) => Promise,
): Promise {
// 同时最多执行 `limit` 个异步操作。
const results = new Array(items.length);
let next = 0;
// 创建一些工作线程,这些线程会共享下一个可处理的元素。
const workers = Array.from(
{
length: Math.min(limit, items.length),
},
async () => {
while (next < items.length) {
const index = next++;
results[index] = await fn(items[index]);
}
}
);
await Promise.all(workers);
return results;
}
关键的区别在于:BFS只涉及局部计算,而解析符号通常需要让VS Code的语言工具来执行实际的处理工作。
对于我们访问的每一个符号,Code Graph View可能都需要向语言服务查询其相关的调用信息。这些查询操作可能会涉及到解析源文件、解析符号以及与语言服务器进行通信。随着图结构的不断扩大,这类请求的数量也会随之增加。
因此,尽管遍历本身很简单,但如果这些查询操作是顺序执行的,那么整个过程的速度就会变得很慢。mapLimit函数通过允许多个独立的语言工具请求同时运行来解决这个问题,同时也对并发数量进行了限制,以防止语言服务被过度负担。
9. 处理循环结构
实际的代码结构并不是树形结构,而是图结构。因此,循环的存在是正常的。
例如:
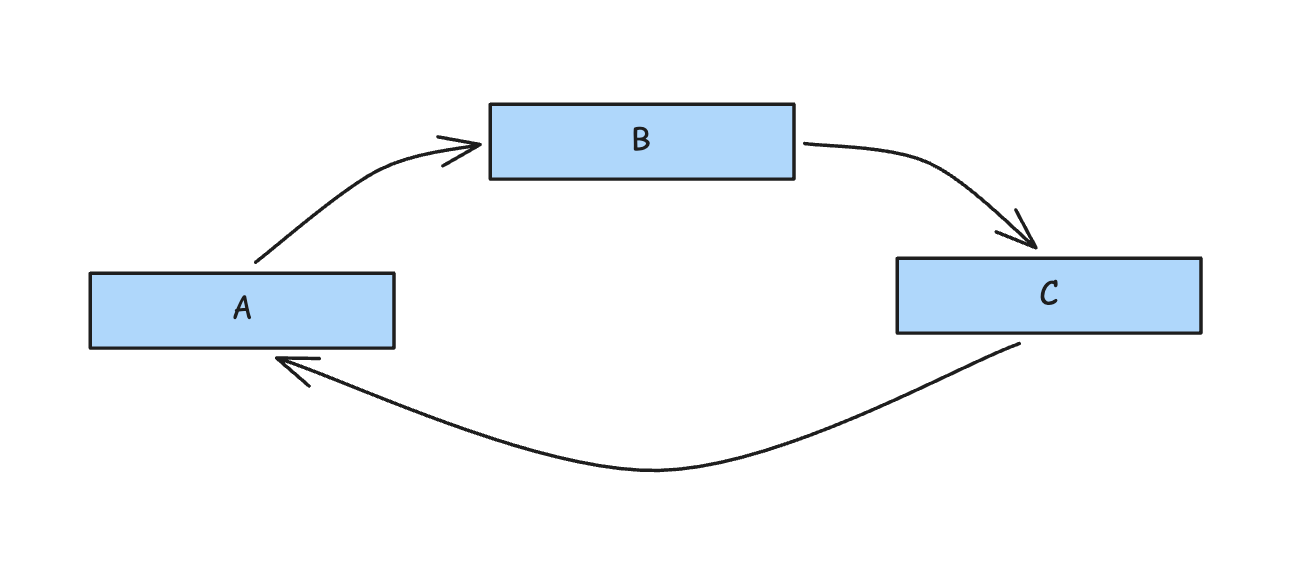
如果使用简单的递归遍历方式,那么这个过程可能会无限地进行下去。因此,我们需要记录已经访问过哪些节点。但这里有一个细节需要注意:仅仅使用Set结构来存储已访问过的节点是不够的,因为如果同一个节点可以从不同的深度被访问到,那么这种数据结构就无法准确反映这一情况。相反,我们应该记录在访问某个节点时还剩下多少层需要遍历。
Set
因此,我们可以使用Map结构来存储每个节点的剩余遍历深度:
const explored = new Map();
然后,我们可以这样编写代码来跟踪每个节点的剩余遍历深度:
// 记录访问某个节点时还剩下多少层需要遍历。
const key = `${direction}:${node.id}`;
if ((explored.get(key) ?? -1) < remainingDepth) {
// 只有当当前层的遍历能够探索到比之前更深的层次时,才重新访问该节点。
explored.set(key, remainingDepth);
next.push(node);
}
这样做的优点是:如果我们之前发现某个节点还需要再走一层才能到达,但后来发现实际上只需要走三层就可以到达,那么我们就可以再次访问这个节点。这种处理方式比简单地将节点标记为“已访问”要准确得多。
10. 限制图的规模
图的规模可能会迅速扩大。一个关联度很高的函数可能会拥有数十个调用者,而这些调用者各自也可能又有几十个其他调用者。因此,图构建工具应当设置明确的限制条件。
例如:
const MAX_SYMBOLS = 400;
const MAX_CALLS_PER.Symbol = 50;
const HOP_CONCURRENCY = 6;
如果图的规模超过了这些限制,我们不应该假装图已经完整构建完毕。相反,应该采取以下措施:
let truncated = false;
然后执行如下代码:
if (
registry.size >= MAX_SYMBOLS
) {
truncated = true;
continue;
}
这样,最终的GraphData就可以向用户界面提示:
此图已被截断。
这样做总比让代码库规模过大而导致扩展功能无法正常使用要好得多。
11. 过滤文件
语言服务器可能会返回一些与我们正在分析的应用程序无关的文件信息。这些文件可能是构建过程中产生的文件,或者是由于依赖关系安装或特定语言的构建/运行时操作而生成的输出文件。例如,一个TypeScript项目可能会包含以下路径:
node_modules
而一个Python项目则可能包含:
site-packages
在将这些文件添加到图中之前,我们可以先对它们进行过滤。
const DEPENDENCY_DIRS =
/\/(node_modules|vendor|target|\.venv|venv|site-packages|__pycache__|build|obj|\.dart_tool)\//;
function isWorkspaceFile(
uri: vscode.Uri
): boolean {
if (
uri.scheme !== 'file' ||
DEPENDENCY_DIRS.test(uri.path)
) {
return false;
}
return !!vscode/workspace
.getWorkspaceFolder(uri);
}
这样就能确保图只包含用户工作区中的文件信息。这也体现了语言智能与应用程序行为之间的重要区别:语言服务器告诉我们它能够解析哪些信息,而图的构建工具则负责决定哪些内容应该被纳入图中。
12. 为什么有些边会默默地消失
在规模庞大的图中,一些明明存在相互调用关系的函数最终可能会显示为没有连接关系,而且也不会有任何错误提示。问题的根源在于:CallHierarchyItem对象是与语言服务器的状态相关联的。如果该状态变得过时,那么查询其调用者或被调用者时可能会得到一个空数组。从图构建工具的角度来看,这种情况就相当于某个函数根本没有调用者。
在VS Code的实现中,调用关系信息只会为最近的一定数量的请求保留。我们的爬取程序也可以同时进行多次查询,因此在一些较旧的查询结果还在被处理的过程中,新的数据可能会覆盖它们。针对这个问题,图构建工具采用了三种解决方法。
1. 它存储的是普通数据,而非实时更新的信息。
每个功能都通过一个NodeRef来表示,其中包含了该功能的ID、URI、名称、类型以及位置信息。一步查询的结果也会被缓存为NodeRef形式。这样,在需要时,我们就能利用这些信息重新构建相应的调用关系结构。
interface NodeRef {
id: string;
uri: vscode Uri;
name: string;
kind: vscode.SymbolKind;
pos: vscode.Position;
}
2. 它会记录每个已准备好的数据项的创建时间。
每当有一个新的调用关系结构项被生成时,一个全局的epoch计数器就会增加。每个数据项都会记录下其创建时的时间戳。如果某个数据项已经变得过于陈旧,爬虫会从已缓存的NodeRef中重新生成一个新的数据项。
3. 它会重新尝试获取那些返回空结果的数据项。
oneHop函数的简化版本如下所示:
const SESSION_WINDOW = 7;
// 如果必要,会刷新过期的语言工具引用并重试一次。
for (let attempt = 0; attempt < 2; attempt++) {
const stale =
!current.item ||
epoch - current_epoch > SESSION_WINDOW;
if (stale) {
// 在使用过期的CallHierarchyItem之前,先重新解析相关符号。
const fresh = await prepareFresh(
current.node.uri,
current.node.pos
);
if (!fresh) {
return [];
}
current = fresh;
}
const items =
await lookup(
current.item!,
direction
);
// 如果获取到的结果为空,就将其标记为无效并重试一次。
if (
items.length === 0 && attempt === 0 && epoch - current_epoch > SESSION_WINDOW
) {
current = {
node: current.node,
epoch: -1,
};
continue;
}
// 将解析得到的关系信息缓存起来,以避免重复进行语言工具查询。
hopCache.set(key, {
nodes: items.map(refOf),
at: Date.now(),
});
return items.map(child => ({
node: refOf(child),
item: child,
epoch: current_epoch,
}));
}
在这里,lookup实际上是之前提到的vscode.provideIncomingCalls或vscode.provideOutgoingCalls命令的简写形式。至于具体的会话限制值,这属于VS Code的内部实现细节,并非扩展程序必须依赖的因素。因此,爬虫并不假定这种限制总是存在;SESSION_WINDOW这个数值只是为我们提供了一个用于刷新旧数据项的保守阈值而已。
这种方式可以减少信息丢失的情况,但仍然无法保证能够得到一个完整的关联图谱。语言工具仍有可能返回不完整的信息,或者无法解析某些关系。
这一原则其实适用于所有语言服务API:应该存储那些能够用来重新构建某个对象所需的信息,而不是对象本身。对于因数据过期而返回的空结果,应将其视为“未知状态”,而不能直接认为其确实不存在。
13. 将图表连接到Web视图
一旦图表生成完成,扩展程序就需要一个地方来显示它。VS Code的Web视图正是为此而设计的。
扩展程序会创建相应的面板:
const panel =
vscode.window.createWebviewPanel(
'codeGraphView',
'Code Graph',
vscode.ViewColumn.Beside,
{
enableScripts: true,
retainContextWhenHidden: true,
}
);
图表会以可序列化的数据形式被发送到Web视图:
panel.webview.postMessage({
command: 'graphData',
data: graphData,
});
然后Web视图就可以接收这些数据并进行显示:
window.addEventListener(
'message',
event => {
const message =
event.data;
if (
message-command !==
'graphData'
) {
return;
}
renderGraph(
message.data
);
}
);
至此,与语言服务器相关的工作就已经完成了。
我们原本将源代码转化为符号及其关联关系,然后再将其转换为GraphData格式。现在,可视化层就可以利用这些数据来生成图表了。
像ELK这样的工具也可以用来计算图表中各元素的位置,而不会影响到图表的生成逻辑。
14. 测试图表生成器
如果每次测试都需要运行VS Code实例并使用真实的语言服务器,那么测试这类扩展程序就会变得相当困难。一种更好的方法是将图表生成逻辑与VS Code本身分离出来。实际上,爬取器只需要执行以下几项操作即可:
prepareCallHierarchy
provideIncomingCalls
provideOutgoingCalls
我们可以为这些命令创建模拟实现。例如:
const sessions = new Map();
let sessionCounter = 0;
async function executeCommand(
command,
...args
) {
// 模拟VS Code在解析符号时创建会话的过程。
if (
command ===
'vscode.prepareCallHierarchy'
) {
const id =
'session-' +
++sessionCounter;
sessions.set(id, true);
return [
createFakeItem(
args,
id
),
];
}
// 模拟那些依赖于有效会话的调用操作。
if (
command ===
'vscode.provideIncomingCalls' ||
command ===
'vscode.provideOutgoingCalls'
) {
const item = args[0];
// 如果该调用属于已过期的会话,就返回空数组。
if (
!sessions.has(
item.sessionId
)
) {
return [];
}
return getFakeCalls(
item
);
}
}
这种模拟机制可以用来处理诸如会话过期之类的边缘情况。需要注意的是,如果这些模拟实现使用了特定的会话限制条件,那么这应该仅仅被视为一种测试模型,而不能自动被视为VS Code官方API的承诺或保证。
我们可以生成一个确定性的图表,然后将爬虫的输出与简单的参考广度优先搜索结果进行对比。
例如:
flowchart LR
A[A] --> B[B]
A --> C[C]
B --> D[D]
C --> D
D --> E[E]
参考实现能够识别出预期的边关系。而测试用爬虫则会针对这个虚假的语言服务进行运行;如果两种结果存在差异,那么测试就失败了。这种测试方法使我们能够在不完全依赖编辑器运行环境的情况下,来验证那些复杂的图表逻辑。
15. 代码图表的局限性
基于语言服务器的调用关系图确实很有用,但它并不能完全反映程序的执行过程。有些关系通过静态的调用层次结构分析是无法被识别出来的。
例如:
动态调度
反射机制
依赖注入
事件发射器
回调函数
运行时生成的代码
特定框架的行为特性
以这段代码为例:
eventEmitter.on(
'payment_completed',
handlePayment
);
开发者可以理解,这段代码在运行时创建了事件与handlePayment之间的关联关系;然而静态的调用关系图可能无法将这种关系表现为普通的函数调用。因此,图表的质量在很大程度上取决于语言服务器本身以及它所能识别的关系类型。
正因如此,我们应该把这类图表看作是一种语义上的近似表示,而不是一个完美的运行时模型。此外,不同的语言也会对图表的构建方式产生影响。
虽然图表生成工具本身可以保持与具体语言无关的特性,但不同的语言扩展可能会为文档符号和调用层次结构的处理提供不同程度的支持。
结论
构建代码图表并不需要从头开始编写编译器或实现解析器。VS Code已经通过其语言API提供了大量语义信息。
其核心流程如下:
文档 -> 文档符号 -> 调用层次结构 -> 图表节点与边关系 -> 广度优先搜索遍历 -> 图表数据 -> 可视化展示
最重要的工程决策并不在于如何绘制图表,而在于选择合适的图表模型、确保符号标识的稳定性、正确解析各种调用关系、控制遍历的深度和并发性、处理循环结构,以及认识到语言服务器的状态是会发生变化的。
一旦这些基础工作完成,可视化展示就成了一个独立的问题。正是这种分离性,使得这种架构能够在多个VS Code扩展中得到应用。
同样的图表模型最终还可以用于依赖关系分析、变更影响评估、架构视图展示、人工智能上下文选择等功能,从而帮助人们更有效地应对日益复杂的代码库。我根据这些资料制作了一个可正常使用的版本,访问地址为:https://github.com/otobongfp/code-graph-view。
我很期待看到大家能够利用这些图表创造出哪些有趣的东西,从而为软件工程的发展做出贡献。
相关文章
文章:你的下一位DSL开发者其实是一个语言模型
在这篇文章中,作者介绍了“类型化领域基础框架”这一方法——通过将特定领域的编程语言嵌入到主流的类型化语言体系中,从而有效减少大语言模型在这些领域产生的错误或幻觉现象。作者以kUML基准测试以及一个基于代码定义基础设施的实例为例,探讨了如何利用编译器的验证机制以及“生成-编译-修复”循环来提高模型生成的特定领域编程语言代码的可靠性。 作者:伊拉克利·贝奇瓦亚
阅读全文
演示主题:如何在多种语言支持的单一代码库中保持主代码线的整洁性与稳定性
Dhruva Juloori探讨了Uber是如何在那些每月要处理超过65,000次代码变更的庞大单仓库系统中保持构建流程的顺畅与高效运行的。他解释了SubmitQueue是如何利用二进制分析算法、冲突检测机制以及机器学习模型来预测构建过程的成败及执行所需时间。此外,Dhruva还提到了通过绕过那些较大的代码差异文件,Uber成功将持续集成系统的资源使用效率提高了53%,同时使代码合并请求的审批流程速度加快了37%。 作者:Dhruva Juloori
阅读全文
代理们在三周内重构了30万行代码,而业内人士则都在思考:这究竟证明了什么?
CodeScene发布了一项案例研究:在三周的时间里,这些编程机器人使用大约4,000美元的代币费用,重新编写了30万行C语言代码,其工作过程通过逐帧回放工具进行了验证。在这些过程中,这些机器人还建立了一套针对特定代码库的编程流程指南。不过,业内人士对这项研究的范围、评估指标,以及最终结果在多大程度上受到所使用工具的影响提出了质疑。 作者:Steef-Jan Wiggers
阅读全文
如何利用“政策即代码”与开放隐私框架来管理由人工智能生成的基础设施【完整手册】
现代模型在近100%的情况下都能生成语法正确的代码。Veracode在2026年发布的报告明确指出:“语法问题已经基本得到解决。” 这听起来像是一个里程碑,但实际上正是这个原因导致了当前存在的问题。 同一份报告测试了上百种模型,发现它们的平均安全通过率仅为56%,“与第一份报告中的55%几乎没有变化”;大约44%的代码生成任务会引入安全隐患。 功能正确性与安全性其实是两个不同的问题,而目前只有其中一个问题接近得到解决。 这个结果既不是个特例,也不是什么新鲜事。2022年,在IEEE安全与隐私会议上,纽约大学坦登分校的一个团队让GitHub Copilot在89种与安全相关的场景中运行,生成了1
阅读全文