
如何使用TypeScript从零开始构建一个AI代理程序
许多关于AI代理的教程都是从语言模型开始讲起,为它提供一些工具,然后让它运行循环直到产生答案。这样的做法确实足以展示这些工具的使用方法,但却没有回答那些有趣的工程学问题。 当某个工具出现故障时会发生什么?谁来验证这些操作的结果?是什么机制能防止代理无限期地运行、执行不安全的命令,或者耗尽其上下文信息?又如何在不依赖模型不可预测的响应的情况下测试这些功能呢? 这些职责都属于 代理框架 ——也就是位于语言模型与其所运行的环境之间的那层软件。 在本次教程中,我们将使用TypeScript来构建一个小型且与具体工具提供商无关的代理框架,并以编码代理作为示例进行讲解。我们会从基本的执行循环开始,逐步添加
许多关于AI代理的教程都是从语言模型开始讲起,为它提供一些工具,然后让它运行循环直到产生答案。这样的做法确实足以展示这些工具的使用方法,但却没有回答那些有趣的工程学问题。
当某个工具出现故障时会发生什么?谁来验证这些操作的结果?是什么机制能防止代理无限期地运行、执行不安全的命令,或者耗尽其上下文信息?又如何在不依赖模型不可预测的响应的情况下测试这些功能呢?
这些职责都属于代理框架——也就是位于语言模型与其所运行的环境之间的那层软件。
在本次教程中,我们将使用TypeScript来构建一个小型且与具体工具提供商无关的代理框架,并以编码代理作为示例进行讲解。我们会从基本的执行循环开始,逐步添加工具验证、工作区隔离、执行时间限制、上下文管理、可观测性功能以及确定性故障测试等功能。
我们将涵盖的内容
先决条件
熟悉TypeScript以及对AI代理有基本了解会很有帮助。我们将使用Node.js 24、TypeScript及其内置的测试工具,而且这些技术的依赖关系非常少。
完整的实现代码可以在配套仓库中找到:agent-harness-from-scratch。每个开发阶段都对应一个Git标签,因此你可以跟随项目的发展进程进行学习,而不需要从最终版本开始入手。
1. 构建基本代理循环
若要跟随示例进行操作,请先查看初始阶段的代码:
git clone https://github.com/gkoos/agent-harness-from-scratch.git
cd agent-harness-from-scratch
git switch --detach 01-model-loop
npm ci
npm run typecheck
npm test
npm run demo
“分离式检出”功能能让你直接进入当前讨论的代码版本,而不会影响到任何分支。当你需要进入下一个开发阶段时,只需切换到对应的Git标签即可。请确保你的系统中已经安装了Node.js 24和npm。
最重要的架构设计原则是:模型负责提出行动建议,而代理程序负责执行这些行动。当模型请求某个工具来执行某项任务时,它实际上并没有真正执行任何操作;它只是生成了一个包含工具名称及参数的结构化请求。代理程序需要解析这个请求,调用相应的功能模块,并将结果返回给模型。
这种交互过程如下图所示:
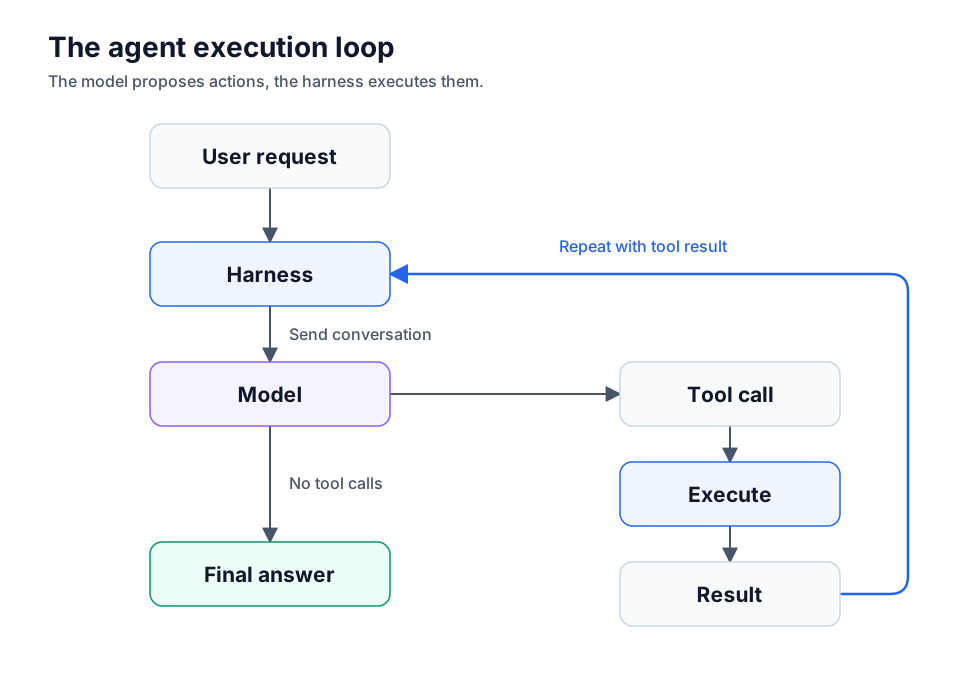
我们首先会在src/core/types.ts文件中定义相关类型。
export type ToolCall = { id: string; name: string; arguments: unknown };

export type Message =
  | { role: 'user'; content: string }
  | { role: 'assistant'; content: string; toolCalls?: ToolCall[] }
  | { role: 'tool'; callId: string; content: string; isError: boolean };

export interface ToolDefinition {
  name: string;
  description: string;
  parameters: Record>; // 用于模型的JSON结构定义
}

export interface Tool extends ToolDefinition {
  execute(argumentsValue: unknown, signal: AbortSignal): Promise;
}

export interface Model {
  generate(input: {
    messages: readonly Message[];
    tools: readonly ToolDefinition[];
    signal: AbortSignal;
  }) : Promise<{ content: string; toolCalls?: ToolCall[] }>;
}

export type AgentResult = {
  status: 'completed' | 'step_limit' | 'aborted';
  answer?: string;
  messages: Message[];
  steps: number;
};
Model接口刻意没有包含任何与OpenAI、Anthropic或其他任何提供商相关的特定内容。供应商适配器可以在不改变整个框架结构的情况下,将其API与这些类型的接口进行转换。
需要注意的是,工具参数被定义为未知类型,而不是任意类型。模型生成的数据属于不可信的输入信息,在下一节执行之前,我们需要对这些数据进行检查和验证。
src/core/agent.ts中定义的代理循环遵循以下简单的流程:
将对话内容以及可用的工具定义发送给模型。
将模型的响应添加到对话序列中。
如果模型请求使用某些工具,就执行这些工具并将它们的结果添加到对话中。
重复这个过程,直到模型给出最终答案,或者整个框架达到预定的步骤限制。
以下是src/core/agent.ts中完整的代理循环实现。模型接收工具定义,而整个执行框架则负责处理这些工具的具体实现逻辑:
import type { AgentResult, Message, Model, Tool } from './types.ts';

export async function runAgent(options: {
  model: Model;
  tools: readonly Tool[];
  prompt: string;
  maxSteps?: number;
  signal?: AbortSignal;
}): Promise<AgentResult>> {
  const { model, tools, prompt, maxSteps = 10 } = options;
  if (!Number.isSafeInteger(maxSteps) || maxSteps < 1) {
    throw new RangeError('maxSteps必须是一个正的安全整数');
  }
  const signal = options.signal ?? new AbortController().signal;
  const messages: Message[] = [{ role: 'user', content: prompt }];
  const registry = new Map(tools.map/tool => [tool.name, tool]));
  if (registry.size !== tools.length) throw new Error('存在重复的工具名称');
  const definitions = tools.map(({ name, description, parameters }) =>> ({ name, description, parameters };

  for (let step = 0; step < maxSteps; step++) {
    if (signal.aborted) return { status: 'aborted', messages, steps: step };
    let response;
    try {
      response = await model.generate({ messages: [...messages], tools: definitions, signal });
    } catch (error) {
      if (signal.aborted) return { status: 'aborted', messages, steps: step };
      throw error;
    }
    if (signal.aborted) return { status: 'aborted', messages, steps: step };
    const calls = response.toolCalls ?? [];
    messages.push({ role: 'assistant', content: response.content, ...(calls.length ? { toolCalls: calls } : {}) });
    if (!calls.length) return { status: 'completed', answer: response.content, messages, steps: step + 1 };

    for (const call of calls) {
      if (signal.aborted) return { status: 'aborted', messages, steps: step + 1 };
      const tool = registry.get(call.name);
      if (!tool) {
        messages.push({ role: 'tool', callId: call.id, content: `未知工具:${call.name}`, isError: true });
        continue;
      }
      try {
        const result = await tool.execute.callarguments, signal);
        if (signal.aborted) return { status: 'aborted', messages, steps: step + 1 };
        messages.push({ role: 'tool', callId: call.id, content: JSON.stringify(result) ?? 'null', isError: false });
      } catch (error) {
        if (signal.aborted) return { status: 'aborted', messages, steps: step + 1 };
        messages.push({
          role: 'tool', callId: call.id,
          content: error instanceof Error ? error.message : String(error),
          isError: true
        });
      }
    }
  }
  return { status: 'step_limit', messages, steps: maxSteps };
}
如果响应中不包含任何工具调用,那么该次执行流程就会结束;否则,系统会查找每个被请求的工具并执行它们。
工具出现故障并不会自动终止代理程序的运行。相反,系统会将错误信息与原始调用ID关联起来进行记录。这样,模型在下次执行时就能识别出文件缺失或操作失败等问题。
我们还对模型的执行次数设置了上限。虽然模型可以不断请求任务来执行,但它无法决定自己能够获得多少执行时间或进行多少次迭代。
无需真实模型的测试
在测试中,我们没有使用不可预测的API调用来消耗令牌或GPU资源,而是引入了一个脚本化的虚拟模型,该模型位于src/models/fake.ts文件中。这个虚拟模型会返回预定义的响应:首先是一个工具请求,然后是最终答案。
这个虚拟模型会按照预设的响应顺序依次执行各种操作。如果脚本执行完毕,就会触发错误,因此任何意外的额外执行步骤都不会被默默忽略:
// src/models/fake.ts
import type { Model } from '../core/types.ts';

export function scriptedModel(
  responses: Array<Awaited<ReturnType<Model['generate']>>>>
): Model {
  let index = 0;
  return {
    async generate() {
      const response = responses[index++];
      if (!response) throw new Error('Scripted model exhausted');
      return response;
    }
  };
}
以下是针对tests/agent.test.ts文件编写的最简单测试代码。使用npm test命令来运行它:
import { test } from 'node:test';
import assert from 'node:assert/strict';
import { runAgent } from '../src/core/agent.ts';
import { scriptedModel } from '../src/models/fake.ts';

test('执行工具并返回最终答案', async () => {
  const result = await runAgent({
    prompt: 'Say hello',
    tools: [
      {
        name: 'hello', description: 'Return a greeting',
        parameters: { type: 'object' },
        async execute() { return 'Hello'; }
      },
    ],
    model: scriptedModel([
      { content: '', toolCalls: [{ id: '1', name: 'hello', arguments: {} }] },
      { content: 'Done' }
    ])
  });
  assert.equal(result.status, 'completed');
  assert_equal(result.answer, 'Done');
  assert.deepEqual(result.messages[2], {
    role: 'tool', callId: '1', content: '"Hello"', isError: false
  });
});
配套演示代码也采用了相同的测试机制。此外,还有其他测试用例用于验证未知工具、执行步骤限制以及在没有API密钥、网络连接或令牌消耗的情况下如何进行操作。
目前,我们已经构建了一个可以正常运行的代理程序循环系统,但它仍然会信任模型生成的工具参数,而且对于已注册的工具能够执行哪些操作,也没有任何实质性的限制。2. 在执行工具调用之前对其进行验证
在最初的实现中,模型会通过名称来请求相应的工具,然后直接将参数传递给工具的实现函数。这种做法适用于演示用途,但需要注意的是,工具描述实际上只是向模型发出的一种请求,并不能保证模型会返回有效的参数。
关于这一部分的内容,请参考配套代码库中的第二个里程碑:
git switch --detach 02-tool-dispatch这个操作会添加src/core/registry.ts文件,该文件负责处理工具的注册以及运行时参数的验证工作;同时,它还会修改src/core/agent.ts文件中定义的错误处理机制。
具有明确契约规范的注册系统
ToolRegistry取代了最初实现中使用的简单Map》结构。它会拒绝无效或重复的工具名称,只暴露模型所需要的工具定义:
import type { Tool, ToolDefinition } from './types.ts';

export class ToolRegistry {
  private readonly tools = new Map;
  constructor(tools: readonly Tool[]) {
    for (const tool of tools) {
      if (!/^[a-zA-Z][a-zA-Z0-9_-]*$/.test.tool.name)) throw new Error(`无效的工具名称:${tool.name}`);
      if (this.tools.has/tool.name)) throw new Error(`重复的工具名称:${tool.name}`);
      this.tools.set-tool.name, tool);
    }
  }
  definitions(): ToolDefinition[] {
    return [...this.tools.values()).map(({ name, description, parameters }) => ({ name, description, parameters }));
  }
  get(name: string): Tool | undefined { return this.tools.get(name); }
}
可以通过const registry = new ToolRegistry(tools)创建这个注册系统,然后通过registry.definitions()获取模型所需的工具定义。当模型请求使用某个工具时,必须在调用execute方法之前验证所提供的参数:
const tool = registry.get(call.name);
if (!tool) {
  messages.push({
    role: 'tool', callId: call.id,
    content: `未知的工具:${call.name}`, isError: true
  });
  continue;
}

const validationErrors = validate(call.arguments, tool.parameters);
if (validationErrors.length) {
  messages.push({
    role: 'tool', callId: call.id,
    content: `参数无效:${validationErrors.join('; ')}`,
    isError: true
  });
  continue;
}
这是一个非常重要的环节。在框架进行验证之前,parameters这些参数是不可信的;如果验证失败,工具就不会被执行,模型也会收到与原始请求ID相关联的错误信息。
本教程中提供的validate函数仅支持一小部分JSON Schema规范:包括基本类型和容器类型的检查、对象属性的验证、必填字段的检测、以及“不允许添加额外属性”的规则。它还会报告诸如$.flags[0]这样的路径信息,以帮助识别格式错误的输入数据。需要注意的是,这个函数并非一个完整的JSON Schema实现,而且在工具注册时也不会对工具相关的规范进行验证。
下面是上面提到的验证器代码。它首先会检查所指定的类型,然后递归地检查对象属性和数组元素:
export function validate(value: unknown, schema: Record, path = '$'): string[] {
  const errors: string[] = [];
  const type = schema.type;
  if (typeof type !== 'string') return [`${path}: schema必须明确指定类型`];
  const matches = type === 'object' ? value !== null && typeof value === 'object' && !Array.isArray(value)
    : type === 'array' ? Array.isArray(value)
    : type === 'integer' ? typeof value === 'number' && Number.isInteger(value)
    : type === 'number' ? typeof value === 'number' && Number.isFinite(value)
    : type === 'null' ? value === null
    : type === 'string' || type === 'boolean' ? typeof value === type : false;
  if (!matches) return [`${path}: 预期值为${type}`];
  if (Array.isArray(schema.enum) && !schema(enum.some(item => Object.is(item, value))) {
    errors.push(`${path}: 这个值是不被允许的`);
  }
  if (type === 'object') {
    const obj = value as Record;
    const properties = (schema.properties ?? {}) as Record>;
    for (const key of (schema.required ?? []) as string[]) {
      if (!Object.hasOwn(obj, key)) errors.push(`${path}.${key}: 这个属性是必填的`);
    }
    for (const [key, item] of Object.entries(obj)) {
      if (Object.hasOwn(properties, key)) errors.push(...validate(item, properties[key], `${path}.${key}`));
      else if (schema.additionalProperties === false) errors.push(`${path}.${key}: 不存在这个属性`);
    }
  }
  if (type === 'array' && schema.items && typeof schemaitems === 'object') {
    (value as unknown[]).forEach((item, index) => {
      errors.push(...validate(
        item, schema.items as Record, `${path}[${index}]`
      ));
    });
  }
  return errors;
}
并非所有的错误都具有相同的含义
Milestone 2也明确区分了工具故障和模型故障这两种情况。
如果某个工具无法正常运行、传入的参数无效,或者工具本身抛出了异常,那么系统会生成一条类型为role: 'tool'且isError: true的错误信息。模型可以检测到这一错误,并在下次执行时尝试其他方法来继续处理任务。相反,如果是model.generate()本身出现了问题,那么整个系统就会以status: 'model_error'的状态终止运行,并记录下错误的详细信息。
这不仅仅是简单的记账工作。丢失的文件或许还可以被恢复,但如果模型提供者无法正常使用,那就根本无法获得任何模型响应来帮助进行恢复操作了。因此,这个工具系统不应该将这两种情况混为一谈。
在循环中现有的 `model.generate()` 异常处理代码块中,应该将原有的重新抛出异常的操作替换为结构化的数据返回方式,并且在 `AgentResult` 对象中添加 `'model_error'` 字段以及一个可选的 `error?: string` 字段:
if (signal.aborted) return { status: 'aborted', messages, steps: step };
return {
  status: 'model_error', messages, steps: step,
  error: error instanceof Error ? error.message : String(error)
};
工具执行过程中的异常处理代码块仍然会记录错误信息,但程序会继续执行循环。
这些确定性测试使这种区别变得显而易见。在 tests/agent.test.ts 中,如果传入的 `echo` 参数无效,系统会直接拒绝该请求,而不会真正执行相关工具;但如果工具在执行过程中抛出了异常,脚本化的模型仍然可以返回最终的结果。 tests/registry.test.ts 则用于检测参数验证是否正确以及是否存在意外的属性。
3. 为智能体提供工具,但不让它直接访问整个系统资源
到目前为止,我们的智能体可以请求使用各种工具,而这个工具系统也会验证这些请求所传递的参数是否合法。然而,仅仅验证参数的格式是否正确还不够——例如,一个用于读取 `../../secrets.txt` 的请求,虽然参数格式是正确的,但我们仍然应该拒绝它。
请查看配套代码库中的 里程碑 3:
git switch --detach 03-workspace-tools
这个里程碑为系统添加了 工作区相关工具 和 受限命令工具。这些工具都不依赖于特定的模型提供者。
将文件操作限制在工作区内进行
智能体需要能够读取和编辑文件,但它不应该被允许直接访问整个文件系统。在创建 `Workspace` 对象时,会为其指定一个标准的根目录:
const workspace = await Workspace.open('/path/to/project');
const tools = workspaceToolsworkspace);
之后生成的 read_file 和 write_file 工具会接受以该根目录为基准的相对路径作为输入。在打开文件之前,Workspace 会拒绝绝对路径、那些能够跳出根目录的路径,以及路径中包含符号链接的情况。进行写入操作时,必须确保父目录存在;此外,这个工具也不会随意创建新的目录结构。
Workspace中的这两种方法会强制执行路径检查。该模块从node:path中导入了isAbsolute、relative和resolve方法,而从node:fs/promises中导入了lstat和realpath方法。Workspace.open()会将await realpath(root)的结果存储为this.root:
private lexical(path: string): string {
    if (!path || isAbsolute(path)) throw new Error('期望提供一个相对的工作区路径');
    const full = resolve(this.root, path);
    const rel = relative(this.root, full);
    if (!rel || rel === '..' || rel.startsWith(`..${process.platform === 'win32' ? '\\' : '/'}`) || isAbsolute(rel)) {
      throw new Error('路径位于工作区之外,或者指向工作区的根目录');
    }
    return full;
  }

  /** 在所有组件中都会拒绝处理符号链接,而不仅仅是最终要被读取的文件。 */
  private async check(path: string, allowMissingFinal: boolean): Promise {
    const full = this.lexical(path);
    const rel = relative(this.root, full);
    const parts = rel.split(/[\\/]/);
    let current = this.root;
    for (let i = 0; i < parts.length; i++) {
      current = resolve(current, parts[i]!);
      try {
        const stat = await lstat(current);
        if (stat.isSymbolicLink()) throw new Error('不允许使用符号链接');
        if (i < parts.length - 1 && !stat.isDirectory()) throw new Error('父目录不是一个目录');
      } catch (error) {
        if (allowMissingFinal && i === parts.length - 1 && (error as NodeJS ErrnoException).code === 'ENOENT') break;
        throw error;
      }
    }
    return full;
  }
read方法在打开文件之前会调用this.check(path, false);而write方法则会调用this.check(path, true),这种方式只允许最终要被写入的文件缺失,但如果父目录缺失或存在符号链接,检查仍然会失败。
这种限制是由工具实现机制来强制执行的,而不是通过要求模型按照某种方式运行来实现的。虽然模型可以请求访问路径为../secret.txt的文件,但工作区会拒绝打开它。此时,测试系统会将这一错误记录为“可恢复的错误”,就像在Milestone 2阶段处理无效参数时所做的那样。
作为额外的安全措施,在支持的情况下,实现机制会在打开文件时使用O_NOFOLLOW选项,从而避免跟随路径中的符号链接。不过,这种做法并不能完全消除所有潜在的安全风险,因为目录成分在检查和处理过程中可能会发生变化。这种限制虽然有一定的教育意义,但它并非操作系统级别的沙箱机制。
让模型来选择命令,而不是由我们人为指定
执行命令时需要更加谨慎。我们不会接受模型生成的shell命令字符串,而是预先定义了一些命名的命令选项:
const tool = commandTool(projectRoot, {
  test: {
    executable: process.execPath,
    args: ['--test', 'tests/example.test.js']
  }
});
该模型可以发送请求 `{ "command": "test" }`,但它无法提供不同的可执行文件、额外的参数或shell命令语法。命令工具的执行流程如下(在其 `execute(value, signal)` 方法内部):
signal.throwIfAborted();
const name = (value as { command: string }).command;
if (!Object.hasOwn(presets, name)) throw new Error('不允许使用该命令');
const preset = presets[name]!;
const timeout = preset.timeoutMs ?? 10_000;
if (!Number.isSafeInteger(timeout) || timeout < 1) {
  throw new Error('超时时间无效');
}

// 在用于获取命令结果的Promise内部:
const child = spawn(preset.executable, [...preset.args], {
  cwd, shell: false, signal, windowsHide: true,
  stdio: ['ignore', 'pipe', 'pipe']
});
const timer = setTimeout(() => child.kill(), timeout);
这里,`spawn` 函数来自 `node:child_process` 模块,`cwd` 表示配置好的项目根目录,而 `presets` 则是开发者提供的配置映射。结果处理机制会收集标准输出和标准错误信息;如果其中任意一种字符串的长度超过了 65,536 个字符,就会终止相关进程,并取消 `timer` 的计时操作。在出现错误或进程关闭时,也会执行相应的清理操作。需要注意的是,这里的长度检测是基于JavaScript字符串的编码方式进行的,而不是实际的字节数。
虽然这样的限制减少了模型可选择的命令数量,但并不能确保这些命令绝对安全。测试脚本本身仍然可以读取文件、访问网络或启动其他进程;即使某个进程超时被终止,其整个进程树也不一定会随之结束。因此,对于不可信的代码资源,仍然需要采取进程隔离措施,比如使用配置良好的容器或操作系统沙箱环境。
里程碑3的测试用例涵盖了正常的读写操作、路径遍历尝试、符号链接的处理情况,以及那些会被拒绝执行的命令。
4. 对执行过程设置限制
现在的智能代理能够调用经过验证的工具,包括那些能够识别工作区结构的文件操作功能以及预定义的命令。但是,并非所有有效的操作都适合无限次地被重复执行。某个模型可能会发送数百次请求来使用这些工具,或者某个命令在执行过程中会长时间阻塞,导致代理无法及时得到结果。
在这个里程碑中,我们将执行次数限制明确规定为测试框架必须履行的责任,而不是要求模型自行遵守的规则。
请使用以下版本号来克隆代码库:
git switch --detach 04-execution-limits
如果您还没有克隆这个项目,请先执行 `git clone https://github.com/gkoos/agent-harness-from-scratch.git`,然后进入 `agent-harness-from-scratch` 目录。
分别统计进程迭代次数和工具调用次数
原本的 `maxSteps` 设置其实是用来限制模型发出的响应次数,而不是工具调用的总次数。因为一次响应可能涉及多次工具调用,所以仅仅限制响应次数并不能真正控制整个任务的工作量。
我们为runAgent添加了两个新的选项:
const result = await runAgent({
  model,
  tools,
  prompt: '检查该项目',
  maxSteps: 10,
  maxToolCalls: 30,
  timeoutMs: 15_000
});
每一次请求都会消耗工具调用预算,无论是使用未知的工具,还是传入无效参数的请求。这一点非常重要,因为即使请求失败,也会耗费系统资源。在循环开始之前,先将let toolCalls = 0初始化为0,然后在检查每个被允许的请求所使用的工具时,立即更新这个数值。这种处理方式同样适用于那些被拒绝的请求或使用了未知工具的情况。
模型也可能一次返回多个工具调用指令。系统不会先执行前几个指令,然后再发现预算已经用完,而是会直接判断整个批次是否在预算范围内:
if (calls.length > maxToolCalls - toolCalls) {
  return { status: 'tool_limit', messages, steps, toolCalls };
}
这种设计可以防止出现因预算不足而导致的部分执行情况。不过,这并不意味着整个批次操作一定是原子性的:某个工具仍然有可能失败,或者执行过程也可能在中途被取消。
传播取消信号与截止时间
调用者可以提供一个AbortSignal,而timeoutMs则设置了一个内部截止时间。系统会通过AbortController将这些因素结合起来,并将相应的信号传递给模型和各个工具。
这种设置取代了原始循环中直接使用的信号处理方式:
const controller = new AbortController();
let timedOut = false;
const onAbort = () => controller.abort(options.signal?.reason);
if (options.signal?.aborted) onAbort();
else options.signal?.addEventListener('abort', onAbort, { once: true });
const timer = timeoutMs === undefined ? undefined : setTimeout(() => {
  timedOut = true;
  controller.abort(new Error('代理程序的截止时间已到'));
}, timeoutMs);
const signal = controller.signal;
就像在原始循环中一样,将这个signal传递给model.generate()和tool.execute()方法。同时,需要用try/finally块来确保无论执行是否完成,都能及时释放定时器并清除监听器:
try {
  // 执行逻辑放在这里,会使用controller.signal。
} finally {
  if (timer !== undefined) clearTimeout(timer);
  options.signal?.removeEventListener('abort', onAbort);
}
在执行的各个关键节点上,需要检查signal.aborted的值,如果值为true,则将状态设置为‘timeout’;否则将状态设置为‘aborted’。结果中还会包含steps和toolCalls这些信息,这样调用者就能了解在程序终止之前实际完成了哪些操作。
这是一种协作式的取消机制,并非强制性的终止过程。如果某个适配器忽略了接收到的取消信号,那么相应的操作可能会超过截止时间才结束。同样地,终止一个子进程并不一定能让它的所有后代进程也停止运行。对于那些必须严格控制执行流程的场景,还是需要使用进程或容器隔离技术来确保系统的稳定性。
在不需要等待真正失败的情况下测试极限
预算测试利用脚本化模型来提交超出预算的请求,并验证没有任何工具会被执行。其他测试则用于检查无效请求是否会消耗预算、预终止信号能否有效阻止模型的调用,以及合作型模型和工具是否会在截止时间前停止运行。
types.ts中定义的结果类型现在包括了completed、step_limit、tool_limit、aborted、timeout和model_error。这些结果类型被设计成有所区分:一次运行过程可能在没有完成用户任务的情况下就正确地结束了。
git switch --detach 05-context
相关的文件位于src/core/context.ts、src/core/agent.ts以及tests/context.test.ts中。
新的context配置选项设置了两个独立的限制:
const result = await runAgent({
  prompt: '检查该项目',
  model,
  tools,
  context: {
    maxContextChars: 32_000,
    maxToolResultChars: 8_000
  }
});
maxToolResultChars这个限制确保了每个工具产生的结果在被纳入对话记录之前,其长度不会超过规定的上限。如果结果超过了这个限制,那么就会只保留结果的开始和结束部分,在中间添加一个省略标记;被舍弃的部分之后将无法被访问,甚至会在result.messages中也无法看到。
为了处理这种截断操作,代码中专门设计了一个辅助函数:boundToolResult,它会在结果字符串的前后分别保留规定的字符数,然后删除中间的多余部分:
export function boundToolResult(content: string, limit: number): string {
  if (content.length <= limit) return content;
  const marker = `\n...[${content.length - limit} or more characters omitted]...\n`;
  if (marker.length >= limit) return marker.slice(0, limit);
  const remaining = limit - marker.length;
  const front = Math.ceil(remaining / 2);
  const back = Math.floor(remaining / 2);
  return content.slice(0, front) + marker + (back ? content.slice(-back) : '');
}
在记录成功结果和错误信息时,请使用以下代码:content: boundToolResult(content, context.maxToolResultChars)。这种简洁的处理方式能够有效应对长度为零的情况,因此slice(-0)不会意外地保留全部结果。
maxContextChars用于限制传递给模型的序列化消息数组的长度。虽然该系统会在返回的对话记录中保留较旧的消息,但selectContext()只会发送初始的用户请求以及尽可能多的最新交互记录。未被包含在其中的历史信息,在当前交互环节中是无法被模型获取到的。
这里所指的是字符长度限制,而非令牌数量的限制。这些限制是针对JavaScript字符串在经过JSON序列化后的实际长度而言的,其中不包括工具定义内容以及特定提供者添加的额外数据。真正的提供者适配器需要能够考虑令牌的数量,并为响应结果预留足够的空间。
不要将工具调用与其结果分开处理
对对话记录进行筛选并删除最旧的消息并不那么简单。助手的回复可能会涉及多个工具,每个工具都通过一个唯一的调用ID来标识。如果只发送其中部分工具的结果,就会导致对话内容无效或产生误导。
因此,selectContext()会将助手发出的消息以及该批次中的所有结果视为一个不可分割的整体进行处理:要么全部包含在内,要么全部忽略。同时,该函数也会拒绝那些孤立存在的结果或不完整的批次,而不会生成不一致的对话上下文。
以下是来自src/core/context.ts的selectContext()函数的实现代码,其中使用了第1节中定义的Message类型。第一个循环用于验证并整理对话记录;第二个循环则会从后往前遍历所有批次,直到达到预定的字符长度限制:
import type { Message } from './types.ts';

const size = (messages: readonly Message[]) => JSON.stringify(messages).length;

export function selectContext(messages: readonly Message[], maxChars: number): Message[] {
  if (!Number.isSafeInteger(maxChars) || maxChars < 1) {
    throw new RangeError('maxContextChars必须是一个正的安全整数');
  }
  if (!messages.length) return [];
  const groups: Message[][] = [];
  for (let i = 0; i < messages.length;) {
    const message = messages[i]!;
    if (message.role === 'assistant' && message.toolCalls?.length > 0) {
      const ids = new Set(message/toolCalls.map(call => call.id));
      if (ids.size != message.toolCalls.length) throw new Error('助手环节中存在重复的工具调用ID');
      const group: Message[] = [message];
      i++;
      while (i < messages.length && messages[i].role === 'tool') {
        const result = messages[i]!;
        if (result.role === 'tool' && !ids.delete(result.callId)) throw new Error('存在孤立或重复的工具结果');
        group.push(result);
        i++;
      }
      if (ids.size == 0) throw new Error('工具结果批次不完整');
      groups.push(group);
    } else {
      if (message.role === 'tool') throw new Error('工具结果孤立存在');
      groups.push([message]);
      i++;
    }
  }
  const first = groups[0]!;
  if (first[0].role !== 'user') throw new Error('对话必须以用户消息开始');
  const recent: Message[][] = [];
  for (let i = groups.length - 1; i >= 1; i--) {
    const group = groups[i]!;
    const next = [...first, ...[group, ...recent].flat()];
    if (size(next) > maxChars) {
      if (recent.length === 0) throw new Error('当前对话上下文的字符长度限制不足以容纳最新的一条消息');
      break;
    }
    recent.unshift(group);
  }
  const selected = [...first, ...recent.flat()];
  if (size(selected) > maxChars) throw new Error('所需消息的总量超出了对话上下文的字符长度限制');
  return selected;
}
在每次调用模型之前,应使用selectContext(messages, context.maxContextChars)作为模型的messages输入参数。如果初始提示信息或最近需要的数据量超出了上下文的容量限制,选择器会抛出异常,此时测试框架会返回context_limit。这种处理属于执行层面的决策,并非工具本身出现的错误,模型也无法自行恢复。
确定性测试主要验证批量数据处理、孤立数据检测、输出截断以及模型相关功能的正确性。这些测试不仅确认上下文容量是否已减少,还会确保缩减后的上下文仍能完整地反映对话内容。接下来,我们将让这些执行过程中的决策结果变得可见。
6. 使代理的执行过程可见
一个代理在执行任务的过程中可能会做出一些意料之外的操作:例如重试失败的请求、进行不必要的模型调用,或者将大部分时间消耗在某个特定的工具上。仅凭最终的结果我们无法了解其中的具体情况。因此,我们需要记录执行过程中的各种事件,但同时不能让整个测试框架变成一个单纯的日志记录系统。
请查看配套仓库中的这一里程碑内容:
git switch --detach 06-observability
相关实现代码位于src/core/events.ts文件中,而集成逻辑则在src/core/agent.ts文件中。
在执行边界处触发事件
我们在runAgent方法中添加了一个可选的onEvent回调函数。测试框架会在模型被调用时发出model_start和model_end事件,在工具被调度时发出tool_start和tool_end事件;当模型操作失败时,会触发model_error事件;而当整个执行过程结束时,则会发出run_end事件。
每个事件都会包含运行ID、递增的序列号以及时间戳。模型和工具的完成事件还会报告其执行所花费的时间,这些时间是通过单调计时器来测量的。这些信息足以帮助我们重建操作顺序,并识别出那些执行速度较慢的操作。
const events: AgentEvent[] = [];

const result = await runAgent({
  prompt: 'Inspect the project',
  model,
  tools,
  onEvent: event => events.push(event),
});

console.log(result.runId, events);
请从src/core/events.ts文件中导入AgentEvent类型。这个回调函数是可选的:那些不需要监控执行过程的代码可以省略它。
有一个需要注意的地方:监控功能绝不能干扰执行的正常进行。事件监听器中的异常不应该导致原本成功的操作失败。事件发射器会捕获这些异常,并可以通过onObserverError函数选择性地报告它们,不过这个处理机制中的错误也会被忽略掉。需要注意的是,回调函数是同步执行的,因此那些执行速度较慢的监听器仍然会延缓整个代理程序的执行速度。
发射器会使用`node:crypto`中的`randomUUID()`方法生成一个`runId`,并将`sequence`的值初始化为0。它的`emit(event)`方法会丰富事件数据,并将相关的回调函数分离出来:
const enriched = {
  ...event, runId, sequence: ++sequence,
  timestamp: new Date().toISOString()
};
try {
  options.onEvent?.(enriched);
} catch (error) {
  try { options.onObserverError?.(error); }
  catch { /* 观察器失败不会影响运行结果。 */
}
在模型或工具的边界处,在执行之前记录`const start = performance.now()`,在执行之后再记录`durationMs: performance.now() - start`。一个共享的`finish()`辅助函数会在返回每个终端结果之前发送`run_end`信号,因此即使程序提前结束,这些数据也能被正确记录下来。
在没有重新设计模型的情况下记录其使用情况
我们还可以在模型响应中添加由提供者报告的令牌使用情况:
return {
  content: '完成',
  usage: { inputTokens: 125, outputTokens: 20 },
};

该系统会将报告的令牌使用数量存储在`result.usage`字段中,同时还会记录`modelCallsWithUsage`的数量。后者这个字段非常重要:如果报告的令牌数量为0,且调用次数也为0,那就意味着**使用情况未知**,而不是表示运行是免费的。任何无效的数据都会被拒绝,而不会悄悄地影响最终的统计结果。
该系统会使用输入和输出的令牌数量,并验证这些单独的值以及它们计算出的总和是否合法:
export type Usage = { inputTokens?: number; outputTokens?: number };
export type UsageTotals = {
  inputTokens: number; outputTokens: number; modelCallsWithUsage: number
};

export function addUsage(totals: UsageTotals, usage: Usage | undefined): void {
  if (!usage) return;
  for (const value of [usage.inputTokens, usage.outputTokens]) {
    if (value !== undefined && (!Number.isSafeInteger(value) || value < 0)) {
      throw new RangeError('模型使用数量必须是非负的安全整数');
    }
  }
  if (!Number.isSafeInteger(totals.inputTokens + (usage.inputTokens ?? 0))) ||
      !Number.isSafeInteger(totals.outputTokens + (usage.outputTokens ?? 0))) {
    throw new RangeError('累计的模型使用数量超出了安全整数的范围');
  }
  totals.inputTokens += usage.input Tokens ?? 0;
  totals.outputTokens += usage.outputTokens ?? 0;
  totals.modelCallsWithUsage++;
}

在运行开始时,将`totals`的值初始化为0。在模型响应的结构中添加`usage?: Usage`字段,在验证每个响应后调用`addUsage(totals, response.usage)`,并将`totals`的副本包含在最终结果中。如果缺少使用数据,计数器的值就不会发生变化。
事件的数据结构中故意没有包含提示信息、工具参数以及工具运行结果。错误字符串中可能仍然包含敏感数据,因此在导出这些数据时需要格外小心。这种机制属于轻量级的、内存中的监控系统,并不是分布式追踪系统,也不是永久性的审计日志。tests/events.test.ts中的测试用于验证事件的顺序、相关性、使用情况记录、观察者的隔离性以及终端事件的处理方式。
7. 不仅要测试正常路径,还要测试失败路径
我们的测试框架现在具备了工具验证功能、执行时间限制机制、上下文管理功能以及观测能力。但这些功能是相互关联的——某个模型可能会返回格式错误的工具调用信息;在批量处理过程中可能会突然发生取消操作;或者被拒绝处理的批次可能会导致系统状态变得无法恢复到可被模型接收的状态。最后的测试阶段会直接验证这些边界条件。
请查看配套代码仓库中的最终测试阶段内容:
git switch --detach 07-testing

新的测试代码位于tests/failures.test.ts文件中。这些测试使用的模型与第一个测试阶段使用的模型相同,因此即使没有API密钥,也能重现各种失败情况。
在信任模型返回的结果之前,先对其进行验证
仅仅验证工具输入参数是远远不够的。模型适配器也可能返回格式错误的响应信息——比如缺少content字段、toolCalls不是数组类型、参数缺失,或者调用ID重复等等。新的validateModelResponse()函数会在测试框架记录响应内容或执行任何操作之前,先检查响应数据的格式是否正确。
import type { Model, ToolCall } from './types.ts';

/**
* 在接受模型返回的结果或执行任何后续操作之前,先验证其格式是否正确。
*/
export function validateModelResponse(value: unknown): asserts value is Awaited>&>> {
  if (value === null || typeof value !== 'object' || Array.isArray(value)) {
    throw new TypeError('模型返回的结果必须是一个对象');
  }
  const response = value as Record;
  if (typeof response.content !== 'string') throw new TypeError('模型返回的内容必须是字符串类型');
  if (response/toolCalls === undefined) return;
  if (!Array.isArray(response.toolCalls)) throw new TypeError('模型中的工具调用信息必须是一个数组');
  const ids = new Set();
  for (const call of response-toolCalls as unknown[]) {
    if (call === null || typeof call !== 'object' || Array.isArray(call)) {
      throw new TypeError('工具调用信息必须是一个对象');
    }
    const item = call as Partial;
    if (typeof item.id !== 'string' || !item.id.trim()) throw new TypeError('工具调用的ID必须是非空字符串');
    if (typeof item.name !== 'string' || !item.name.trim()) {
      throw new TypeError('工具调用的名称必须是非空字符串');
    }
    if (!Object.hasOwn(item, 'arguments')) throw new TypeError('工具调用所需的参数缺失');
    if (ids.has(item.id)) throw new TypeError(`重复的工具调用ID:${item.id}`);
    ids.add(item.id);
  }
}
在`model.generate()`之后,立即在`try`块中调用`validateModelResponse(response)`,然后再调用`addUsage(usage, response.usage)`。在添加助手消息或运行工具之前执行这些操作。如果其中任何一步出现错误,就抛出`model_error`异常,并返回`finish('model_error', { error: message })`,其中`message`是异常的具体信息。
对于格式错误的响应,系统会以`model_error`异常终止处理流程,且不会对工具本身产生任何副作用。这与使用无效参数但调用过程本身合法的工具不同:后一种情况属于可恢复的错误,模型可以尝试再次执行相应的操作。
将被拒绝的批次排除在转录记录之外
测试还发现了一个与系统集成相关的漏洞。之前,系统会在检查某个批次是否超过了`maxToolCalls`的限制之前,就先向转录记录中添加包含工具调用信息的助手消息。因此,当该批次被拒绝时,那些未被执行的工具调用信息就会残留在转录记录中。
这个问题的解决方法虽然很简单,但却非常重要:**在记录助手的对话内容之前,必须先检查预算是否超标**。
if (calls.length > maxToolCalls - toolCalls) {
  return finish('tool_limit');
}
messages.push({
  role: 'assistant',
  content: response.content,
  ...(calls.length ? { toolCalls: calls } :{})
});

这样的处理方式能够确保在拒绝某个批次时,相关的工具调用信息不会被记录下来。如果在已经开始执行的批次过程中取消操作,仍然可能会导致转录记录不完整,此时需要重新进行测试才能得到正确的结果。
使用可复现的测试方案
除了针对格式错误响应、取消操作以及观察者组件故障进行的专门测试外,我们还会运行**150种具有不同批次规模和预算设置的工具测试场景**。通过使用固定的伪随机种子值,每次测试都能生成相同的测试序列,从而确保各种故障现象能够被准确复现。
以下示例代码位于`tests/failures.test.ts`文件中。这些示例代码都使用了同一个无实际功能的工具函数,以及一个用于生成格式正确的工具调用请求的辅助函数:
import { test } from 'node:test';
import assert from 'node:assert/strict';
import { runAgent } from '../src/core/agent.ts';
import { scriptedModel } from '../src/models/fake.ts';
import type { Tool } from '../src/core/types.ts';

const noop: Tool = {
  name: 'noop', description: '返回一个固定的结果',
  parameters: { type: 'object' },
  async execute() { return 'ok'; }
};
const call = (id: string) => ({ id, name: 'noop', arguments: {} });

第一个测试案例会改变预算数值(范围为0到8)和批次规模(范围为0到12),然后检查各种执行细节,包括实际执行的工具调用次数、任务终止状态,以及被拒绝的请求是否真的没有被记录在转录结果中:
test('seeded batches respect tool budgets', async () => {
  let seed = 0x12345678;
  const next = () => {
    seed ^= seed << 13;
    seed ^= seed >>> 17;
    seed ^= seed << 5;
    return seed >>> 0;
  };

  for (let i = 0; i < 150; i++) {
    const limit = next() % 9;
    const batch = next() % 13;
    let executed = 0;
    const result = await runAgent({
      prompt: 'test', maxToolCalls: limit,
      tools: [
        ...noop,
        async execute() { executed++; return 'ok'; }
      ],
      model: scriptedModel([
        {
          content: '',
          toolCalls: Array.from({ length: batch }, (_, j) => call(`call-${j}`))
        },
        { content: 'done' }
      ])
    });

    const admitted = batch <= limit;
    assert.equal(executed, admitted ? batch : 0, `case ${i}`);
    assert_equal(result.toolCalls, admitted ? batch : 0, `case ${i}`);
    assert.equal(
      result.status, admitted ? 'completed' : 'tool_limit', `case ${i}`
    );
    if (!admitted) {
      assert.deepEqual(result.messages, [{ role: 'user', content: 'test' }]);
    }
  }
});
被允许执行的批次会运行所有请求的工具,而超出预算的批次则不会运行任何工具。case标签用于标识哪些测试用例出现了故障,而固定的随机数种子则使我们能够重现这些故障。
接下来还会进行60次测试,以确认工具异常是否仍然属于可恢复的错误。这些测试会重复相同的故障路径,但会显示不同的错误信息;它们并不使用随机生成的变量来进行测试:
test('工具异常是否仍然属于可恢复的错误', async () => {
  let executed = 0;
  for (let i = 0; i < 60; i++) {
    const result = await runAgent({
      prompt: 'test',
      tools: [
        { ...noop, async execute() => executed++; throw new Error(`failure ${i}`) },
      ],
      model: scriptedModel([
        { content: '', toolCalls: [call('1')] },
        { content: 'recovered' }
      ])
    });
    assert.equal(result.status, 'completed');
    assert_equal(result.answer, 'recovered');
    assert.ok(result.messages.some(message => {
      message.role === 'tool' && message.isError && message.content === `failure ${i}`;
    }));
  }
  assert.equal(executed, 60);
});

那些使用随机数种子生成的测试用例属于属性检查类型,而异常测试则会反复验证特定的故障恢复路径。这两种方法都无法证明系统的正确性,也无法替代操作系统的沙箱环境,但它们都不需要依赖真实的模型即可运行,并且能够为我们提供关于该测试框架行为的可重复的验证结果。
我们现在已经将这个测试框架从最初简单的模型/工具循环结构发展成了一个具备验证功能、权限控制机制、限制设置、上下文管理以及遥测功能的执行层。虽然模型仍然会提出相应的操作建议,但最终决定什么动作会被实际执行的还是这个测试框架。
可以使用npm test来运行这些示例。代码仓库中还包含了针对上述讨论过的边界情况的额外测试用例,以及所有完整的实现代码。
下一步行动:连接真实的语言模型
在整个教程中,我们使用的都是脚本化的模型,而不是真正的语言模型。这样做的目的是为了便于测试:由于这些模型的响应结果是确定性的,因此我们可以在不依赖网络请求、API密钥或模型行为的不可预测性的情况下,来测试整个测试框架,包括其中的故障路径。
不过,《Model》接口的设计初衷就是为了让不同的服务提供商能够被互换使用。无论是连接OpenAI、Anthropic还是其他服务提供商,都不需要重新编写代理代码。我们只需要一个适配器,用来将相应服务提供商的API与我们现有的数据结构进行转换即可。
例如,使用OpenAI的Responses API编写的适配器可能如下所示:
// src/models/openai.ts
import OpenAI from 'openai';
import type { Model } from '../core/types.ts';

export function openAIModel(client: OpenAI): Model {
  return {
    async generate({ messages, tools, signal }) {
      const response = await client.responses.create(
        {
          model: 'YOUR_MODEL',
          input: toOpenAIInput(messages),
          tools: toOpenAITools(tools),
        },
        { signal }
      );

      return {
        content: extractText(response),
        toolCalls: extractToolCalls(response),
        usage: extractUsage(response),
      };
    },
  };
}
这只是一个架构设计草图,并不是一个完整的适配器。该适配器会将我们的消息及工具定义转换成提供方的格式,然后对提供的响应进行规范化处理。具体来说,它必须保留工具调用ID,解析工具参数,并确保在后续请求中能够将工具结果与相应的调用对应起来。
此外,该适配器还会转发框架中的AbortSignal信号,从而使取消操作能够传递到API请求中。当提供方出现错误时,这些错误会以异常的形式被处理,而框架本身已经将这些异常视为model_error结果进行应对了。
一旦适配器实现了Model接口,系统的其他部分就不会发生任何变化。无论是由哪个提供方生成响应,相同的工具注册机制、参数验证流程、执行资源管理方案、上下文管理机制以及可观测性功能都会保持不变。
还有一些值得进一步探索的改进方向:针对特定提供方的令牌管理机制、API重试与速率限制处理功能、持久化的对话历史记录记录方式,以及为运行不可信代码而设计的更强大的进程隔离机制。这些虽然都属于复杂的工程问题,但它们仍然属于我们已设定的架构框架范围内,并不需要采用完全不同的设计方案。
完整的实现代码可以在07-testing版本中找到。
我们所构建的不仅仅是一个能够向模型发送提示并执行函数的系统,更重要的是,我们建立了一套机制来决定“哪些操作是允许执行的、可以完成多少工作量、模型会接收什么样的上下文信息,以及如何处理和观察各种错误情况”。
这就是带有工具的语言模型与真正的智能代理系统之间的本质区别所在。
相关文章
如何让你的编程工具在浏览器中检测其运行效果
我受够了让编程机器人告诉我“前端工作已经完成”,但实际上根本没有人真正打开过前端界面来测试这些更改。 你们应该都见过这样的情景:机器人修改了一些代码,运行了格式化工具、类型检查工具和测试程序,所有结果都是正常的,然后它就会显示“已实现并验证通过”之类的信息。 但究竟是怎么验证的呢?通过测试确实能说明代码没有问题,但这并不等同于真正打开应用程序来使用那些刚刚被修改过的功能。 我遇到过很多这样的情况:代码本身没有问题,测试也通过了,但用户界面仍然存在一些明显的问题——比如某个控件与其他元素重叠了,某个选中的状态在数据存储中是存在的,但在屏幕上却没有高亮显示,某些操作在某种路径下可以正常执行,在另一
阅读全文
如何在实际地图上构建灾难模拟场景:利用 Mapbox GL JS 和 Three.js 技术实现动画效果的画布层以及可坍塌的 3D 建筑模型
在某些情况下,地图项目所需要的不仅仅是标记和多边形。你希望地图上能够出现一些动态效果:水沿着街道流动、烟雾随风飘散,或者冲击波从某个点扩散开来。 我第一次尝试实现这些效果时,做了我觉得理所当然的事情——我在地图上方添加了一个 元素,然后在上面绘制动画效果。 但结果看起来很不对劲,无论我怎么调整也无法改善这个问题。那些动画效果边缘分明,而且似乎“漂浮”在地面之上;每当我想倾斜或旋转地图时,这些动画就会与下方的地图内容对不上位。 我在开发 HazardSim 这个浏览器模拟器时遇到了这个问题。在这个模拟器中,自然灾害会在真实的地图上发生。海啸场景经历了大约十几次的修改,才终于不再看起来像是一张被贴
阅读全文
如何利用MCP让AI代理安全地访问内部API
我们的值班团队使用了一个小型内部笔记API。与之配套的网页应用可以显示当前谁正在负责处理紧急事务、哪些日期被安排为部署禁用期,以及运行脚本的位置。该团队中的一位开发人员希望能够在不打开网页应用的情况下,通过类似“Cursor”这样的工具进行搜索。 他们按照大多数人在周五下午会采取的方式设置了这个系统:将API的基本URL复制到助手设置中,将从共享操作库中获取的长期有效令牌粘贴到笔记本电脑的环境变量中,然后在助手的使用说明中添加了一条提示:“仅用于读取笔记内容,不得进行任何修改。” 在他们的机器上,这个系统确实能够正常工作。当他们询问下一次部署禁用期是什么时候时,助手会调用相应的搜索接口,从而返
阅读全文
演讲主题:25万亿枚代币究竟揭示了什么?这些数据能帮助我们了解开发者们实际上是如何运用人工智能代理技术的。
Brendan O’Leary探讨了现实世界中人工智能的普及程度实际上取决于人们是否能够建立起对相关技术的信任,而非仅仅追求各种模型评估指标。他利用多达40万亿条使用数据,详细解释了人工智能普及过程中的四个关键阶段,并分析了在信息构建、多模型协同处理以及反馈机制等方面可能出现的故障点,这些分析有助于工程领域的领导者成功推进基于人工智能的工作流程的规模化应用。 作者:Brendan O’Leary
阅读全文