
如何使用Python制作系统设计图
制作系统架构设计图是技术文档中非常重要的一部分。随着系统复杂性的增加,团队内部的信息清晰度就变得更加重要了。 但是,使用类似画布的工具从零开始绘制图表并不总是高效的。 幸运的是,还有一种替代方法,那就是采用“将图表视为代码”这种方式来创建图表。在这种方法中,你需要使用预定义的语法来描述图表的各个组成部分,而不是直接进行绘图操作。 目录 将图表视为代码的优势 先决条件与安装方法 什么是图表? 你的第一个图表 如何连接节点与数据流 数据流的分类与整理 集群概念 边与连接关系 总结 将图表视为代码的优势: 变更内容可以通过版本控制进行追踪。 由于无需从零开始绘制,也不需要手动调整格式,因此能够节省时
制作系统架构设计图是技术文档中非常重要的一部分。随着系统复杂性的增加,团队内部的信息清晰度就变得更加重要了。
但是,使用类似画布的工具从零开始绘制图表并不总是高效的。
幸运的是,还有一种替代方法,那就是采用“将图表视为代码”这种方式来创建图表。在这种方法中,你需要使用预定义的语法来描述图表的各个组成部分,而不是直接进行绘图操作。
目录
将图表视为代码的优势:
变更内容可以通过版本控制进行追踪。
由于无需从零开始绘制,也不需要手动调整格式,因此能够节省时间。
大多数采用“将图表视为代码”技术的工具都支持数据库、存储桶、负载均衡器等常见的技术图标。
在持续集成/持续交付流程中,或者通过编写代码来生成文档时,都可以自动创建图表。
先决条件与安装方法
在本教程中,你将学习如何使用Python的Diagrams库来绘制图表。基本需要的先决条件包括:
Python 3.7或更高版本
用于安装Python包的pip
你的操作系统上已经安装了Graphviz,以便生成图表输出图像
- 还需要安装以下Python包:
pip install diagrams - 需要一个终端环境,以便运行如下命令:
python diagram.py
什么是图表?
Diagrams是一个Python库,它允许你用Python代码来绘制云系统架构图。该库支持Azure、GCP、AWS等多种云服务提供商。
学习完本教程后,你将能够理解这个图表是如何制作出来的:
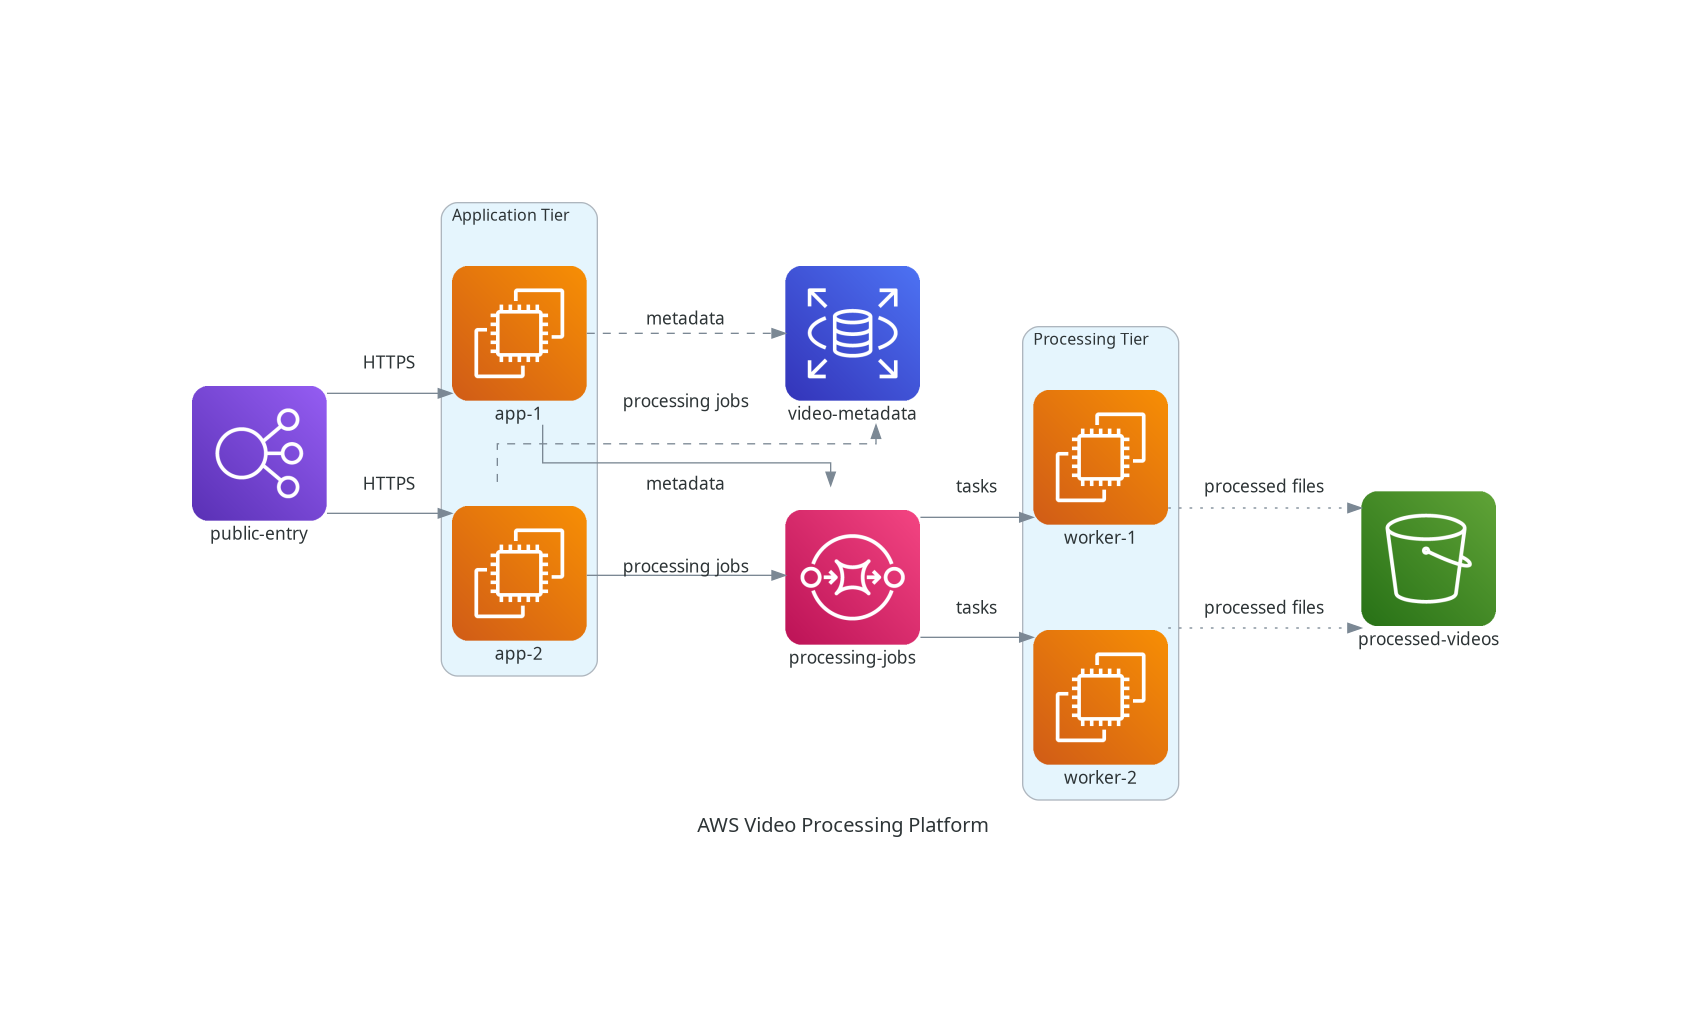
你的第一个图表
首先,确保你的配置已经满足所有先决条件。然后创建一个扩展名为.py的Python文件,并将以下代码添加到其中:
from diagrams import Diagram
from diagrams.aws.compute import EC2

with Diagram("Practice Architecture"):
    EC2("api-server")
让我们逐行了解这段代码的含义。
首先,我们导入了Diagram类:
from diagrams import Diagram
可以把Diagram想象成一块空白的画布,你在上面绘制的所有内容都属于这个画布。Diagram代表整个图示的结构框架。
接下来我们导入了一种节点类型。节点代表着你的架构中的某个组成部分。例如,ECS、Lambda函数、Service以及防火墙都属于资源类型。
from diagrams.aws.compute import EC2
一个节点对象由三部分组成:提供者、资源类型以及名称。在上面的例子中,EC2是一种属于compute资源类型的节点,而这种节点是由aws提供者提供的。
这段代码表示从AWS的计算服务组中导入EC2节点类型。我们将使用这个类来创建EC2节点。
diagrams.aws.compute就是导入路径,它指明了EC2节点对应的文件位置。
diagrams
└── aws
    └── compute
        └── EC2
你可以访问这里,了解更多关于不同提供者的官方节点类型信息。
假设你想在图示中使用AWS提供的Analytics组件,首先你需要从上面列出的节点类型中找到Analytics。你的导入语句应该写成from diagrams.aws.analytics import Analytics。
然后使用with Diagram创建图示结构:
with Diagram("Practice Architecture"):
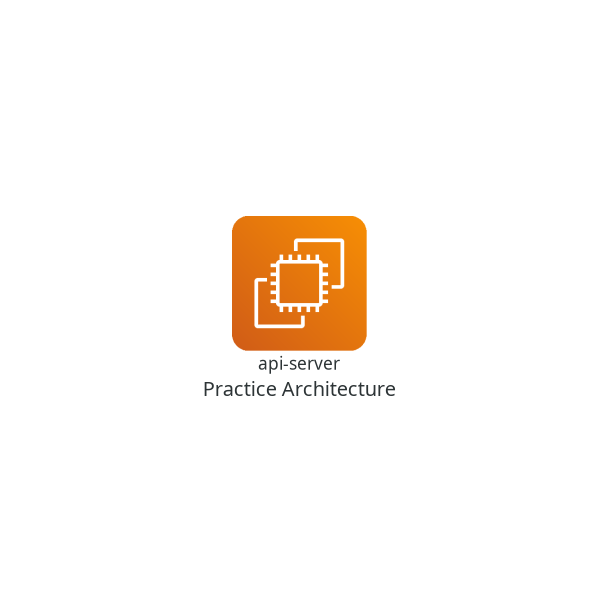
回到上面的例子,这段代码会创建一个名为Practice Architecture的图示。所有在with Diagram括号内定义的内容都属于这个图示。
现在我们来创建一个节点:
EC2("api-server")
这样就会创建一个标签为api-server的EC2节点。
最后,运行这段代码。如果你将Python文件保存为test.py,就可以使用python test.py来执行它。Diagrams会自动在当前文件夹中生成图像文件:
简而言之,整个流程如下:
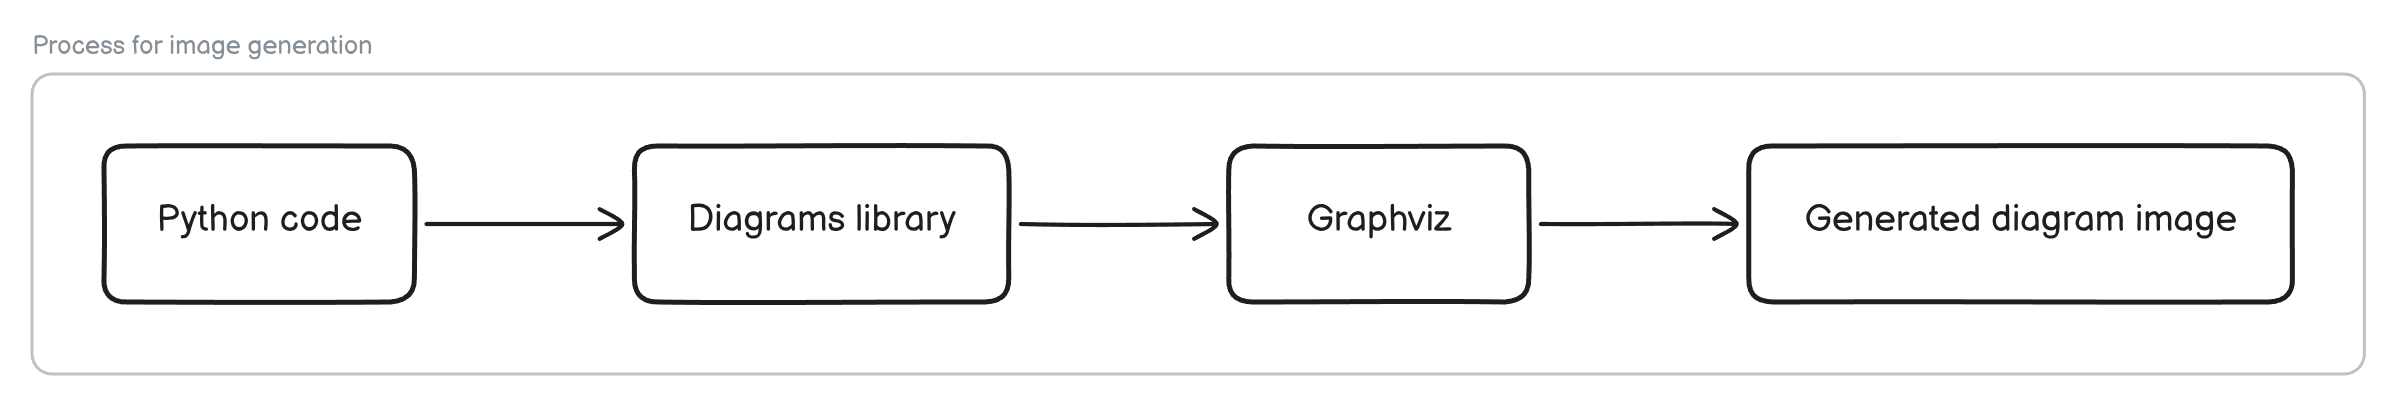
EC2("api-server")`, Diagrams 会负责处理后续的渲染工作。from diagrams import Diagram
from diagrams.aws.compute import EC2
with Diagram("Practice Architecture"):
EC2("api-server")
EC2("worker")
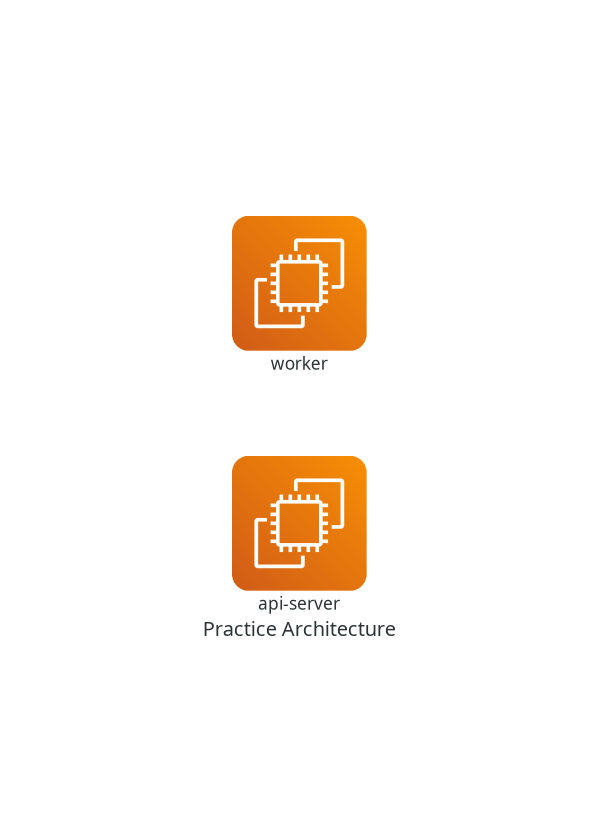
from diagrams import Diagram
from diagrams.aws.compute import EC2

with Diagram("Practice Architecture"):
    api_server = EC2("api-server")
    worker = EC2("worker")
如何连接节点与数据流
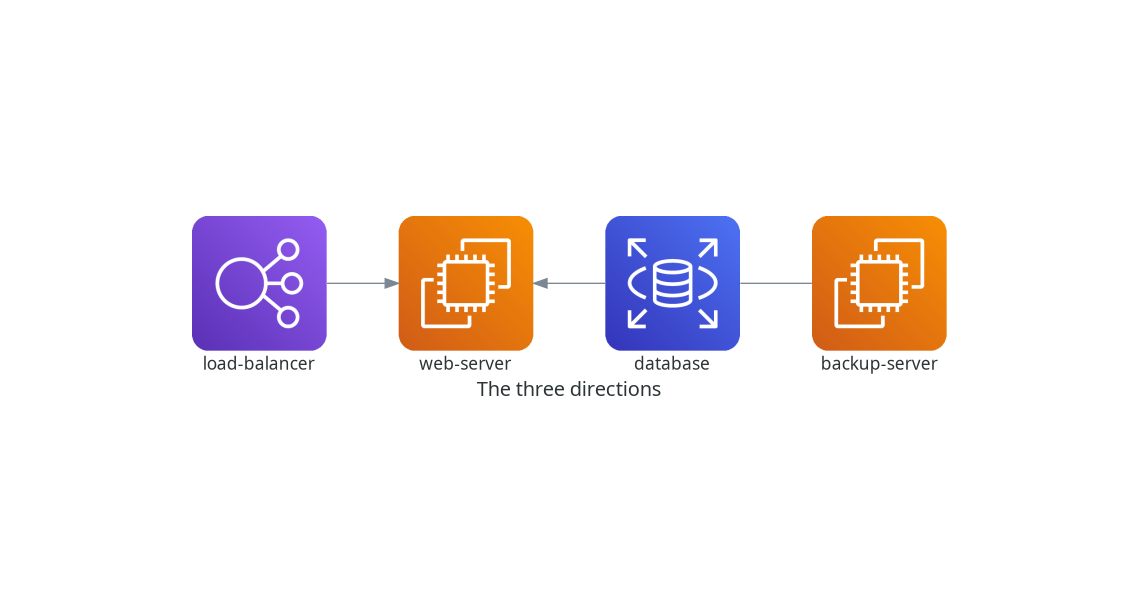
>>表示从左到右的流向<<表示相反的方向(从右到左)-表示无方向性的连接
from diagrams import Diagram
from diagrams.aws.compute import EC2
from diagrams.aws.database import RDS
from diagrams.aws.network import ELB

with Diagram("The three directions"):
    load_balancer = ELB("load-balancer")
    web_server = EC2("web-server")
    database = RDS("database")
    backup_server = EC2("backup-server")

    load_balancer >> web_server
    web_server << database
    database - backup_server
# 用从左到右的箭头表示负载均衡器与 Web 服务器之间的连接
load_balancer >> web_server

# 用从右到左的箭头表示 Web 服务器与数据库之间的连接
web_server << database

# 用直线表示数据库与备份服务器之间的连接
database - backup_server
分组数据流
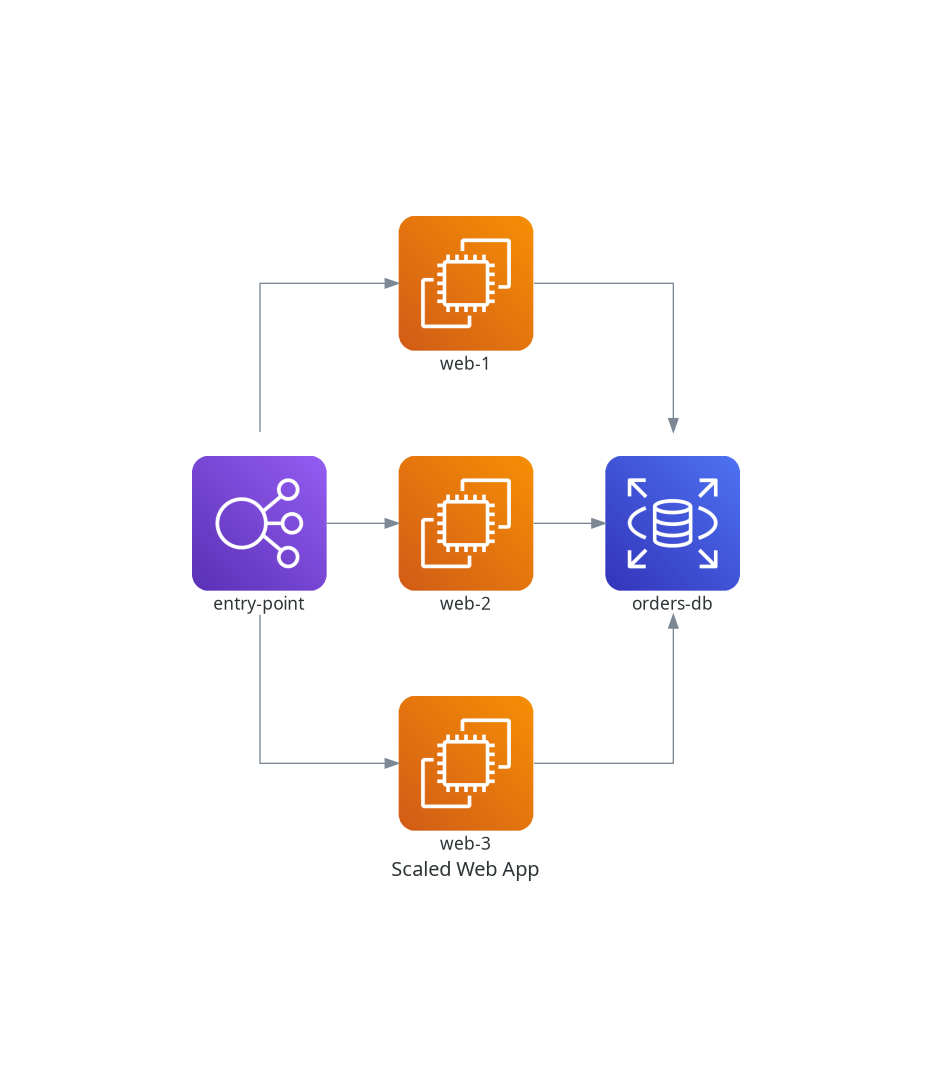
                    ┌──► web-1 ───┐
负载均衡器 ──────┼──► web-2 ───┼──► 数据库
                    └──► web-3 ───┘
首先,创建一个负载均衡器:
load_balancer = ELB("entry-point")
然后创建多个服务器。不必像这样分别创建三个变量:
server1 = EC2("web-1")
server2 = EC2("web-2")
server3 = EC2("web-3")
你可以将它们放在一个Python列表中:
web_servers = [
EC2("web-1"),
EC2("web-2"),
EC2("web-3")
]
然后这样将负载均衡器与服务器列表连接起来:
load_balancer >> web_servers
这样一来,就无需手动编写如下代码了:
load_balancer >> web Servers[0]
load_balancer >> web Servers[1]
load_balancer >> webServers[2]
现在,将整个服务器列表与数据库连接起来:
web_servers >> database
这种做法有助于减少代码中的冗余部分,同时也有助于处理那些重复出现的组件,比如多个Pod、工作节点等等。
完整的代码如下所示:
from diagrams import Diagram
from diagrams.aws.compute import EC2
from diagrams.aws.database import RDS
from diagrams.aws.network import ELB
with Diagram("扩展型Web应用"):
load_balancer = ELB("entry-point")
web_servers = [
EC2("web-1"),
EC2("web-2"),
EC2("web-3")
]
database = RDS("orders-db")
load_balancer >> web Servers >> database
集群
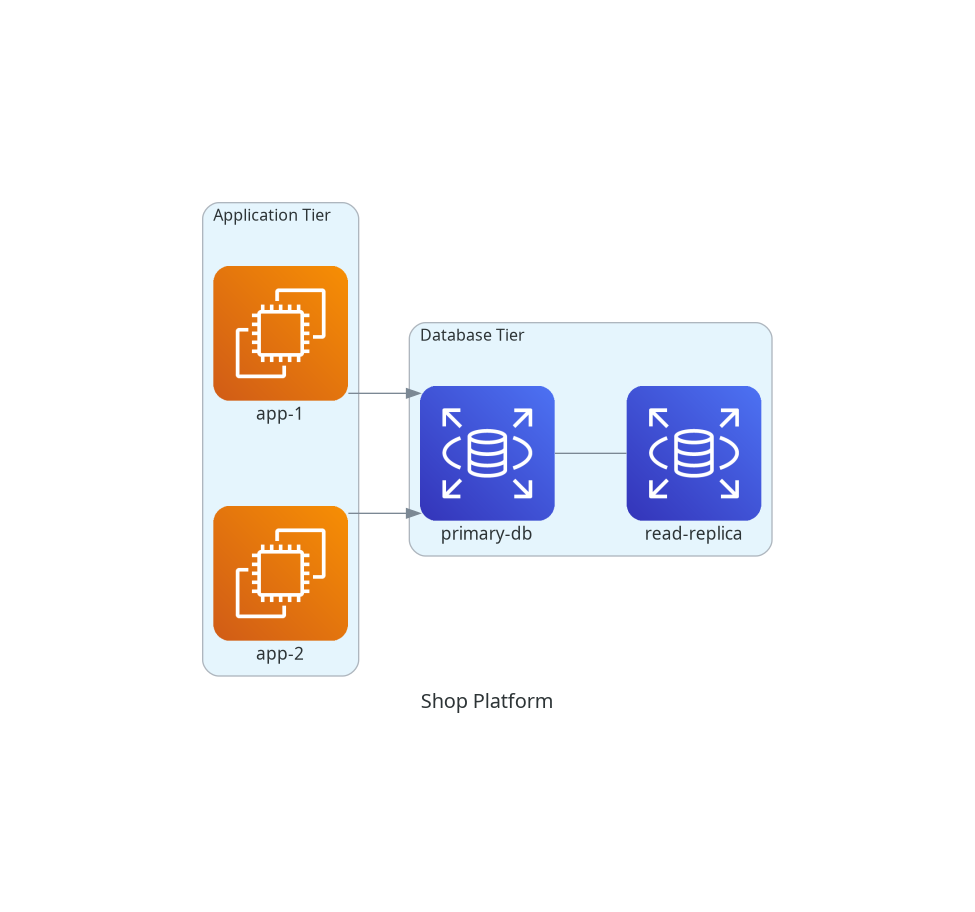
你可以使用“集群”将相关的节点放在同一个标记框内。不过,你仍然可以将集群内的节点与外部的节点进行连接。
进行分组是必要的,因为这样才能清楚地表明哪些元素属于同一组。这样做有助于表达诸如以下概念:
应用层
数据库层
可用区
区域
环境
微服务组
工作节点组
创建集群的语法如下:
with Cluster("集群名称"):
在此语句下面缩进编写的所有内容都属于该集群。
以下是一个演示如何使用集群的例子:
from diagrams import Diagram, Cluster
from diagrams.aws.compute import EC2
from diagrams.aws.database import RDS
with Diagram("购物平台"):
with Cluster("应用层"):
apps = [
EC2("app-1"),
EC2("app-2")
]
with Cluster("数据库层"):
primary_db = RDS("primary-db")
replica_db = RDS("read-replica")
apps >> primary_db
primary_db - replica_db
使用这种语法,也可以嵌套集群:
with Cluster("Production"):
with Cluster("Backend"):
with Cluster("API"):
...
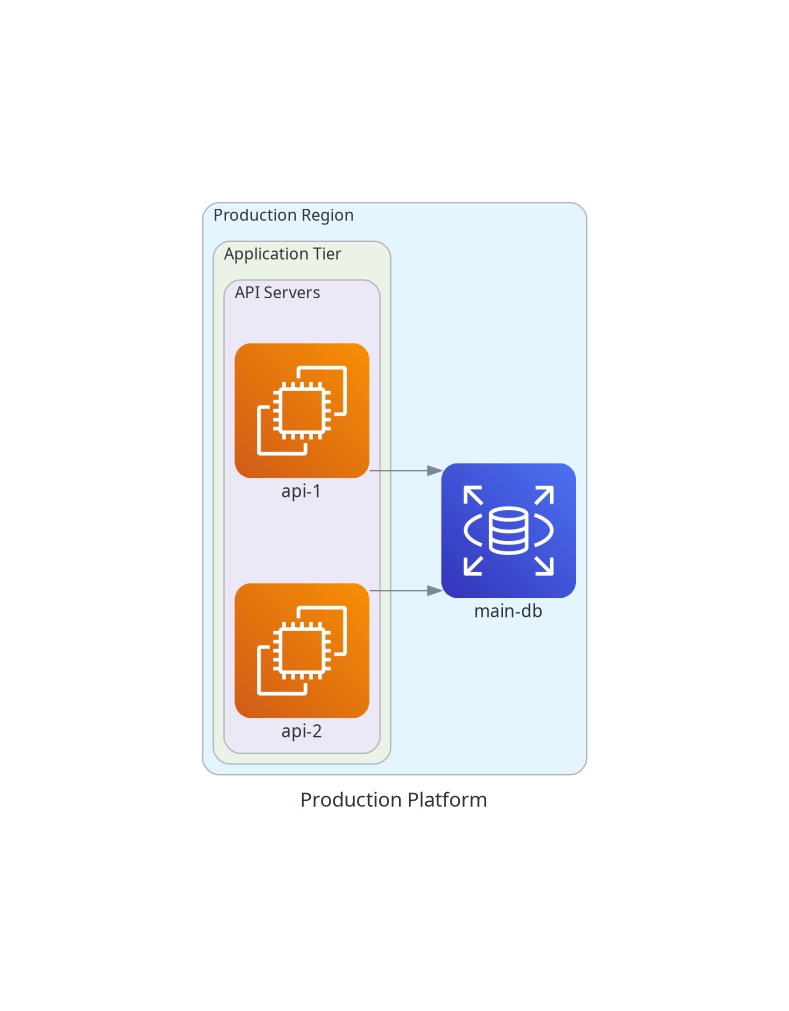
让我们来看一个更具体的例子,其中包含了集群的嵌套结构:
from diagrams import Diagram, Cluster
from diagrams.aws.compute import EC2
from diagrams.aws.database import RDS
with Diagram("Production Platform"):
with Cluster("Production Region"):
with Cluster("Application Tier"):
with Cluster("API Servers"):
api1 = EC2("api-1")
api2 = EC2("api-2")
database = RDS("main-db")
api1 >> database
api2 >> database
这个例子展示了一个名为Production Platform的结构,其中包含了Production Region,而Production Region又包含了Application Tier。在Application Tier中,进一步划分出了两个API服务器。生产区域内还部署了一个独立的RDS数据库,这两个API服务器都连接到了这个数据库。
通过将不同的集群相互嵌套在一起,就可以实现更复杂的结构。请参考下面的代码示例:
with Cluster("Production Region"):
with Cluster("Application Tier"):
with Cluster("API Servers"):
api1 = EC2("api-1")
api2 = EC2("api-2")
边
边提供了一种连接节点的另一种方式。与普通的>>或<<<不同,边允许你添加标签、颜色和样式等属性。
之前你是这样使用的:
from diagrams import Diagram
如果要使用边,就需要添加以下代码:
from diagrams import Diagram, Edge
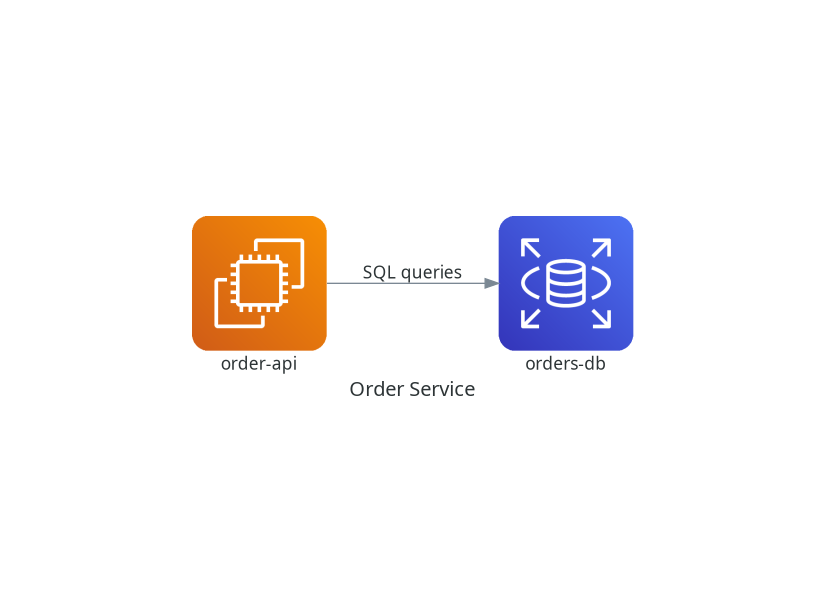
现在,我们可以用一条边将app与database连接起来:
# 为边添加标签
app >> Edge(label="SQL queries") >> database
这样,就用一条标有“SQL queries”标签的边将app与database连接起来了。
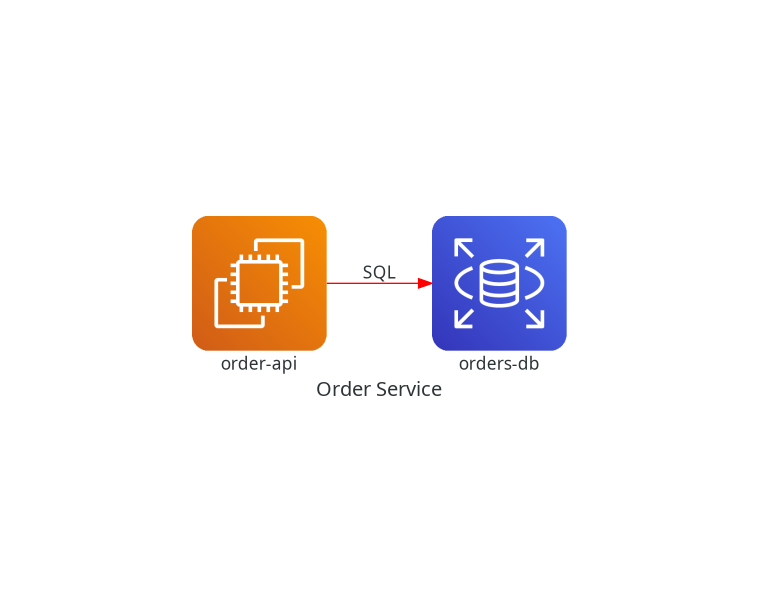
你还可以自定义边的颜色:
app >> Edge(label="SQL", color="red") >> database
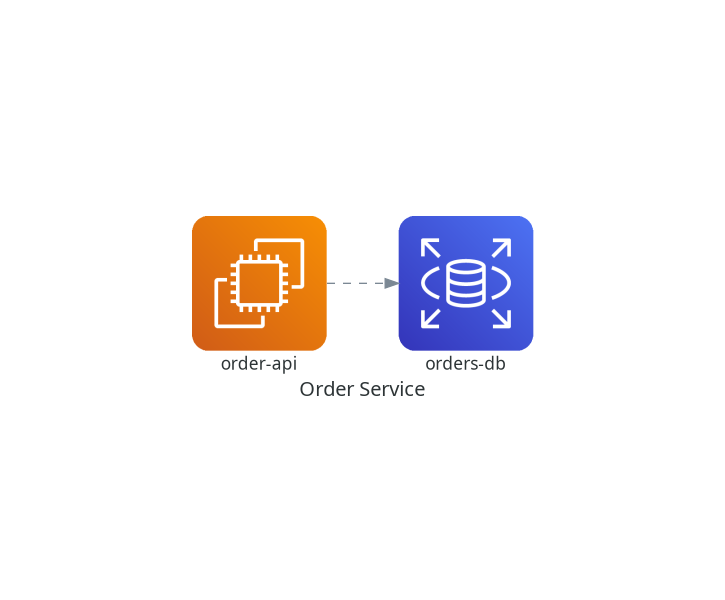
您也可以修改边的样式:
app >> Edge(style="虚线") >> database
还有一些其他的边样式可供选择:
Edge(style="点线")
Edge/style="粗体")
下面的示例结合了多种边的样式:
from diagrams import Diagram, Edge
from diagrams.aws.compute import EC2
from diagrams.aws.database import RDS
with Diagram("支付服务"):
api = EC2("payment-api")
database = RDS("payments-db")
api >> Edge(
label="支付记录",
color="darkgreen",
style="虚线"
) >> database
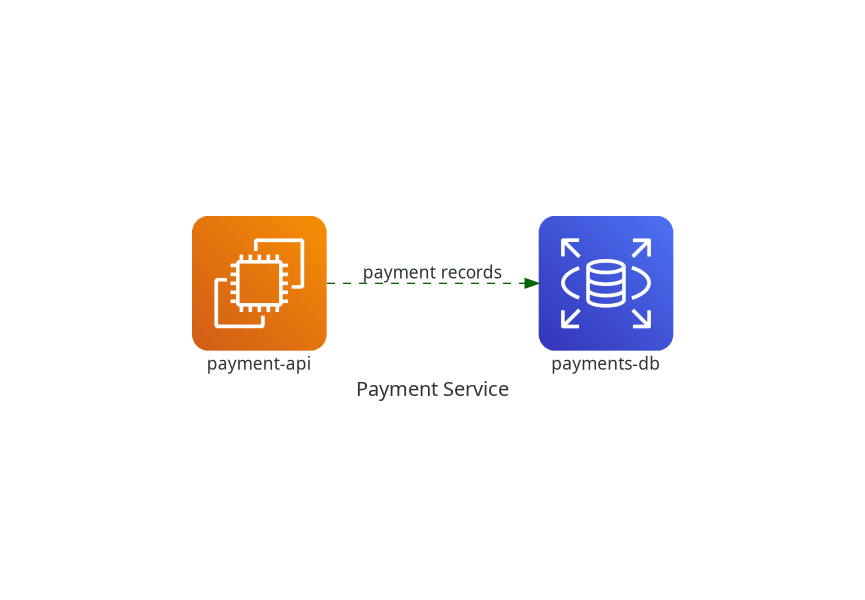
请注意,您也可以使用<&><和-来表示边的连接关系。
总结
通过本教程,您学习了如何利用“图谱即代码”的方法来创建具有意义且格式统一的图表,并了解这些图表如何在不同团队之间得到有效使用。这种方法能够帮助您提高工作效率,同时也不会影响图表的质量或开发/维护工作的质量。
在本教程中,您主要使用了AWS相关的组件。您可以在这份指南中了解其他可用的工具提供商,并根据自己的需求来创建图表。
非常感谢您阅读到这篇文章的结尾。如果您从这篇文章中学到了什么,欢迎将这些知识分享给他人。
保持联系,继续您的学习之旅吧!
您可以通过以下方式与我保持联系:
祝您编码愉快!
相关文章
如何在不编写Recharts样板代码的情况下,将shadcn图表添加到Next.js应用程序中
在任务列表中,创建图表似乎是一项简单的任务。但当你打开 Recharts 的文档后,就会发现其实每个图表的设置都需要耗费不少精力:需要为标签和颜色配置相应的对象、设置坐标轴、添加工具提示、设计图例、选择适合深色模式的配色方案,还要确保图表容器能够正确地调整大小。我们大多数人都会从上一个项目中复制这些设置内容,然后重新命名相关变量即可。 shadcn/ui 图表组件在一定程度上减轻了这些工作负担。它为 Recharts 提供了与主题风格相匹配的配色方案和工具提示功能,但用户仍然需要手动编写每个图表的代码。 因此,我开发了 ChartCN——这个免费且开源的 shadcn 图表生成工具 。你只需粘
阅读全文
Radicle揭示了那些会暴露私有代码仓库的关键缺陷,而这些缺陷实际上是以明文形式存在的。
Radicle在其网络协议中发现了两处严重的安全漏洞,这些漏洞会影响所有版本的节点的正常运行,从而导致数据保密性遭到破坏。攻击者可以利用这些漏洞直接访问私有存储库中的数据,并伪造节点的身份进行恶意操作。由于存在架构上的缺陷,建议立即停止所有涉及明文传输的操作。为修复这些漏洞,需要更换为新的协议(Iroh),但这会导致旧版本与新版本之间的不兼容问题。 作者:Olimpiu Pop
阅读全文
WebRTC是如何实现扩展性的?信号传输机制、NAT穿越技术,以及Mesh架构、SFU架构与MCU架构之间的权衡取舍
Web实时通信(WebRTC)是一种开放标准,浏览器利用这一标准直接相互发送音频、视频和数据。无需任何插件或原生应用程序,只需要每个浏览器都已内置的API即可。 WebRTC负责处理媒体数据的传输过程:一旦两台设备建立连接,从编解码器的选择到数据的编码与传输,所有相关环节都由WebRTC来处理。不过,它并不负责设备之间的连接建立过程。 本文探讨了构成WebRTC标准的三个API,分析了为什么信号传输机制和NAT穿透技术不属于这些API的范畴,介绍了一种大规模部署的信号服务器实现方案,并讨论了影响媒体数据传输能力的关键因素,如Mesh网络结构、选择性转发单元以及多点会议单元等。 目录 基础构成:
阅读全文
理解CAP定理:系统设计中的一致性、可用性与分区容错性
1999年,埃里克·布鲁尔提出了一种理论,这一理论在随后几十年里极大地影响了分布式系统的设计方式。他指出,任何分布式数据存储系统最多只能同时满足三个属性中的两个:一致性、可用性和分区容错性。 两年后,塞思·吉尔伯特和南希·林奇正式证明了这一观点,这一理论后来被称为CAP定理。 所有那些需要在多台机器上存储数据的分布式数据库、云服务或系统,都必须在这三个属性之间做出选择。理解这些属性的具体含义、为什么不能同时满足全部三个属性,以及在实际应用中应该如何做出这种选择,对于任何负责构建或运营大规模系统的工程师来说,都是至关重要的基础知识。 目录 先决条件 三个属性 为什么不能同时满足全部三个属性 真正
阅读全文