
如何在容器构建过程中使用npm ci命令后诊断“not found”这一错误?
我最近参与了一个项目,在这个项目中,一个使用Node.js开发的应用程序通过Vite来编译其前端代码。该应用程序在基于浏览器的开发环境中可以正常运行,但当将其部署到Azure Container Registry后,构建过程出现了问题。在尝试安装某些依赖项失败之后,构建工具报告称缺少Vite可执行文件。 容器构建最终出现了一个简单的错误: sh: 1: vite: not found Vite明明已经包含在 devDependencies 中。在调用构建脚本之前,构建阶段确实执行了 npm ci 命令。Dockerfile看起来也很正常,因此最初的排查方向都是围绕依赖项的选择或 NODE_EN
我最近参与了一个项目,在这个项目中,一个使用Node.js开发的应用程序通过Vite来编译其前端代码。该应用程序在基于浏览器的开发环境中可以正常运行,但当将其部署到Azure Container Registry后,构建过程出现了问题。在尝试安装某些依赖项失败之后,构建工具报告称缺少Vite可执行文件。
容器构建最终出现了一个简单的错误:
sh: 1: vite: not foundVite明明已经包含在devDependencies中。在调用构建脚本之前,构建阶段确实执行了npm ci命令。Dockerfile看起来也很正常,因此最初的排查方向都是围绕依赖项的选择或NODE_ENV环境变量来进行的。
实际上,这个错误是由于之前的安装步骤失败导致的。npm ci试图从某个仅在基于浏览器的开发环境中存在的包托管平台上下载数百个tar文件,但由于该平台并不存在于实际的容器环境中,因此下载操作失败。系统会输出“Exit handler never called!”的提示信息,导致node_modules目录为空,并且Docker也无法得到明确的构建失败状态。随后执行的npm run build命令再次发现了这个缺失的可执行文件。
问题的根源在于锁文件中指定的包下载地址是无效的。本教程将介绍如何检查安装操作是否真正完成,找到导致问题的那些tar文件的下载链接,并在重新构建应用程序之前仔细检查所有的依赖项配置。修复方案主要是修改公共包URL的前缀,并增加一些额外的构建检查步骤。应用程序的包版本、完整性校验信息、代码以及Vite配置都不会因此发生任何变化。
目录
开始之前
进行这项操作之前,你需要确保自己拥有一个包含package.json文件、版本为2或3的package-lock.json文件、容器构建日志以及Docker环境的Node.js项目。示例中使用的容器镜像是支持Node 24版本的镜像,而该项目会将构建结果保存到dist目录中。请先检查你自己项目的依赖项兼容性及输出目录设置是否正确。
.invalid这个域名仅用于代表原来的内部主机地址;只有在仔细检查了这些软件包所服务的功能之后,才能决定是否需要使用这个前缀。构建过程是如何出现故障的
该应用程序最初是在一个基于浏览器的开发环境中进行开发的,后来被迁移到了Azure容器注册服务中进行构建。开发平台充当了公共npm包的代理服务器。当它重新生成package-lock.json文件时,会将自身的内部tarball下载地址存储在resolved字段中。
这次故障涉及两个不同的环境:
在开发环境中,npm可以通过代理服务器获取所需的包文件,而lockfile文件中也记录了这些代理地址。
Azure容器注册服务的镜像构建工具接收到了同样的lockfile文件,但它无法解析出这些代理服务器的地址。
在尝试安装依赖项时,系统会输出“Exit handler never called!”的错误信息,并且
node_modules目录会变为空。不过,这种故障并不会阻止后续的Docker构建过程继续进行。接下来的构建步骤会执行
npm run build命令来调用Vite编译器,但由于没有安装Vite可执行文件,因此会出现“vite: not found”的错误。
后续的检查流程是从缺失的可执行文件开始,逆向追踪到相应的包文件位置,然后修复这些URL地址问题,并确保每个依赖项都能被正确安装。
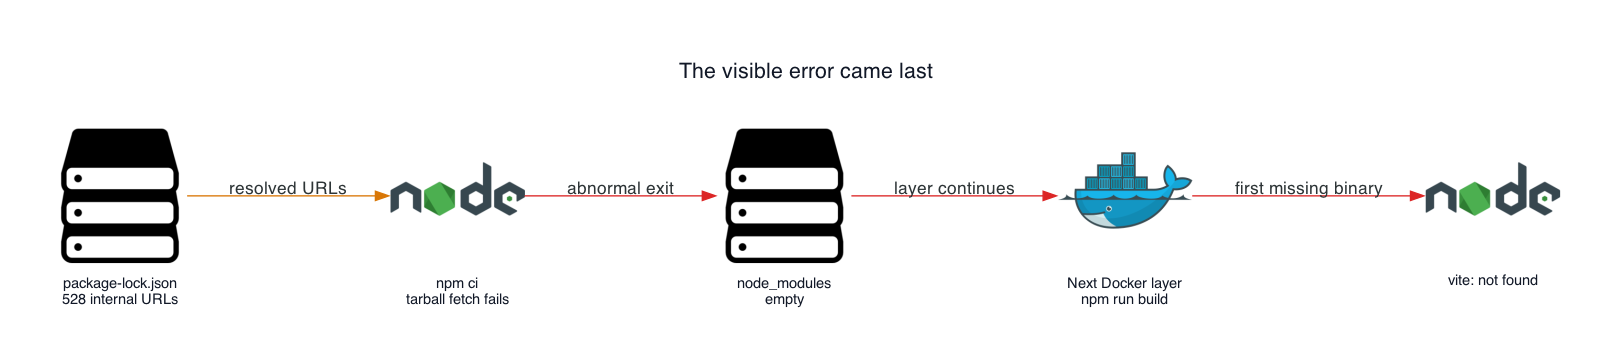
图1. 容器构建过程记录了这一系列故障中的最后一次错误。
步骤1:检查npm ci是否安装了任何软件包
该项目使用了npm ci命令来进行重复性的容器构建。根据npm的官方文档,这个命令会在开始安装之前删除现有的node_modules目录,并且会将lockfile文件视为不可修改的固定文件,而不会对其进行更新。
正是因为这些特性,这次故障的表现非常明显:系统无法使用之前本地安装的包文件进行构建,因为一旦tarball下载失败,node_modules目录就会变得空无一物。
Dockerfile将依赖项的安装过程与源代码的编译过程分开了。步骤3会对比原始的构建流程和修改后的构建流程,以找出其中的问题所在。
后来出现的“vite: not found”错误并不能说明npm是否真的安装了Vite包文件。因此,我们需要在出现故障的相同环境中检查node_modules目录:
test -d node_modules && find node_modules -mindepth 1 -maxdepth 1 | head
test -x node_modules/.bin/vite
通过这些测试,我们可以确认:首先,系统中并没有安装任何包文件;其次,Vite可执行文件确实缺失。需要注意的是,如果省略了某些开发所需的依赖项,也可能会导致类似的错误现象,因此在进行任何配置修改之前,一定要先仔细检查目录内容。
在成功完成安装后,目录列表中应该会显示各个包的名称。执行 `test -x` 命令时不会输出任何内容。在该命令执行后立即检查其退出状态:
echo $?如果 Vite 可执行文件缺失,预期的退出状态应该是:
1而退出状态为 0 说明该可执行文件存在且可以正常运行。
重要提示:如果依赖目录为空,那就说明安装过程出现了问题。如果其他包都存在,但只有 Vite 缺失,那么还需要检查是否在安装过程中遗漏了某些开发依赖项。这些命令用于检查依赖目录的内容,而不会修改该目录。
步骤 2:查找锁文件用于下载包的位置
一个典型的锁文件条目结构如下:
{
  "node_modules/example-package": {
    "version": "1.2.3",
    "resolved": "http://packages.internal.invalid/npm/example-package/-/example-package-1.2.3.tgz",
    "integrity": "sha512-<subresource-integrity-value>"
  }
}
上面示例中的 `.invalid` 是一个占位符,实际使用时会替换为真实的内部主机名。这种结构与历史上的锁文件格式是一致的。
根据 npm 的文档说明,`resolved` 字段表示包是从哪个地址获取的。对于从注册库下载的包来说,这个地址可能是一个 tarball 文件的 URL。因此,在构建工具中配置的注册库并不会影响锁文件的生成过程;锁文件已经指明了需要从哪里下载各个包。
我统计了历史记录中受影响的条目数量:在总共 1,038 条依赖项记录中,有 528 条使用了内部主机名,而这些主机名在外部构建环境中是无法解析的。
npm 的调试日志显示,这些问题其实早就在安装过程中出现了。那些无法解析的主机名错误出现在 “Exit handler never called!” 这条错误信息之前,因此这个顺序非常重要:`Exit handler never called!` 这条消息说明了 npm 是如何结束执行的,而那些下载失败的原因则解释了为什么依赖关系树会为空。
我没有只查找某个特定的包名称,而是将所有包含 `resolved` 字段的记录按照主机名进行了分类。以下是一个简单的 JavaScript 脚本,用于实现这一功能:
const fs = require('node:fs')
const lock = JSON.parse(fs.readFileSync('package-lock.json', 'utf8'))
const hosts = {}

for (const entry of Object.values(lock.packages ?? {})) {
  if (!entry.resolved?.startsWith('http')) continue
  const host = new URL(entry.resolved).host
  hosts[host] = (hosts[host] ?? 0) + 1
}

console.table(hosts)
通过这个统计结果可以看出,实际上有 528 条依赖项记录受到了影响,而并不是某个特定的 tarball 文件出了问题。这也让我们明确了修复工作的范围:只需要修改 `resolved` 字段中记录的包下载地址即可,因为包的版本号和完整性校验值并没有发生变化。如果列表中包含了私有注册库的信息,在重新编写相关配置之前,先确定这些注册库为哪些包提供了服务。
历史记录中确实包含这一条信息。该表格使用了示例中提供的替换后的主机名来进行显示:
| 主机名 | 已重写的URL地址数量 |
|---|---|
packages.internal.invalid |
528 |
您的主机名及其对应的URL地址数量取决于您的锁文件内容。此统计结果仅针对HTTP形式的包文件路径,因此其总数可能与依赖项的实际数量有所不同。
注意:请确认哪些无法访问的主机所使用的包来自公共npm注册库,在选择替代前先记录受影响的包的数量。仅凭主机名数量并不能保证重写这些URL地址是安全的。
步骤3:仅重写已知的公共包URL前缀
重新生成锁文件时,修复注册库中的问题与更新依赖项会同时进行。保持包的版本号和完整性值不变,有助于后续审核修复过程。
此示例中受影响的包都来自公共npm注册库。开发平台对这些包进行了代理处理,并保留了它们的完整性值。在容器安装之前,系统会对这些包的URL前缀进行修改。
对于本次操作步骤,请将以下代码保存为rewrite-lockfile.cjs。该脚本只会将那些使用指定前缀的resolved字段进行更新,在写入文件之前还会检查旧版本文件中是否缺少完整性值或存在异常路径。
const fs = require('node:fs')

const oldPrefix = 'http://packages.internal.invalid/npm/'
const newPrefix = 'https://registry.npmjs.org/'
const oldHostname = new URL(oldPrefix).hostname
const filename = 'package-lock.json'
const lock = JSON.parse(fs.readFileSync(filename, 'utf8'))

if (!lock.packages || typeof lock.packages !== 'object') {
  throw new Error('期望的锁文件中应包含packages对象(版本2或3)')
}

let rewritten = 0
for (const entry of Object.values(lock.packages)) {
  if (typeof entry.resolved !== 'string') continue
  if (!entry.resolved.startsWith(oldPrefix)) continue
  if (!entry.integrity) throw new Error('有受影响的包缺少完整性值')
  entry.resolved = newPrefix + entry.resolved.slice(oldPrefix.length)
  rewritten += 1
}

for (const entry of Object.values(lock.packages)) {
  if (typeof entry.resolved !== 'string') continue
  if (!entry.resolved.startsWith('http')) continue
  if (new URL(entry.resolved).hostname === oldHostname) {
    throw new Error('旧主机名的URL前缀仍然不正确')
  }
}

fs.readFileSync(filename, JSON.stringify(lock, null, 2) + '\n')
console.log(`共重写了${rewritten}个URL地址`)
当运行依赖项处理脚本时,实际重写的URL地址数量应与预期值一致。用于测试本教程的小项目产生的结果如下:
共重写了40个URL地址这个测试项目与实际的应用程序是分开的;实际应用程序中有528个依赖项受到了影响。您可以根据自己的锁文件情况来确认预期的重写数量。对于已经完成修复的文件,其重写后的URL地址数量应为0;如果某个未修复的文件显示重写数量为0,请检查其URL前缀是否正确。
该脚本并不会自动判断某个包是否为公共包,因此需要单独进行确认。npm的完整性检查会验证下载到的文件内容是否与锁文件中的信息一致。
.dockerignore文件可用于排除本地依赖项和配置文件,使其不被包含在构建过程中:
node_modules
dist
.git
.env*
.npmrc
这个示例展示了如何安装公共包。而私有仓库则需要拥有自己的可访问端点,并确保在构建过程中能够进行安全认证。
下面的第一部分列出了原始Dockerfile中受影响的指令,第二部分则是完整的构建流程。该示例使用了Node 24版本,并采用了特定的安装方式,请根据您自己的应用程序实际情况检查兼容性。
原始安装与构建流程
COPY package.json package-lock.json ./
RUN npm ci

COPY . .
RUN npm run build
FROM node:24-slim AS dependencies
WORKDIR /app
COPY package.json package-lock.json rewrite-lockfile.cjs ./
RUN node rewrite-lockfile.cjs \
&& npm ci --include=dev \
&& test -x node_modules/.bin/vite
FROM node:24-slim AS build
WORKDIR /app
COPY . .
COPY --from=dependencies /app/node_modules ./node_modules
COPY --from=dependencies /app/package-lock.json ./package-lock.json
RUN npm run build
修改后的Dockerfile明确了每个构建阶段的具体功能:
在执行`npm ci`之前,通过URL重写机制会去掉包名前缀“public-”。
`--include=dev`这一选项明确指出了需要安装开发环境所需的依赖项。
通过检查Vite可执行文件的存在,可以确保在安装过程中不会遗漏任何必要的依赖项。
依赖项的安装阶段会在应用程序的构建阶段之前完成,这样构建阶段才能复制并编译这些依赖项。
在第二阶段中,会复制修改后的锁文件。否则,`COPY . .`命令会将原始的锁文件重新放入构建镜像中。.dockerignore文件还能防止本地的`node_modules`文件夹覆盖第一阶段安装的依赖项。
即使构建环境将`NODE_ENV`设置为`production`,只要某个依赖项属于开发环境所需的项目,`--include=dev`选项也会确保将其包含在安装范围内。由于这个镜像是用于构建环境的,因此必须包含编译器和相关的构建工具。请选择与您的项目兼容的Node版本。
通过对历史锁文件的内容进行对比,发现共有528个字段发生了变化,这些字段的名字都是“resolved”。同时没有发现`version`或`integrity`字段有任何变化,也没有残留的内部主机名信息。上面的示例脚本也会确保那些与当前构建过程无关的字段保持不变,不过JSON格式可能会发生一些变化。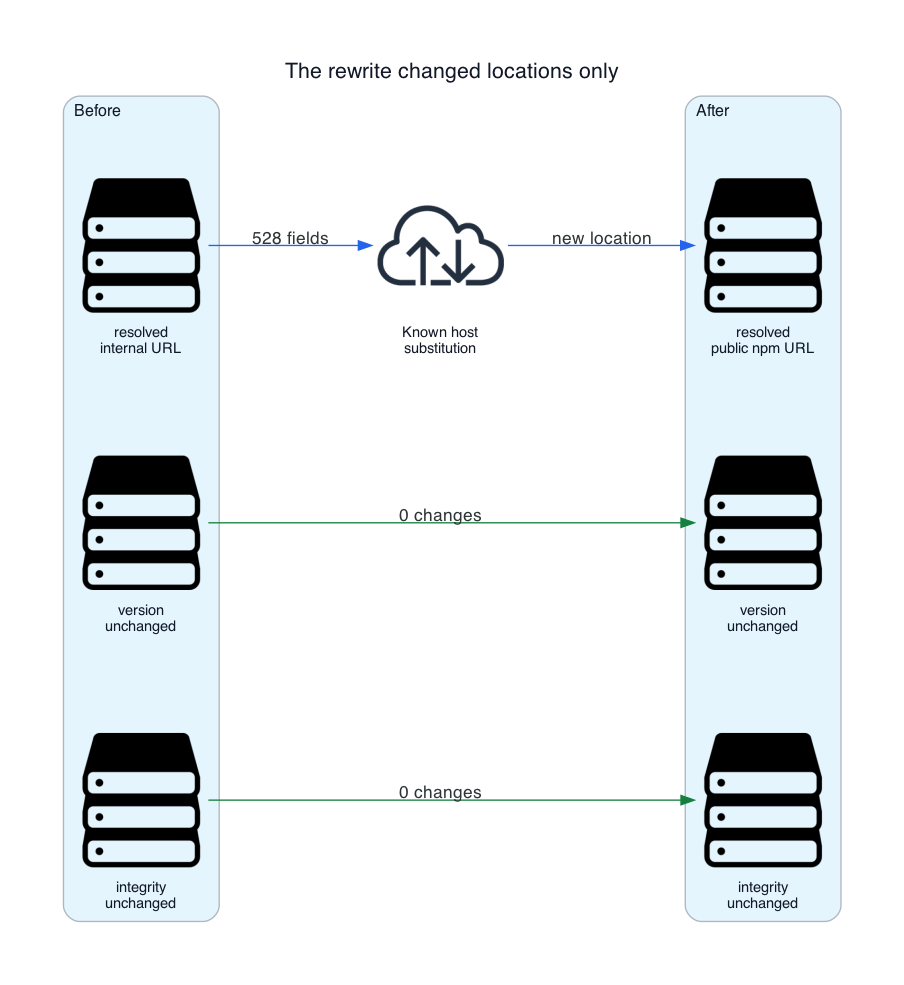
在执行`npm ci`之前,通过URL重写机制会去掉包名前缀“public-”。
`--include=dev`这一选项明确指出了需要安装开发环境所需的依赖项。
通过检查Vite可执行文件的存在,可以确保在安装过程中不会遗漏任何必要的依赖项。
依赖项的安装阶段会在应用程序的构建阶段之前完成,这样构建阶段才能复制并编译这些依赖项。
.dockerignore文件还能防止本地的`node_modules`文件夹覆盖第一阶段安装的依赖项。图2. 该修复措施会改变包的安装位置,但依赖关系的身份信息保持不变。
如果系统中仍然缺少Vite,那么执行检查时会导致依赖关系处理阶段失败。此时Docker会停止运行,而不会继续进行应用程序的构建过程。
检查要点:请核对重写操作的次数是否与实际记录一致,确认已移除旧的主机名,同时比较修复前后包的版本信息及完整性值。在完成依赖关系处理阶段后,还需要执行`npm ci --include=dev`命令,并进行Vite的可执行文件检查。第5步会生成容器镜像并验证应用程序的输出结果。
步骤4:在每次独立安装时都应用相应的保护机制
持续集成任务与容器镜像构建过程是分别独立进行的。即使修改了工作流程的执行逻辑,Dockerfile中的`npm ci`命令也不会受到影响。因此,在生成新的容器镜像时,系统会使用原始的代码仓库文件,并在另一个环境中创建相应的依赖关系层。
重写操作发生在依赖文件被导入安装环境之后。根据Docker关于缓存处理的建议,应该先安装依赖关系,然后再复制那些经常发生变化的源代码文件。在这个例子中,依赖关系的处理阶段就遵循了这一原则——只要源代码文件发生更改,应用程序构建过程就会重新开始。
在每次进行独立安装之前,都需要应用相同的保护机制:
持续集成过程中的类型检查及安装操作
容器镜像构建过程中的安装操作
多阶段Dockerfile中任何属于运行时阶段的安装操作
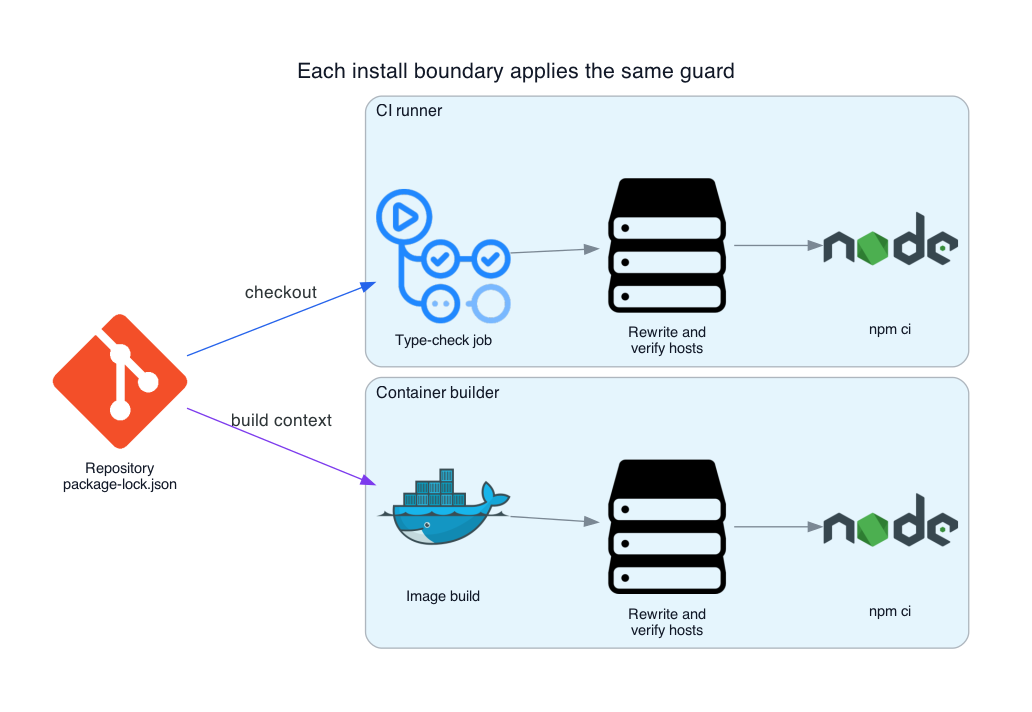
图3. 这种处理方式可以确保容器镜像构建过程中的安装操作不会受到错误的影响。
这种安排还能避免出现误导性的部分修复结果——因为在不同的安装过程中,虽然类型检查可能通过,但由于使用了相同的锁定文件,容器镜像的构建过程仍可能会失败。
步骤5:验证依赖关系树及信任边界设置
这种修复措施是安全的,因为受影响的那些包实际上都是通过透明的开发平台代理机制从npm公共仓库中获取的。这些包的完整性信息依然存在,而且重写操作也没有改变任何包的版本号。
对于私有软件包、已打过补丁的软件包,或者那些在相同版本下会使用不同数据格式的软件包来说,采用同样的替换方法是不安全的。一个可移植的开发环境应该将这些软件包存储在一个可以访问的私有注册系统中,并为该注册系统配置相应的认证机制。在将这种模式应用到其他地方之前,我会先统计所有被解析后的主机名,并将公共包与私有包区分开来。随后,我会比较变更前后这些包的版本信息以及完整性数据。如果仍有未获批准的主机名存在,构建过程应该会失败。
有一个npm CLI相关的问题记录显示:当从内部注册表下载包时如果超时,系统也会显示“退出处理程序从未被调用!”这样的错误信息。不过这条信息本身并不能说明包的具体位置。在这起事件中,正是tarball文件的URL以及那些导致构建失败的主机名帮助我们找出了问题的根源。
构建完成后,需要验证生成的结果:
docker build --progress=plain -t vite-install-check .
docker run --rm vite-install-check sh -c \
  'test -x node_modules/.bin/vite && test -s dist/index.html'
构建过程必须通过`npm ci`命令进行验证,同时还需要检查Vite可执行文件的运行结果,以及`npm run build`命令的执行结果。最后一步会检查生成镜像中是否包含预期的Vite输出文件。如果你的项目使用了不同的目录结构,就需要相应地调整这些检查步骤。在这个示例中,生成的镜像用于编译应用程序;如果你需要部署到生产环境,那么还需要设置单独的服务阶段。
一个简单的成功案例并不意味着已经验证了现有应用程序中的所有依赖关系。在实际发布之前,应该使用相同的构建流程来测试你的项目。如果发现某个工具缺失,那么在更换构建工具之前,先检查安装结果以及之前的错误记录吧。
参考资料
相关文章
微软发布了dotnetup的预览版本:这款工具专为.NET SDK及运行时环境设计,用于帮助用户进行相关管理操作。
微软发布了dotnetup的公开预览版。这款跨平台工具链管理器允许用户在无需管理员权限的情况下,在自己的目录中安装和更新.NET SDK及运行时环境。它能够跟踪“最新版本”、“长期支持版本”、“预览版”以及“每日更新版本”等各种版本信息,会读取global.json文件,并自动删除那些未被使用的安装包。不过,在该工具正式发布之前,其命令行接口的具体功能还可能会发生变化。 作者:Almir Vuk
阅读全文
如何利用人工智能提示更快地构建网站用户界面
过去,创建网站的用户界面需要花费数小时的时间来手动编写HTML、CSS代码以及各种组件代码。但现在,你只需用简单的文字描述页面的结构,就可以让人工智能编码工具生成最初的代码版本。 不过,最终生成的代码质量取决于你提供的指令。如果指令过于简短或模糊,那么生成的代码可能只是包含随机颜色和重复代码的简单页面;而如果你能提供详细的说明——包括所使用的技术栈、文件结构以及设计规则,那么工具就能生成可实际使用的代码。 在本教程中,你将学习如何编写这样的指令。通过这些指令,你可以使用Next.js、Tailwind CSS以及shadcn/ui组件来构建一个带有固定导航栏的全屏页面。 完成本教程后,你将能够
阅读全文
谷歌采用Pyrefly来提升Python类型检查的速度与准确性
谷歌已将其长期使用的Python类型检查工具Pytype替换为Pyrefly——这款开源工具最初是由Meta开发的。做出这一决定,主要是因为Pyrefly具有诸多优势:它的类型检查速度更快、准确性更高,同时还能降低基础设施维护成本。 作者:Sergio De Simone
阅读全文
“逆向工程一切项目”将人工智能技术应用于二进制代码分析领域
“Reverse Engineer Anything”是一个开源项目,在GitHub上获得了超过20万的星标。该项目将Claude Code、Codex等编程工具与Ghidra、Hopper、IDA等逆向工程工具连接起来,使开发人员能够检查编译后的二进制文件、追踪函数调用过程,并了解应用程序是如何实现特定功能的。 作者:Renato Losio
阅读全文