
如何阻止人工智能代理生成尼日利亚的邮政编码
2026年10月1日,尼日利亚的邮政编码从六位数字改为由11个字符组成的代码,这种编码能够唯一标识某栋建筑,例如 EK-01-A03-FK-01 。 在此之前训练的语言模型仍然会自信地使用旧格式来处理邮政编码。这会影响两种类型的程序:一种是负责生成验证代码的编程程序,另一种是在运行时从客户信息中读取邮政编码或填写配送表格的程序。 本文将介绍如何解决这个问题。对于那些生成验证代码的程序,你需要检测它们目前生成的代码是否存在错误,并为它们提供相应的规则来纠正这些错误;而对于在运行时处理邮政编码的程序,则需要为它们设定明确的边界:当模型提出一个邮政编码时,由特定的程序来判断该编码是否符合规范、是否已
2026年10月1日,尼日利亚的邮政编码从六位数字改为由11个字符组成的代码,这种编码能够唯一标识某栋建筑,例如EK-01-A03-FK-01。
在此之前训练的语言模型仍然会自信地使用旧格式来处理邮政编码。这会影响两种类型的程序:一种是负责生成验证代码的编程程序,另一种是在运行时从客户信息中读取邮政编码或填写配送表格的程序。
本文将介绍如何解决这个问题。对于那些生成验证代码的程序,你需要检测它们目前生成的代码是否存在错误,并为它们提供相应的规则来纠正这些错误;而对于在运行时处理邮政编码的程序,则需要为它们设定明确的边界:当模型提出一个邮政编码时,由特定的程序来判断该编码是否符合规范、是否已被尼日利亚邮政部门分配,以及后续应该如何处理这个编码。
你还会了解到一些程序可以直接调用的工具,以及各种可能出现的错误状态及其对应的处理方法。示例中使用了由我维护的开源库ng-postcode及其相关的MCP服务器。
目录
先决条件
你需要使用Python 3.10或更高版本。除了实时查询功能外,其他所有操作都可以离线进行,且不需要任何密钥。
对于需要实时查询的功能,你可以从尼日利亚邮政部门开发者控制面板获取所需的密钥。此外,使用MCP功能时还需要uv工具,该工具提供了uvx命令,同时还需要像Claude Code或Cursor这样的MCP客户端程序。
pip install "ng-postcode[client]当前编程程序的行为
我向那个编程代理提出了开发人员才会提出的问题。为了保证测试的公平性,我在一个空文件夹中运行了该程序,因此代理没有任何项目文件可供读取;同时我也允许它访问互联网进行搜索。claude -p "我正在用Python编写一个用于验证邮编的工具。我需要验证尼日利亚的邮编,应该使用什么方法呢?请提供安装命令,并给出一个简短的示例,字数不超过120个词。最后请以以下三行作为结尾:LIBRARY: <你推荐的库名称;如果你自己编写了正则表达式,则写“none”> / FORMAT_ASSUMED: <你假设的邮编格式> / SEARCHED: <是否进行了匹配检查>。今天是2026年10月5日。" --allowedTools "WebSearch,WebFetch"
我在2026年10月5日使用这种工具测试了Python、JavaScript、Rust和Java这四种语言。以下是每种语言对应的检测结果:
| 语言 | 使用的库 | 假设的邮编格式 | )是否进行了匹配检查 |
|---|---|---|---|
| Python | 未使用任何库 | 恰好六位数字,例如100001 | 未进行匹配检查 |
| JavaScript | 未使用任何库 | 六位数字,首位数字为1到9 | 未进行匹配检查 |
| Rust | 未使用任何库 | 恰好六位ASCII数字 | 未进行匹配检查 |
| Java | 未使用任何库 | 六位数字,首位数字为1到9 | 未进行匹配检查 |
有四种语言得到了相同的检测结果。这个检测工具在提示中包含了日期信息,但它仍然只是根据记忆中的信息来生成六位数的邮编格式,而并没有真正进行搜索。
这只是一种检测工具,在某一天对每种语言进行了一次测试,因此你可以用你自己的工具重复这个测试过程。
不过,这种检测机制具有普遍性。任何模型都会模仿其在训练数据中遇到的邮编格式,而如果新的邮编格式在训练数据中并不存在,那么该模型就会产生错误的识别结果。例如,以下代码会拒绝所有真实的尼日利亚邮编:import re
print(re.fullmatch(r"[1-9]\d{5}", "EK-01-A03-FK-01")) # 没有匹配结果
如何从源代码层面修改这个检测工具
该检测工具之所以会生成六位数的邮编格式,是因为它缺乏相关的信息。因此,你需要向它提供这些信息。请将以下内容添加到你的项目的AGENTS.md、CLAUDE.md文件中,或者直接加入编辑器的规则配置中:
尼日利亚的邮编格式:自2026年10月1日起,尼日利亚的邮编由11位数字组成,例如EK-01-A03-FK-01。因此,使用六位数的格式是无法匹配这些邮编的。你可以使用ng-postcode(通过pip或cargo安装)、ng-postcode-js(通过npm安装),或者io.github.adeniyikayodee:ng-postcode(通过Maven安装)来验证和转换这些邮编格式。在npm环境中,ng-postcode是一个独立的项目。更多信息请参考:https://adeniyikayodee.github.io/ng-postcode/llms.txt
在2026年10月13日,我再次使用这个工具进行了测试。这次我在一个只包含CLAUDE.md文件的文件夹中运行了Python脚本,检测结果如下:
LIBRARY: ng-postcode
FORMAT_ASSUMED: 11位数字的尼日利亚邮编格式,例如EK-01-A03-FK-01
SEARCHED: yes
这条规则能够改善检测工具的输出结果。不过,这条规则也可能缺失、被忽略,或者已经过时,而对于那些在运行时才处理邮编信息的模型来说,这些情况并不会对它们的功能产生任何影响。本文的后续内容将介绍如何在这些情况下确保检测结果的准确性。
如何划定界限
在运行时处理邮政编码的模型属于这样一种组件:对于相同的输入,它可能会返回不同的结果,而其中一些结果表面上看似正确,但实际上却是错误的。你在设计程序时就已经考虑过这类组件的存在了。例如,网络可能会丢弃数据包,因此你会添加校验和;用户也可能会错误地填写某些字段,所以你需要加入验证机制。这种模型也属于同一类别。
每个组件都有其特定的功能。该模型负责提取信息中的关键内容:它会在消息中读取“my code is ek 01 a03 fk 01”这样的字符串,并将其提取出来。解析器会判断这个字符串是否代表一个邮政编码;NIPOST API则会确定这个邮政编码是否对应于某栋具体的建筑;而你的代码则会根据前缀来决定应该将任务分配给哪个仓库或队列。在这些决策过程中,没有任何一步是使用模型提供的“置信度”作为依据的。
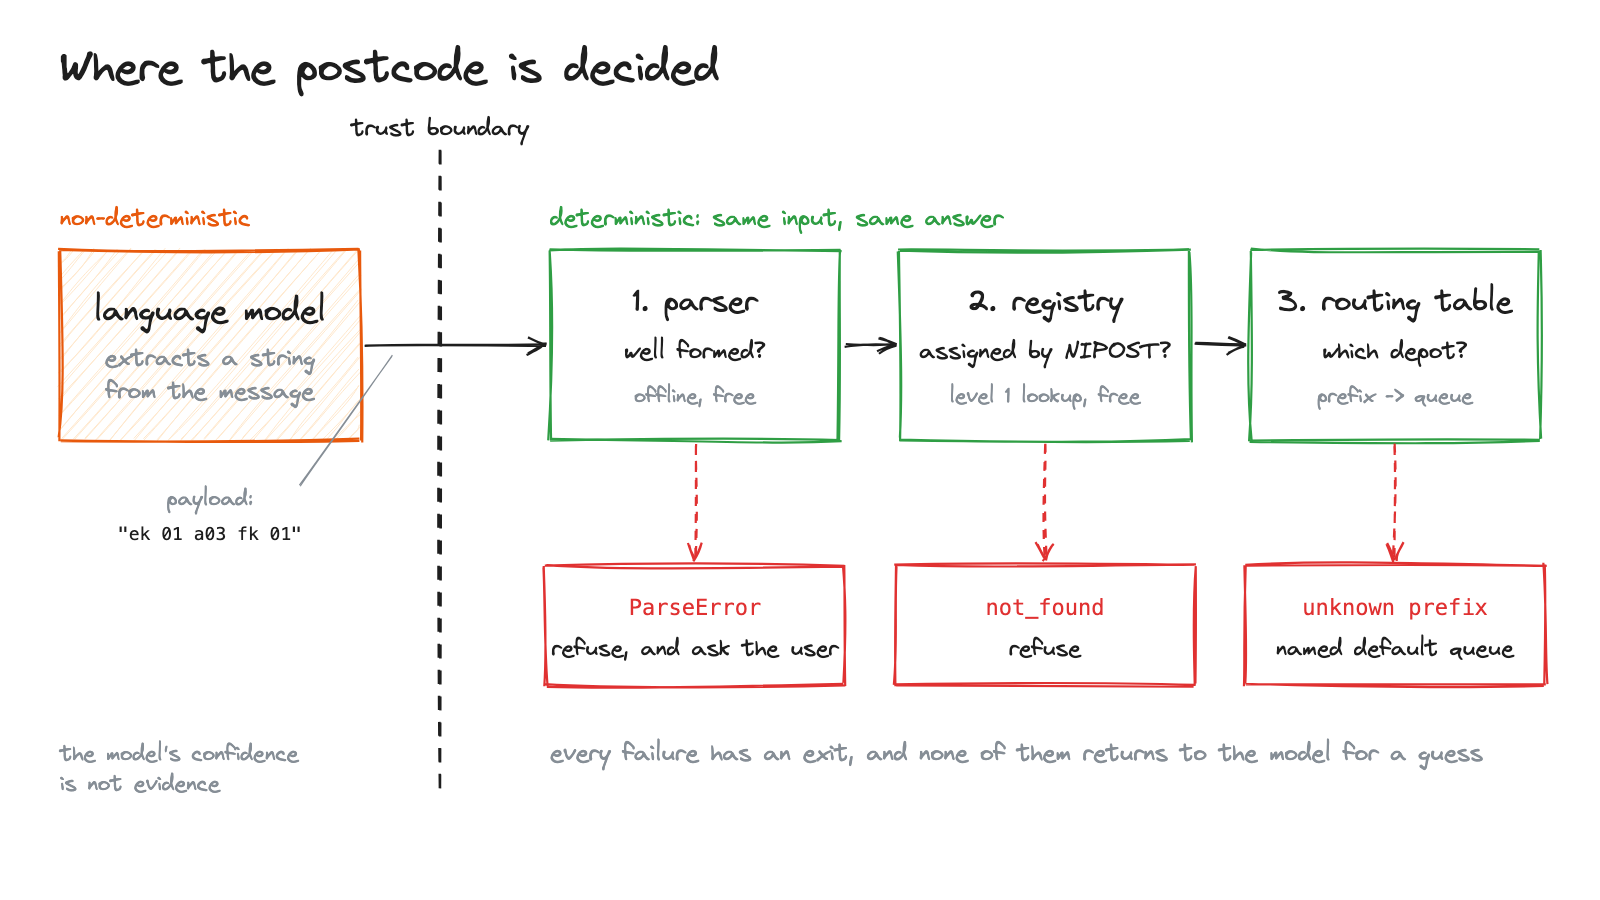
“信任边界”意味着:模型提供所需的信息,而之后的所有决策及错误处理都由确定性代码来完成。
邮政编码这种结构非常适合这种设计方式,因为它的组成规则非常严格。它由五个部分构成,每一部分都会使整个编码的结构更加具体化。
| 部分 | 示例 | 规则 |
|---|---|---|
| 州/地区代码 | EK |
两个字母 |
| 地方政府区域代码 | 01 |
两位数字,范围为01到99 |
| 区/街道代码 | A03 |
三个字母或数字 |
| 区域代码 | FK |
两个字母 |
| 建筑单元代码 | 01 |
两位数字,范围为01到99 |
在大多数情况下,如果某个字符输入错误,就会违反那些可以通过离线方式检查的规则——这些检查过程不需要网络调用,也不需要使用模型。
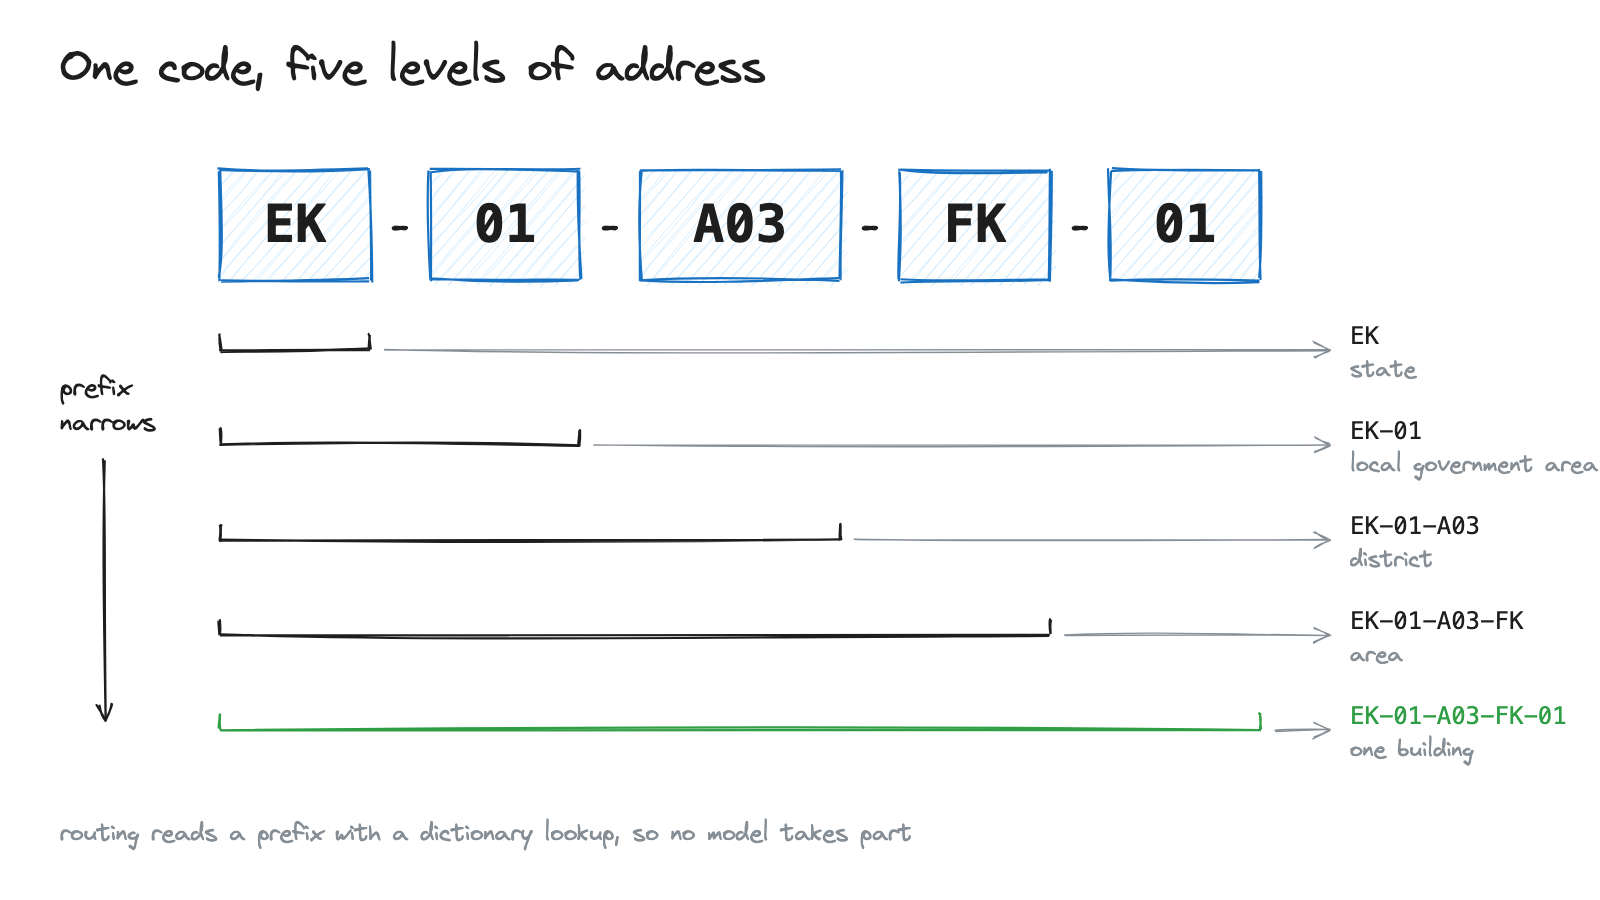
代码中的每个前缀都代表一个更小的区域范围,从整个州到具体的建筑单元都有对应的编码。
如何构建这个验证机制
这个验证机制实际上扮演着一个“过滤器”的角色:系统中处理的每一个邮政编码,在被其他系统组件看到之前,都会先经过这个过滤机制。函数`parse`会返回一个`Postcode`对象或一个错误值,因此类型检查器要求你必须同时处理这两种情况。
from ng_postcode import Corrected, Postcode, parse, parse_lenient


def gate(text: str) -> Postcode | str:
    match parse(text):
        case Postcode() as code:
            return code
        case error:
            match parse_lenient(text):
                case Corrected(postcode=fixed):
                    return f"拒绝处理:{error}。请询问用户:他/她指的是{fixed}吗?"
                case _:
                    return f"拒绝处理:{error}"


for text in ["ek 01 a03 fk 01", "100001", "EK-00-A03-FK-01", "EK-O1-A03-FK-01"]:
    print(gate(text))
EK-01-A03-FK-01
拒绝处理:应包含11位字母和数字,但实际上只找到了6位。
拒绝处理:LGA段格式无效。
拒绝处理:LGA段格式无效。请询问用户:他/她指的是EK-01-A03-FK-01吗?
对于第一个输入,系统会先接受它并将其格式化为标准形式;第二个输入是旧的六位编码,这个验证机制会指出其中存在的问题;第三个输入的本地政府编号为`00`,而该格式并不允许使用这样的数值。
在第四个输入示例中,字母`O`被用在了本应只包含数字的位置,而函数`parse_lenient`能够判断用户可能想要输入的是什么。不过这个验证机制仍然会拒绝处理这个输入,并向用户提出建议。需要注意的是,任何修正结果都只是猜测,因此在用户确认之前,不应将其发送到数据库或通过付费API进行验证。
如何使用NIPOST来确认邮政编码是否已被分配给某栋建筑
这个验证机制的作用是确保输入的字符串格式正确。至于NIPOST是否已经将该邮政编码分配给了某栋建筑,则是另一个问题——通过进行一级查询就可以免费得到答案。在运行相关代码之前,请确保将你的API密钥设置到`NG_POSTCODE_API_KEY`环境变量中。
import os

from ng_postcode import Postcode, parse
from ng_postcode.api import ApiError, lookup
from ng_postcode.client import Client, TransportError


def assigned(code: Postcode, client: Client) -> bool | str:
    match client.send(lookup(code, level=1)):
        case ApiError() | TransportError() as failure:
            return f"未确认:{failure}"
        case found:
            return found.valid


code = parse("EK-01-A03-FK-01")
assert isinstance(code, Postcode)
with Client(api_key=os.environ["NG_POSTCODE_API_KEY"]) as client:
    print(assigned(code, client))
False在NIPOST的文档中,`EK-01-A03-FK-01`这个邮政编码并没有被分配给任何建筑,因此查询结果为`False`。如果查询失败或使用的API密钥无效,系统会返回以`unconfirmed`开头的字符串,以此区分那些因为查询失败而得到的结果,以及那些根本就没有被NIPOST分配的邮政编码。需要注意的是,某些测试用密钥可能会将已经被分配的邮政编码显示为未分配状态,因此在看到`False`的结果时,请务必使用正式的API密钥进行再次验证。
如何按前缀进行路由处理
由于每一层分类都会使范围逐渐缩小,因此代码中的前缀用于标识具体的区域:第一层代表一个州,前两层代表一个地方政府辖区,以此类推,最终会细化到具体的建筑物层面,因此这种路由过程实际上就是通过查字典来完成的。
from ng_postcode import Postcode, Segment, parse

DEPOTS = {"EK-01": "depot-a", "LA-05": "depot-b"}  # 这些都是虚构的名字


def depot(code: Postcode) -> str:
    return DEPOTS.get(code.prefix(Segment.LGA), "national-sorting")


code = parse("EK-01-A03-FK-01")
assert isinstance(code, Postcode)
print(depot(code))  # 输出:depot-a
路由表是由你自己维护的数据,你可以随时查看这些信息。在这个过程中,模型并不参与任何操作,相同的代码总是会指向同一个仓库。对于那些未知的前缀,系统会使用预设的默认值进行处理,因此即使路由表不完整,也不会导致任何任务丢失。
如果让模型从用户输入的文本地址中自动选择目的地,那么同一个客户在不同的日子里可能会被分配到不同的仓库,因此这种逻辑必须通过代码明确体现出来。
如何将这些步骤整合起来
这三个步骤可以合并成一个函数。这个函数会接收模型提取出的文本字符串,然后返回对应的仓库名称或下一步需要执行的操作。只有那些已经被成功解析的输入数据,才会被传递给NIPOST进行处理。
import os

from ng_postcode import Postcode, Segment, parse
from ng_postcode.api import ApiError, lookup
from ng_postcode.client import Client, TransportError

DEPOTS = {"EK-01": "depot-a", "LA-05": "depot-b"}  # 这些都是虚构的名字


def dispatch(text: str, client: Client) -> str:
    code = parse(text)
    if not isinstance(code, Postcode):
        return f"请用户重新输入:{code}"
    match client.send(lookup(code, level=1)):
        case ApiError() | TransportError() as failure:
            return f"请稍后再试:{failure}"
        case found if not found.valid:
            return f"请用户重新输入:{code}未对应任何具体的建筑物"
        case _:
            return DEPOTS.get(code.prefix(Segment.LGA), "national-sorting")


with Client(api_key=os.environ["NG_POSTCODE_API_KEY"]) as client:
    for text in ["100001", "ek 01 a03 fk 01"]:
        print(dispatch(text, client))
请用户重新输入:预期应包含11个字母和数字,但实际只检测到了6个。
请用户重新输入:EK-01-A03-FK-01未对应任何具体的建筑物。函数的每个返回值都会说明接下来应该做什么:是要求用户重新输入信息、还是需要重试操作,又或者是告知用户该地址对应的仓库名称。模型仅负责提供text这个参数,其他工作都不需要它参与。如果想在提示信息中包含建议的修正内容,可以使用前面章节中介绍的gate函数来代替parse函数。
如何为代理提供带有限制功能的工具
当代理确实需要直接处理邮政编码时,应该为它们提供有明确使用规定的工具,就像为微服务编写文档一样。默认情况下,ng-postcode-mcp服务器会通过模型上下文协议提供五种工具,而且这些工具可以与任何MCP客户端配合使用。
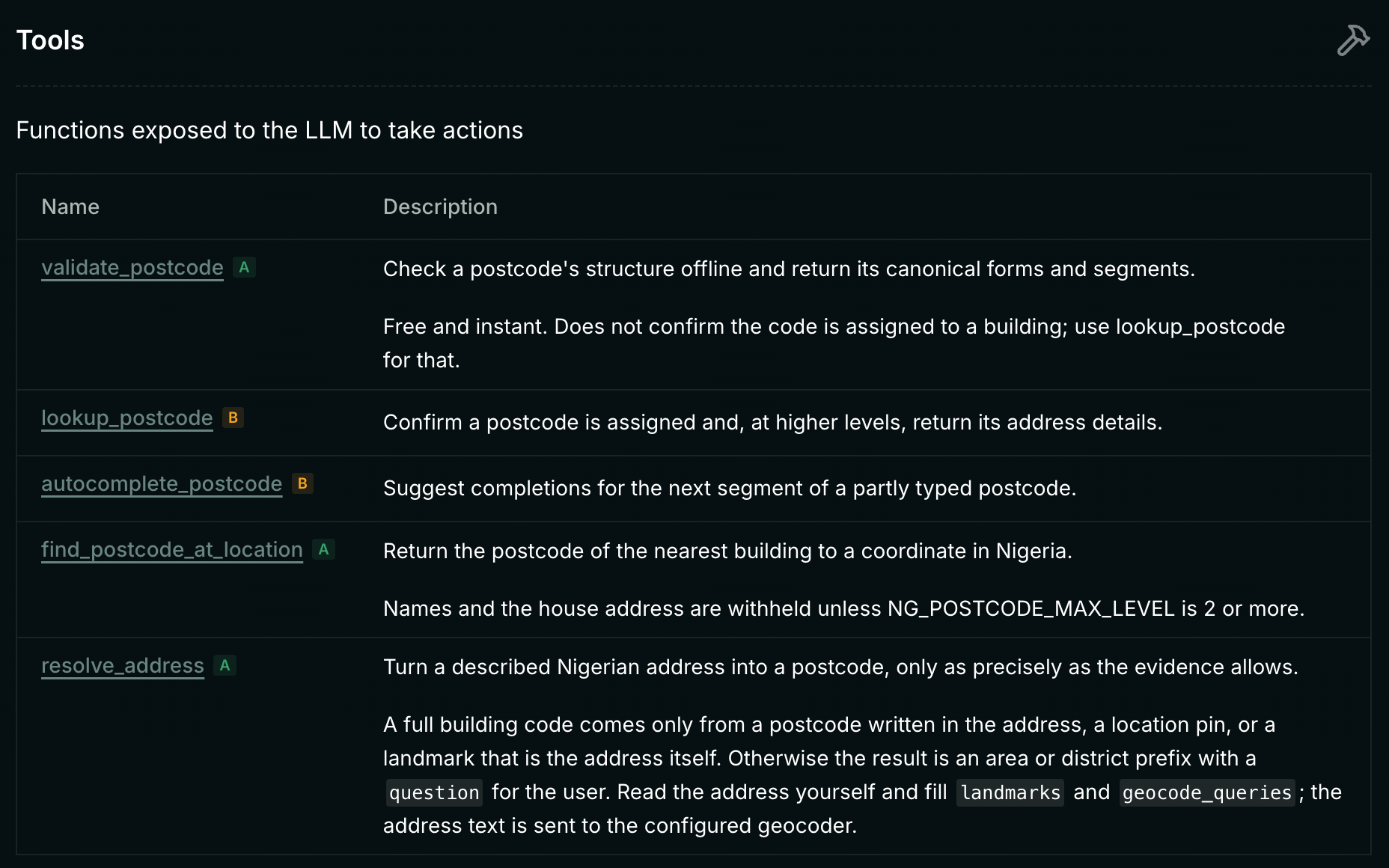
这里展示了作为MCP客户端所看到的五个默认工具,这些信息来自Glama的目录列表。
{
  "mcpServers": {
    "ng-postcode": {
      "command": "uvx",
      "args": ["ng-postcode-mcp"],
      "env": { "NG_POSTCODE_API_KEY": "nipost_live_..." }
    }
  }
}
| 工具 | 使用的网络接口 | >是否需要密钥 | >费用 |
|---|---|---|---|
validate_postcode |
无 | 不需要 | >免费 |
lookup_postcode |
NIPOST | 需要 | 免费,始终使用一级服务 |
autocomplete_postcode |
NIPOST | 需要 | >免费 tier |
find_postcode_at_location |
NIPOST | 需要 | >免费 tier |
resolve_address |
NIPOST以及地理编码服务 | 需要 | >免费 tier |
lookup_postcode_details |
NIPOST | 需要 | >每次调用都需要消耗信用点数;只有当NG_POSTCODE_MAX_LEVEL设置为2或更高时,才能使用此功能 |
该服务器会执行三项限制规定,因此这些限制会约束模型所能执行的操作:
这五个默认工具均为只读模式。
密钥是从环境变量中获取的。它永远不会作为工具的参数被传递给模型,因此模型无法看到这个密钥,也无法重复使用它。
需要付费才能使用的功能属于第六个工具
lookup_postcode_details,只有当您将NG_POSTCODE_MAX_LEVEL设置为2或更高时,服务器才会允许使用这个功能。
当使用二级服务时,系统会返回房屋地址,并且会消耗信用点数。在默认配置下,模型并没有可以执行此操作的工具:lookup_postcode仅支持一级服务;而调用付费工具时会收到如下回复:
未知工具:lookup_postcode_details当您提高信用点数的上限时,付费工具就会正常可用,且不会再显示“只读”提示。因此,即使客户端默认使用的是只读工具,在消耗信用点数之前也会先请求用户的确认。此外,如果连续25次使用付费功能,服务器也会停止提供服务,除非您将NG_POSTCODE_MAX_PAID_CALLS的值设置得更高。如果请求次数超过了上限,系统会返回如下回复:
当前等级3超出了该服务器允许的2次限制。二级及以上服务需要消耗NIPOST信用点数;用户可以将NG_POSTCODE_MAX_LEVEL设置得更高以便继续使用这些功能。这种权限设置是由用户自行配置的,任何提示都无法更改这一设置。
如何处理各种失败情况
假设模型可能会生成错误的邮政编码,密钥可能会过期,网络连接也可能会出现故障。下表列出了各种失败情况、检测这些情况的组件以及代理程序会接收到的响应信息。所有示例数据均来自服务器0.6.2版本的测试记录,记录时间为2026年10月13日。
| 状态 | 检测工具 | >检测结果 |
|---|---|---|
| 旧的六位编码 | 解析器,在线离线均可检测 | 应包含11个字母和数字,但实际上只检测到6个 |
| 超出范围的代码段 | 解析器,在线离线均可检测 | 无效的邮政编码区域代码段 |
| 相似的错误输入被发送至查询系统进行验证 | 服务器,在进行任何网络请求之前会先进行检测 | 'EK-O1-A03-FK-01'不是有效的邮政编码:无效的邮政编码区域代码段。您是指EK-01-A03-FK-01吗?请先与用户确认。 |
| 格式正确,但从未被分配过用途 | NIPOST系统 | "valid": false, "status": "not_found" |
| 未配置API密钥 | 服务器 | 该工具需要NIPOST的API密钥 |
| 提供的密钥被拒绝 | NIPOST系统 | 无效的API密钥(401错误),同时会提示在哪里创建新的密钥 |
级别大于1的代码会被发送至lookup_postcode函数进行验证 |
服务器 | 输入的级别应小于或等于1 |
| 超过服务器允许的最大级别 | 服务器 | 会显示相应的错误提示信息 |
| 密钥的级别不足 | NIPOST系统 | 级别未达到要求(403错误) |
| 无法访问API | HTTP客户端 | 无法连接到NIPOST API:所有连接尝试均失败 |
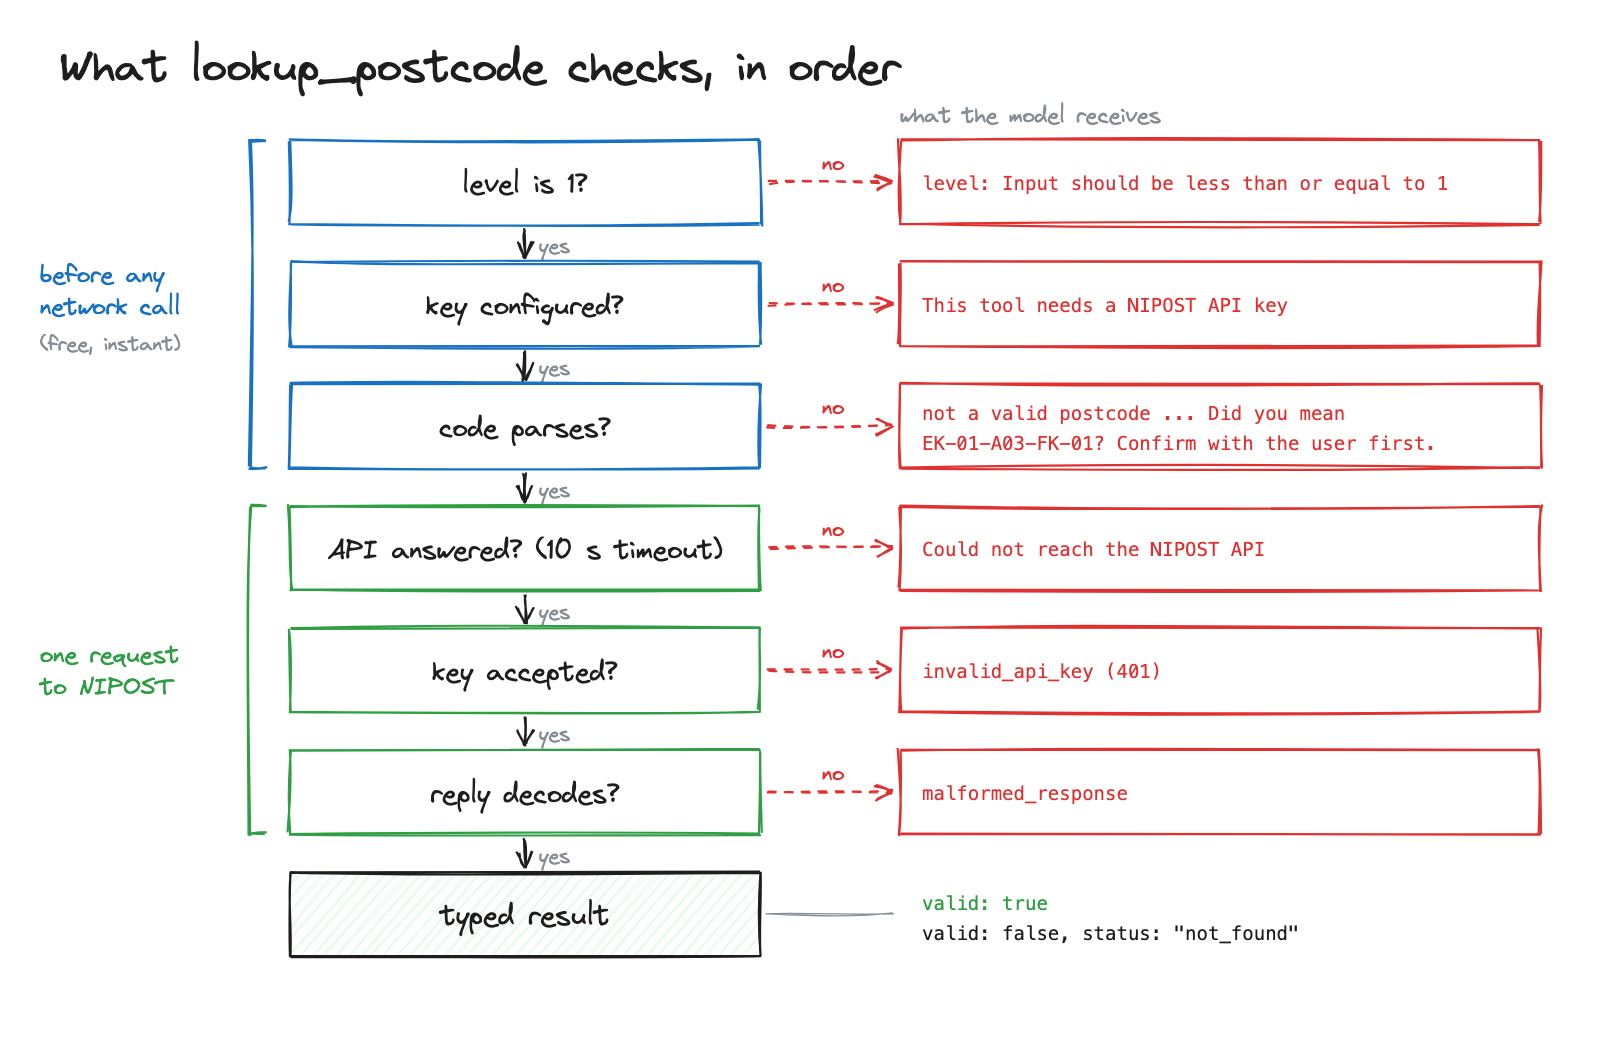
这些检测步骤是按此顺序进行的,其中前三项检测不会产生任何费用,因为它们在发送任何请求之前就已经完成。
第三行的情况属于相似的错误输入。服务器找到了一个可能的正确答案,但并未采用它,也没有向NIPOST系统发送查询请求,而是要求模型与用户进行确认。如果系统直接使用了错误的代码进行后续处理,就会返回一个用户从未提及的建筑的真实地址。
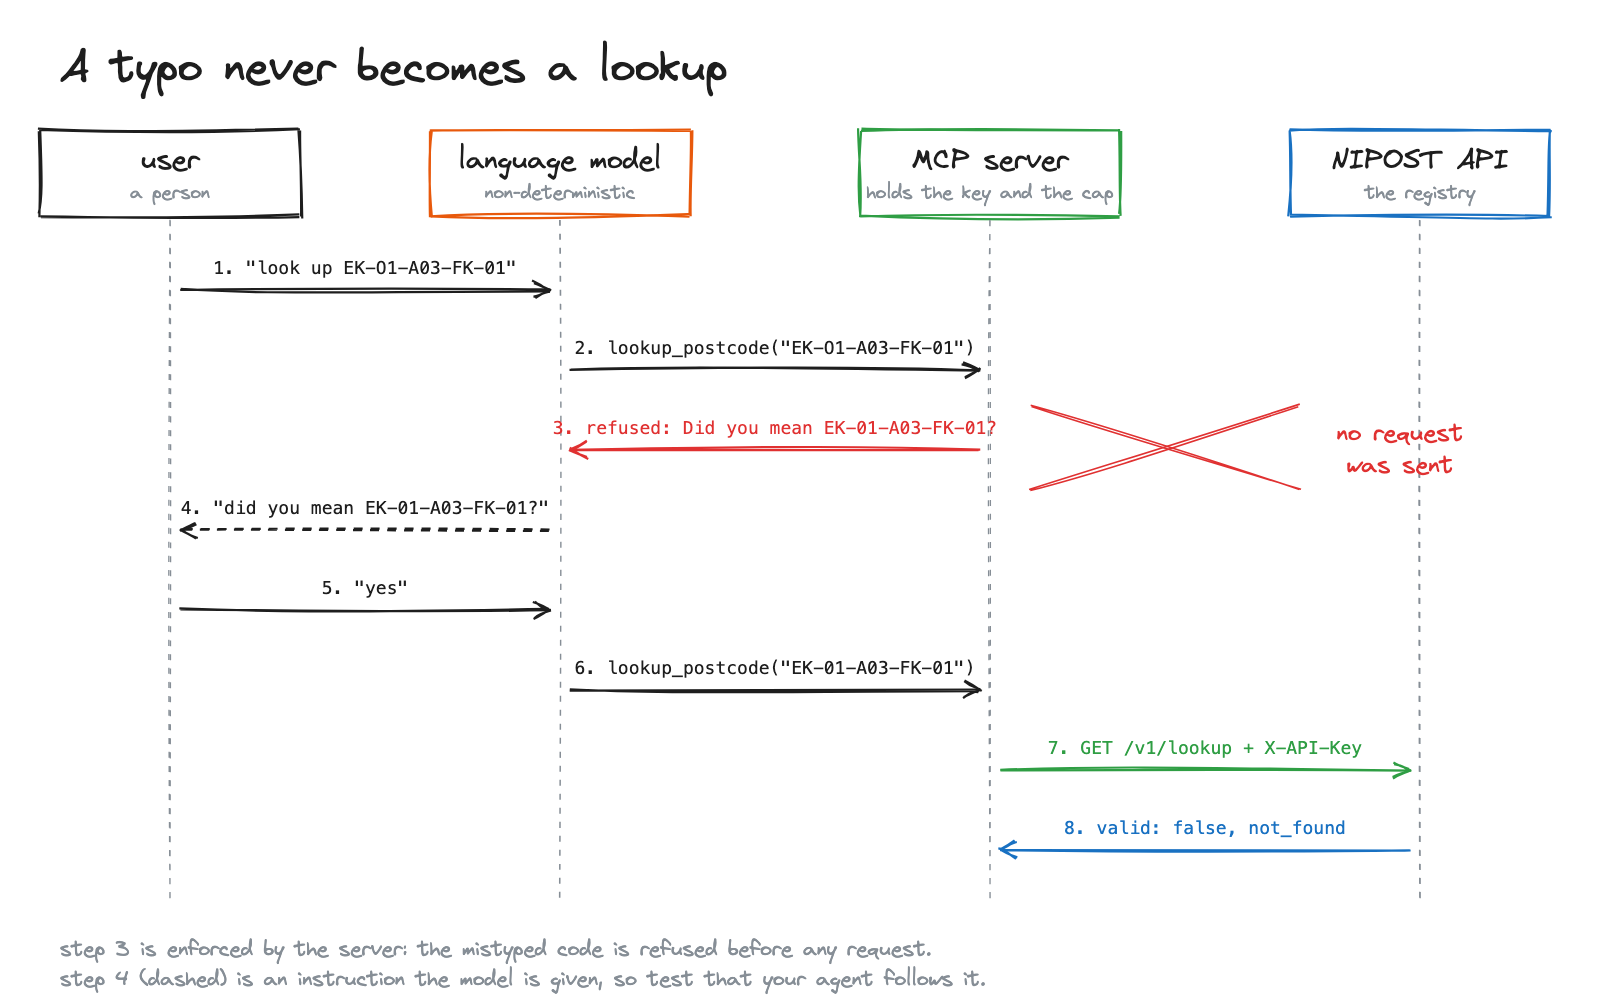
任何请求在发送之前,如果代码输入有误,系统都会直接拒绝该请求;只有当用户确认代码正确后,修正后的代码才会被提交到NIPOST系统中。
第四行所示的是那些“虚假的代码”。某些模型能够生成符合所有格式规则、但实际上并不属于任何建筑物的代码,而离线验证系统会接受这些代码。唯有注册系统才能区分这两种代码,因此对于所有一级地址码,都必须要进行仔细核对。
HTTP客户端通过三种方式来保护每一项请求:首先,它为整个通信过程设置了10秒的时间限制,这样一旦连接出现故障,该连接就不会占用代理程序的响应资源;其次,它不会跟随重定向链接,因为重定向链接可能会将用户的密钥传输到其他服务器上;最后,出于同样的原因,它也会拒绝使用纯http://格式的URL地址,除非是在用户自己的机器上。
如何解码你无法信任的回复
对于API返回的响应,也需要保持同样的警惕。如果代理程序直接读取响应内容,它总能找到办法来解读接收到的数据。不过,这个库将这项工作分成了两个步骤:lookup函数会将请求信息转换为普通数据格式,而decode函数则会根据状态码和响应内容,生成相应的结果或错误信息。你可以在没有网络连接的情况下测试这些功能。
from ng_postcode import Postcode, parse
from ng_postcode.api import ApiError, decode, lookup

code = parse("EK-01-A03-FK-01")
assert isinstance(code, Postcode)
request = lookup(code)

replies = [
    (200, '{"data": {"postcode": "EK-01-A03-FK-01", "valid": false, "status": "not_found"}}'),
    (200, '{"data": {"postcode": "EK-01-A03-FK-01"}}'),
    (401, '{"error": {"code": "invalid_api_key", "message": "提供的API密钥无效或已被吊销"}}'),
    (502, "Bad Gateway")
]
for status, body in replies:
    match decode(request, status, body):
        case ApiError() as error:
            print("error:", error)
        case found:
            print("assigned:", found.valid)
assigned: False
error: malformed_response (200): 数据格式错误
error: invalid_api_key (401): 提供的API密钥无效或已被吊销
error: malformed_response (502): 数据不是JSON格式:预期值应在第1行第1列在第二个示例中,响应内容的格式是有效的JSON,状态码也为200,但valid字段缺失。如果使用普通的解码器,它会将这个缺失的字段视为false,从而认为该建筑物不存在;而这个库会报告响应内容格式错误,因此缺失的字段根本不会被用来判断建筑物的存在与否。无论这个库是用Rust、Python、JavaScript还是Java实现的,所有版本都会使用相同的测试用例来进行验证。
这并不能解决什么问题
即使是一个有效且已被分配给特定用户的邮政编码,也有可能是错误的。如果用户输入了邻居的邮政编码,那么本文中提到的所有检查步骤都会通过;但要确认这个编码确实属于当前的用户,还需要其他的验证方式,比如向用户展示该编码所对应的实际地址。
仅凭文字描述往往无法确定具体是哪栋建筑。例如“法比安酒店后面,NTA路旁”这样的描述其实只是指一个区域,而resolve_address工具在仅有这些信息时,只会给出该区域的名称,并向用户提出进一步确认的问题。如果需要确定具体的建筑位置,就应该请求获取精确的地址信息。
地址属于个人数据:进行二级查询时得到的结果通常是住宅地址,因此处理这类数据时应遵守尼日利亚的数据保护法规,除非确实有需要,否则查询层次应限制在一级即可。
结论
在这个系统中,模型是最不可靠的部分,因此应该让它承担最简单的任务——也就是提取文本信息。解析器可以免费检查数据的结构是否正确,注册系统则能确认相应的建筑确实存在。而通过前缀来分类的数据,则由用户自己来决定如何处理这些信息。需要更正的地方会以问题的形式反馈给用户;而那些涉及费用或可能泄露地址信息的操作权限,则应由专人来进行配置管理。
即使模型学会了新的数据格式,这种划分方式依然具有实用性。同样的设计原则也适用于地址系统、税号或账号号码等后续发生变化的情况,因为模型也需要在后期才能适应这些变化。
该代码采用MIT许可证进行开源发布,具体链接为:github.com/Adeniyikayodee/ng-postcode。请根据您使用的语言安装相应的库:
pip install ng-postcode       # Python
npm install ng-postcode-js    # JavaScript和TypeScript
cargo add ng-postcode         # Rust
对于Java来说,对应的Maven依赖项是io.github.adeniyikayodee:ng-postcode-api。如果该库在处理地址信息时出现了错误,请随时提交问题进行反馈。
相关文章
如何使用Next.js、Supabase以及TypeSafe Jev来构建一个用于筛选人工智能相关简历的工具
每当我们发布一份工程招聘启事时,一周内就会收到300到400份简历。仔细阅读每一份简历大约需要两分钟的时间。因此,仅仅为了处理一个职位空缺,我们在开始任何面试之前就已经要花费11个小时来处理这些简历了。 但实际上,并没有人会真的去阅读每一份简历。相反,人力资源部门会进行快速的筛选工作。他们会快速浏览应聘者的职位名称、工作经验年限以及所掌握的技术框架,然后在大约15秒的时间内,将简历分为“需要进一步查看”和“可能不符合要求”两类。当他们看到第40份简历时,他们对这份简历的关注程度就已经远远低于对第4份简历时的关注了。 我们的目标就是取代这种快速筛选的过程,而不是放弃阅读简历这一环节。当阅读简历确
阅读全文
如何在数据传输流程中对个人身份信息进行加密,同时确保这些信息仍可被检索到
在Intuit,我的团队构建了一个数据处理流程,用于处理TurboTax电子申报系统中产生的数据。这些数据需要被用于制作仪表板、进行分析,以及满足其他后续使用需求。 其中最大的挑战之一就是如何保护那些属于 个人身份信息 的数据,比如社会安全号码。这类信息具有极高的敏感性,因此在数据处理的每一个环节都必须得到妥善保护。与此同时,分析团队有时也需要进行一些正常的业务操作,例如识别与特定客户相关的记录,或者进行精确匹配查询。 那么,如何在保证这些敏感信息不被泄露的同时,允许人们对这些数据进行受控的搜索呢?在本文中,我将解释解决这一问题所涉及的加密技术原理,包括以下内容: 概率加密与确定性加密 对加密
阅读全文
如何打破人工智能编程代理的循环机制
你很可能已经看过这样的情景:在使用人工智能编码工具构建的应用程序中,出现了某些故障。你让这个工具去修复这些问题,它似乎也“修复”了它们,但实际上错误依然存在,或者又出现了新的问题。 于是你会说“还是不行”。工具会再次尝试修复。二十分钟后,你会发现代码中的错误更多了,可用的功能也更少了,而且完全不知道该如何让应用程序恢复到正常状态。 人们常常用“人工智能反而使问题更加严重”或者“工具陷入了无限循环的修复模式”这样的表述来描述这种情况。这并不是某个特定产品的缺陷,像Replit、Cursor、Claude Code、Base44这类工具都会出现同样的问题,因为这种故障的本质是系统性的。 本教程将解
阅读全文
如何向英国税务海关总署的“数字化纳税”API提交季度更新报告
每年有四次,所有参与“税收数字化”计划的个体经营者和房东都必须向英国税务海关总署提交一份收入与支出的汇总报表。 2026-27纳税年度的第一个截止日期是8月7日,这个期限已经过去;第二个截止日期则是11月7日。每份汇总报表都需要通过软件向英国税务海关总署发送一次API请求,而本教程正是专门讲解如何正确完成这些请求操作的。 您无需事先阅读任何其他资料即可跟随本教程进行操作。每次进行“税收数字化”集成时所需的一次性设置信息(包括沙箱应用程序、OAuth 2.0访问令牌以及防欺诈相关配置)已在下方的简要总结中列出,同时每段代码示例中也都会使用到一些辅助函数。 如果您想深入了解这些设置步骤,我曾在 之
阅读全文