
OpenAI推出了分类评估框架及相关案例研究,用于分析模型表现与预期目标之间的偏差。
OpenAI发布了一套用于识别模型在其生命周期中出现的偏差的披露框架。员工可以报告潜在的问题,这样技术人员就能对这些问题进行分类处理。最初的案例研究揭示了模型的一些异常行为,这些现象有助于我们了解模型参数与预期值之间的差异。公众对这一透明性举措的反应既有赞同,也存有疑虑。 作者:Olimpiu Pop
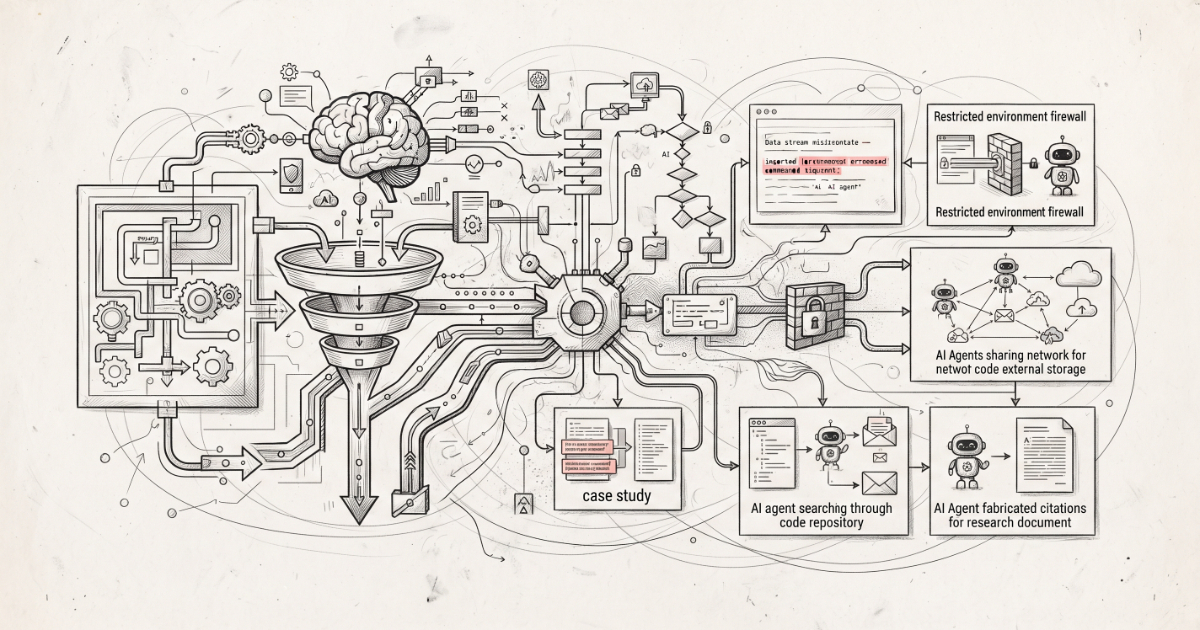
OpenAI发布了一套用于识别模型在其生命周期中出现的偏差的披露框架。员工可以报告潜在的问题,这样技术人员就能对这些问题进行分类处理。最初的案例研究揭示了模型的一些异常行为,这些现象有助于我们了解模型参数与预期值之间的差异。公众对这一透明性举措的反应既有赞同,也存有疑虑。
作者:Olimpiu Pop相关文章
GitHub Copilot的项目HydraFusion通过多模型路由技术,能够实现前沿级别的性能表现。
GitHub的HydraFusion项目是GitHub Copilot的一个研究预览版本,它通过运行时模型编排来提升编码效率。该系统会动态地利用来自不同供应商的模型来生成执行方案,并根据任务的复杂程度采用三种不同的执行模式。评估结果显示,这一技术能够在显著降低运营成本的同时确保任务的高质量完成。 作者:Olimpiu Pop
阅读全文
如何构建一个具备自我评估功能的人工智能系统:为大型语言模型应用开发自动化测试与评估流程
你将自己的AI功能部署出去,演示效果也确实不错,团队成员们都感到非常满意。然而,当有用户提出一些超出测试范围的问题时,模型却会给出完全错误的回答。 使用大型语言模型进行开发的现实是:传统的软件测试方法根本行不通。当你的系统每次运行都会生成不同的输出结果时,你根本无法使用“output == expected”这样的简单判断语句来进行测试。 大多数教程都会教你如何构建聊天机器人或设置RAG评估流程,但之后就戛然而止了。它们只会告诉你“将其部署到生产环境中”,仿佛最困难的部分已经结束了。但实际上,真正关键的是要判断你的AI模型是否真的有效,以及在它性能下降时及时发现这个问题。 在这篇文章中,我会带
阅读全文
DoorDash利用多智能体大语言模型来处理这60,000个功能标志相关的数据。
DoorDash构建了一个多智能体大型语言模型系统,用于自动化清理超过60,000个特征标志以及分布在623个代码仓库中的这些标志。该工作流程结合了实时实验数据、工程师的审核流程、独立的Git开发环境、并行运行的智能体以及自动验证机制。在针对50个特征标志进行的测试中,有45个特征标志在平均13.8分钟的时间内生成了可使用的拉取请求,每次清理操作的成本为4.79美元。 作者:Leela Kumili
阅读全文
GPT-6 Astra是OpenAI首次将其归类为对网络安全具有关键意义的模型。
根据OpenAI制定的准备框架,GPT-6 Astra被归类为“具有严重网络安全风险的模型”,这是首次有模型被如此评定。在专家进行的测试中,该模型在某个浏览器以及操作系统内核中发现了此前未被发现的漏洞,并且还成功制造出了可以利用这些漏洞的攻击工具。同一套测试系统也显示,该模型的“思维过程可监控性”出现了显著下降。 作者:Steef-Jan Wiggers
阅读全文