
《营销中的Python:营销分析、自动化及数据驱动发展的实用指南》[完整书籍]
市场营销一直以来都涉及处理大量的数据。在数字营销出现之前,企业必须追踪销售情况、顾客的购买行为、优惠券的使用情况、店铺的客流量以及调查问卷的反馈结果,才能了解顾客的需求。 虽然数字营销并没有发明市场分析技术,但它确实大大增加了可获取的信息量。 如今,几乎每一次互动都会产生数据。一个人可能会看到一则广告,点击它,访问一个网站,阅读一篇文章,订阅邮件列表,打开几封邮件,将某件商品加入购物车,然后离开网站,之后又通过搜索引擎重新回到该网站,最终完成购买。而所有这些互动都可能成为有价值的数据。 对于市场营销人员来说,这无疑带来了巨大的机会,但同时也带来了一个问题:拥有更多的数据并不一定能帮助人们做出更
市场营销一直以来都涉及处理大量的数据。在数字营销出现之前,企业必须追踪销售情况、顾客的购买行为、优惠券的使用情况、店铺的客流量以及调查问卷的反馈结果,才能了解顾客的需求。
虽然数字营销并没有发明市场分析技术,但它确实大大增加了可获取的信息量。
如今,几乎每一次互动都会产生数据。一个人可能会看到一则广告,点击它,访问一个网站,阅读一篇文章,订阅邮件列表,打开几封邮件,将某件商品加入购物车,然后离开网站,之后又通过搜索引擎重新回到该网站,最终完成购买。而所有这些互动都可能成为有价值的数据。
对于市场营销人员来说,这无疑带来了巨大的机会,但同时也带来了一个问题:拥有更多的数据并不一定能帮助人们做出更好的决策。
一家企业可能拥有数十万条客户记录,却仍然不知道哪些客户才是最宝贵的;一个营销团队可能配备了几十个数据分析工具,但却依然难以回答诸如“我们应该把更多的资金投入到哪项营销活动中”这样的简单问题。
这时编程技术就显得非常有用了。Python为市场营销人员提供了一种通过编程方式处理数据的方法。你不必再手动打开电子表格、复制公式、筛选数据,也不必每周都重复编写同样的报告,而是可以构建一些可重复使用的程序来自动完成这些任务。
更重要的是,Python不仅能用于生成简单的报告,还能帮助你分析顾客的行为模式、进行统计分析、建立预测模型、自动化工作流程,甚至构建能够将原始的市场营销数据转化为有用信息的系统。
这并不意味着每个市场营销人员都需要成为一名软件工程师,只是说明编程可以成为他们工具箱中的另一件利器,而本教程会向你解释如何使用它。
先决条件
阅读这本书并不要求你具备丰富的编程经验或市场营销知识,但掌握一些基础知识会让你更容易理解书中的示例。
- 安装了Python的电脑:请使用最新版本的Python 3。如果你是Python新手,VS Code或PyCharm这样的编辑器可以帮助你运行示例代码。
- 基本的计算机操作和文件管理能力:你应该能够熟练地打开文件、创建文件夹,并能使用CSV或Excel格式的电子表格。
- 愿意学习Python的基础知识: 本书的第一部分会介绍变量、字符串、数字、条件语句、循环结构以及函数等内容,因此具备一定的Python基础会有帮助,但并不是必须的。
- 对市场营销概念有一定的了解: 书中会用到“营销活动”“转化率”“收入”“点击量”和“广告支出”等术语,你可以在学习的过程中逐步了解这些概念。书中的关键术语会在相关章节中进行解释。
- 具备安装软件包的能力: 后面的章节会使用pandas、NumPy、Matplotlib、scikit-learn和requests等库,示例中会说明如何安装这些软件包。
你可以使用示例数据来学习这本书中的内容。你不需要访问公司的客户隐私数据或付费营销API。如果你使用真实数据,请确保自己拥有使用这些数据的权限,并避免泄露任何个人或机密信息。
本书将教你什么
这本书主要围绕三个核心理念进行讲解:
- 营销分析:利用数据来了解具体发生了什么以及原因何在。
- 营销自动化:使用Python来更高效地完成重复性的营销任务。
- 营销智能:结合数据、分析结果、自动化技术及预测方法,以辅助做出更好的决策。
你将从学习Python的基础知识开始,逐步深入到更高级的应用领域。
最终,你将构建一个整合了这些概念的营销智能系统。
本书的内容涵盖以下方面:
- 第一部分:营销人员必备的Python基础知识
- 第二部分:如何处理营销数据
- 第三部分:使用pandas进行数据清洗与分析
- 第四部分:营销数据的可视化展示
- 第五部分:客户分析与活动效果评估
- 第六部分:营销自动化应用
- 第七部分:利用机器学习优化营销策略
- 第八部分:构建营销智能系统
- 顶点项目:开发Python营销智能平台
- 结论与后续步骤
本书的编写理念
学习Python与学会运用Python是有着本质区别的。
学习Python意味着理解语法、数据类型、函数、循环结构、库以及各种编程概念;而运用Python则是指将这些概念应用到实际问题中。
本书着重强调后一种学习方式。
你仍然会学习Python的基础知识,但书中的示例会不断将这些基础知识与营销实践联系起来。
我们不会只是简单地编写这样的代码:
x = 10
y = 20
print(x + y)
而是会使用像这样的例子:
campaign_budget = 10000
campaign_spend = 7350

remaining-budget = campaign_budget - campaign_spend

print(remaining_budget)
编程的概念是相同的,但应用的环境不同。
正是这种环境使得这些技能具有实际意义。
第一部分:营销人员必备的Python基础知识
Python并不了解什么是广告活动,也不明白什么是客户;它更不知道某则广告是否取得了成功。Python只会执行你赋予它的指令而已。
因此,你的首要任务就是学习如何与计算机进行沟通。
幸运的是,在开始处理营销数据之前,你并不需要掌握Python的所有知识,但至少需要具备一些基础技能。
budget = 10000
spent = 7350
remaining = budget - spent
print(remaining)
输出结果为:
2650
计算机并不需要理解营销相关的概念,它只需要按照指令来操作即可。
这就是你与编程语言之间的基本关系:你提供指令,Python会将这些指令转化为计算机能够执行的操作。
加载广告数据。
清洗数据。
计算投资回报率。
计算转化率。
筛选出那些低于设定标准的广告活动。
显示结果。
Python就可以将这些步骤转化为具体的代码。
这种思考方式被称为“分解法”,在本书中你会经常用到这种方法。
第一章:学习并掌握基础知识
campaign = "返校季活动"
budget = 5000
clicks = 1250
conversions = 84
Python就可以将这些步骤转化为具体的代码。
这种思考方式被称为“分解法”,在本书中你会经常用到这种方法。
第一章:学习并掌握基础知识
campaign = "返校季活动" budget = 5000 clicks = 1250 conversions = 84
现在,Python已经知道了以下内容:
campaign这个变量包含文本。budget这个变量包含一个数字。clicks这个变量包含一个数字。conversions这个变量包含一个数字。
以后你可以使用这些变量了。
print(campaign)
print(budget)
print(clicks)
print(conversions)
你也可以更改这些变量的值。
budget = 5000
budget = 7500
print(budget)
最终得到的值是:
7500变量的作用在于:营销活动所涉及的数值经常会发生变化。
今天的收入与昨天的不同,这个月的广告预算也不同于上个月。顾客的购买次数会随着他们的消费行为而改变,而一场营销活动的效果也会随时间而变化。
变量能让你的程序能够准确地表示这些变化的数值。
清晰地为变量命名
从技术上来说,你可以这样写:
x = 5000但是x代表什么意思呢?你得去其他地方才能弄清楚。
一个更好的做法是:
campaign_budget = 5000这样的命名能立刻让人明白这个变量的用途。
同样地,
total_revenue = 25000
total_cost = 8000
total_conversions = 450
清晰的变量命名能让你的代码更易于理解。随着程序规模的扩大,这一点会变得越来越重要。
字符串
字符串用于表示文本。
campaign_name = "假日促销活动"
channel = "电子邮件"
customer_name = "Ava"
你可以将多个字符串组合起来使用,例如:
message = "欢迎," + customer_name
print(message)
输出的结果是:
欢迎,Ava不过,使用f-string通常会让代码更易读。
message = f"欢迎,{customer_name}!"
print(message)
你还可以在字符串中包含多个变量:
customer_name = "Ava"
discount = 20

message = (
    f"嗨,{customer_name},"
    f"您可以享受{discount}%的折扣。"
)
print(message)
在生成个性化的营销信息时,这种方法尤其有用。
数字
Python支持整数和浮点数。
整数是指没有小数的数字:
customers = 1500浮点数则包含小数部分:
conversion_rate = 4.75你可以对数字进行各种数学运算。收入 = 15000
成本 = 5000
利润 = 收入 - 成本
print(利润)
你也可以进行乘法运算:
平均订单金额 = 75
订单数量 = 120

收入 = 平均订单金额 * 订单数量

print(收入)
还可以进行除法运算:
收入 = 12000
订单数量 = 150

平均订单金额 = 收入 / 订单数量

print(平均订单金额)
这些基本运算构成了许多营销指标的基础。
百分比
在营销分析中,百分比被广泛使用。
假设在10,000次广告展示中,有500人点击了广告。
那么点击率就是:
点击次数 = 500
广告展示次数 = 10000

点击率 = 点击次数 / 广告展示次数 * 100

print(点击率)
计算结果为:
5.0你也可以这样格式化输出结果:
print(f"点击率:{点击率:.2f}%")其中`.2f`表示让Python显示两位小数。
布尔值
布尔值表示两种状态:
True
False
例如:
活动是否进行中 = True你可以在条件判断中使用布尔值。
活动是否进行中 = True

if 活动是否进行中:
    print("活动目前正在进行中。")
当程序需要做出决策时,布尔值会变得特别有用。
比较运算符
在营销领域,人们经常会比较的一个指标是广告支出回报率(ROAS)。ROAS用于衡量广告所带来的收入与为此投入的广告费用之间的比例:
ROAS = 广告带来的收入 ÷ 广告费用
例如,如果一个广告活动花费了1,000美元,而由此带来了4,000美元的收入,那么它的ROAS就是4.0,也就是说每投入1美元的广告费用,就能获得4美元的收入。
需要注意的是,ROAS与利润并不相同,因为它不会自动扣除产品成本、代理费或其他业务开支。选择合适的评估指标取决于企业的盈利空间和目标。
roas = 4.2

print(roas > 3)
计算结果为:
True其他比较运算还包括:
roas == 3
roas != 3
roas >= 3
roas <= 3
通过这些比较运算,你可以构建各种规则。
if roas >= 3:
    print("活动表现良好。")
组合条件判断
在营销决策中,往往需要同时考虑多个条件。
假设当ROAS高于3且转化率高于4%时,某个营销活动就被认为具有较好的效果。
roas = 3.8
conversion_rate = 5.2

if roas >= 3 and conversion_rate >= 4:
    print("该营销活动符合性能标准。")
“and”运算符要求两个条件都必须为真。
你也可以使用“or”运算符:
if roas >= 4 or conversion_rate >= 6:
    print("该营销活动至少有一个表现良好的指标。")
这些简单的逻辑运算符在创建自动化营销规则时非常有用。
列表
列表可以存储多个值。
channels = [
    "电子邮件",
    "搜索",
    "社交媒体",
    "展示广告"
]
你可以通过元素的索引来访问它,例如:
print(channels[0])
电子邮件Python使用从0开始的索引系统,因此第一个元素的索引是0。
你也可以向列表中添加元素:
channels.append("联盟营销"
你可以查看列表中包含多少个元素:
print(len(channels)
5列表非常适合用来存储各种营销相关信息。
字典
字典以键值对的形式存储信息。
campaign = {
    "名称": "节日促销活动",
    "推广渠道": "电子邮件",
    "预算": 5000,
    "转化数量": 125
}
你可以获取字典中的某个值:
print(campaign["推广渠道"])
你也可以更新字典中的值:
campaign["预算"] = 7500
7500当需要表示某个特定的客户、营销活动、产品或事件时,字典会非常有用。
例如:customer = { "名称": "Ava", "年龄": 24, "购买记录": 7, "总消费金额": 850 }print(customer["总消费金额"])字典列表
当你将列表和字典结合起来使用时, things会变得更加有趣。
campaigns = [ { "名称": "春季促销活动", "推广渠道": "电子邮件", "收入": 8500 }, { "名称": "夏季促销活动", "推广渠道": "社交媒体", "收入": 6200 }, { "名称": "节日促销活动", "推广渠道": "搜索广告", "收入": 12000 } ]['春季促销活动', '电子邮件', 8500], ['夏季促销活动', '社交媒体', 6200], ['节日促销活动', '搜索广告', 12000]现在你已经得到了多个营销活动的简单表示形式。
for campaign in campaigns: print(campaign["名称"])春季促销活动 夏季促销活动 节日促销活动这样就会得到如下结果:
春季促销活动 夏季促销活动 节日促销活动这就是开始使用结构化数据集合进行操作的标志。
循环
循环可以重复执行某项操作。
channels = [ "电子邮件", "搜索", "社交媒体", "展示" ] for channel in channels: print(channel)你也可以用循环来进行计算:
revenues = [5000, 7500, 9000, 6200] for revenue in revenues: print(revenue * 0.1)循环会依次处理列表中的每一个元素。
想象一下,如果你有10,000位顾客,你肯定不会想手动重复编写同样的操作10,000次吧?
循环能让Python自动处理每一条记录。在本书的后续章节中,你会看到pandas是如何让这种处理方式变得更加强大和高效的。
循环中的条件逻辑
你可以将循环与条件语句结合在一起使用。
campaigns = [ {"name": "春季促销活动", "roas": 2.5}, {"name": "夏季促销活动", "roas": 4.8}, {"name": "节日促销活动", "roas": 1.2} ] for campaign in campaigns: if campaign["roas"] >= 3: print(f"{campaign['name']}的表现非常好。)")只有那些满足条件的促销活动才会被打印出来。
从概念上来说,这和过滤营销数据集的操作是类似的。
函数
函数能够将一些可重复使用的逻辑代码封装起来。
假设你需要反复计算ROAS这个指标。那么,与其每次都重新编写同样的计算公式,不如创建一个函数:
roas = revenue / cost以后每次需要使用这个计算结果时,只需调用这个函数即可:
roas = calculate_roas(15000, 5000) print(roas)这样就可以重复利用同一个函数了。
例如:
campaign_one = calculate_roas(12000, 3000) campaign_two = calculate_roas(8000, 4000) campaign_three = calculate_roas(15000, 2500)这样写代码会整洁得多。
为函数添加验证机制
一个好的函数应该能够处理那些可能存在问题的输入数据。
举个例子:
def calculate_roas(revenue, cost): return revenue / cost如果
cost的值为0,会发生什么呢?Python会抛出错误,因为除以0是没有意义的。
一个更安全的写法是:
def calculate_roas(revenue, cost): if cost == 0: return None return revenue / cost现在,当
cost为0时,这个函数会返回None,而不会导致程序崩溃。当我们开始使用真实的数据集进行工作时,保护代码免受意外输入的影响这一理念就变得越来越重要了。
返回多个值
一个函数可以返回多个结果。
def campaign_metrics( revenue, cost, clicks, conversions ): if cost == 0: roas = None else: roas = revenue / cost if clicks == 0: conversion_rate = None else: conversion_rate = ( conversions / clicks * 100 ) return roas, conversion_rate你可以这样使用它:
roas, conversion_rate = campaign_metrics( 12000, 4000, 1000, 80 ) print(roas) print(conversion_rate)之后,我们会将这样的函数替换成可重用的分析模块,或者将其集成到这些模块中。
第2章:Python中的库
导入库
Python内置的功能确实非常有用,但进行市场分析时还需要额外的工具。
库提供了预先构建好的功能模块。
例如:
import pandas as pd这里的`as pd`为pandas指定了一个简短的别名。
现在你可以这样使用它:
pd.read_csv()而不用这样写:
pandas.read_csv()在所有的数据分析项目中,你都会遇到这种写法。
NumPy通常是这样导入的:
import numpy as npMatplotlib的绘图模块也通常是这样导入的:
import matplotlib.pyplot as plt安装库
如果某个库还没有被安装,可以使用pip来安装。
pip install pandas对于多个库来说,可以这样操作: pip install pandas numpy matplotlib scikit-learn requests openpyxl具体的安装步骤可能会根据你使用的Python环境而有所不同。 如果你使用的是虚拟环境,那么建议将项目所需的依赖库安装在该环境中,而不是全局安装。 虚拟环境
假设一个项目需要某个库的某个版本,而另一个项目则需要另一个版本。如果将所有库都全局安装,就很容易导致冲突。
虚拟环境可以为每个项目提供一个独立的Python运行环境。 你可以这样创建一个虚拟环境: python -m venv marketing-env在Windows系统中,可以这样激活它: marketing-env\Scripts\activate在macOS或Linux系统中,则可以这样操作: source marketing-env/bin/activate接下来安装所需的包:
pip install pandas numpy matplotlib scikit-learn你可以将所依赖的包保存为文件:
pip freeze > requirements.txt其他开发者可以通过以下命令来安装这些包:
pip install -r requirements.txt当你将自己的项目开发成果分享给他人时,这种方法会非常有用。
第二部分:处理营销数据
营销数据很少会以你期望的格式出现。这是你需要首先接受的一个事实。
电子表格中可能会存在缺失值,导出的报告中的大小写格式可能不一致,客户关系管理系统中使用的客户编号格式可能与广告平台使用的不同,日期的显示方式也可能各不相同,甚至数字可能被存储为字符串形式。
一个数据集看起来可能非常正常,但实际上其中可能存在一些细微的问题,从而导致分析结果出现错误。
在开始进行任何计算之前,首先要了解自己正在处理的是什么数据。
了解营销数据的生命周期
将营销数据分析视为一个生命周期过程,是一种很有帮助的思考方式。
- 首先收集数据。
- 然后存储这些数据。
- 接着对数据进行清洗。
- 随后对数据进行处理和转换。
>- 之后对这些处理过的数据进行分析。
- 最后将分析结果进行传达。
- 最终,有人会根据这些分析结果来做出决策。
Python几乎可以参与这个生命周期的每一个阶段。
例如,Python可以从API中获取数据,将其存储在DataFrame中,使用pandas对数据进行清洗,计算关键绩效指标,生成可视化图表,训练机器学习模型,以及导出报告。
正因为如此,随着你的营销工作流程变得越来越复杂,Python的价值也会随之增加。
结构化数据与非结构化数据
结构化数据是指那些被组织成可预测字段的信息。
例如,以下这种电子表格中的数据就是结构化数据:
customer_id date campaign channel revenue每一行代表一条记录,每一列代表一个变量。pandas特别擅长处理这类数据。
非结构化数据则不同。它的例子包括:
- 社交媒体帖文
- 客户评价
- 电子邮件内容
- 调查问卷的回复
- 图片
- 视频
Python也可以处理非结构化数据,但通常需要使用自然语言处理或计算机视觉等技术。
本书主要关注结构化营销数据,因为这类数据为数据分析、自动化操作以及机器学习的应用提供了坚实的基础。
行与列
假设你的数据集包含以下内容:
customer_id | channel | clicks | conversions | revenue
101         | Email   | 500    | 40          | 3200
102         | Search  | 800    | 65          | 5100
103         | Social  | 300    | 18          | 1400
每一行代表一条观测记录,而每一列代表一个属性。
理解这种区别非常重要,因为许多pandas操作都是在行之间、列之间或行组之间进行的。
分析单位
其中一个值得特别关注的概念就是分析单位。
试想:一行数据代表什么?它代表:
- 一位客户吗?
- 一次购买行为吗?
- 一项营销活动吗?
- 一则广告吗?
- 一次网站访问吗?
- 一封电子邮件吗?
- 一天中的某个时间段吗?
这个问题的答案非常重要。
假设你有一个数据集,其中每一行都代表一次购买行为。那么,一位进行了十次购买的客户就会在数据集中出现十次。
如果你只是计算行数,并将这个数字视为客户数量,那么你的分析结果就是错误的。
实际上,你应该关注的是唯一客户ID的数量。
df["customer_id"].nunique()在计算任何指标之前,都必须先明确分析单位是什么。
营销指标具有情境依赖性
假设A项营销活动的转化率为10%。
这个数字听起来很不错,但如果它只吸引了10位访客,最终只产生了一次转化呢?
现在再来看B项营销活动:它的转化率仅为4%,但却吸引了10万名访客,最终产生了4,000次转化。
仅看转化率这个数字是无法了解全部情况的。
正因如此,优秀的营销分析会考虑其他因素,比如:
- 数据量
- 转化率
- 成本
- 收入
- 盈利能力
- 客户质量
- 时间周期
- 业务目标
一个指标本身并不能代表答案,它只是一种证据。
第3章:处理CSV数据
CSV是指用逗号分隔的数据格式,它是交换表格数据最简单、最常用的方式之一。
假设文件campaigns.csv包含以下内容:
campaign,channel,impressions,clicks,conversions,cost,revenue
Spring Sale,Email,10000,850,120,500,6000
Summer Sale,Social Media,25000,1100,75,1200,4200
Holiday Sale,Search,18000,1400,180,2000,9500
如何加载这个文件呢?
import pandas as pd

df = pd.read_csv("campaigns.csv")
如果你想查看前五行内容,可以执行以下命令:
df.head()
如果想要查看前10行,可以使用:
df.head(10)
而要查看最后五行,则使用:
df.tail()
了解数据框的结构
使用方法:
df.shape你可能会得到如下结果:
(1000, 8)这意味着该数据框包含1,000行和8列。
这是了解你的数据集规模的最快捷方法之一。
查看列名
df.columns你可能会看到如下内容:
Index([
    'campaign',
    'channel',
    'impressions',
    'clicks',
    'conversions',
    'cost',
    'revenue'
], dtype='object')
如果你要编写可重复使用的代码,那么了解列名的具体内容是非常重要的。
选择某一列
选择一列:
df["revenue"]或者选择多列:
df[ [ "campaign", "revenue", "cost" ] ]这样你就可以创建数据集的子视图了。
选择行
你可以根据条件来选择行。
df[df["revenue"] > 5000]这样就能得到那些收入超过5,000美元的活动记录。
你也可以将多个条件结合起来使用:
df[ (df["revenue"] > 5000) & ( (df["cost"] < 3000) ]在结合pandas的条件时,括号非常重要,因为每个比较条件都需要被单独评估之后,pandas才会将结果合并起来。像
&和|这样的运算符,它们的优先级规则与Python普通的and和or不同,因此如果不使用括号,就很容易导致错误或产生不符合预期的结果。在过滤数据框时,每个条件都应该用单独的括号括起来,使用
&表示“与”,使用|表示“或”。# 选择点击次数超过1,000次 # 且转化率高于2%的活动记录 filtered_campaigns = df[ (df["clicks"] > 1000) & ( (df["conversion_rate"] > 0.02) ]在这里,只有当两个条件都满足时,该行才会被包含在
filtered_campaigns中。对数据进行排序
按收入排序:
df.sort_values( "revenue", ascending=False )这样收入最高的活动记录就会排在最前面。
按成本排序:
df.sort_values( "cost", ascending=True )你也可以按多列进行排序:
df.sort_values( ["channel", "revenue"], ascending=[True, False] )这种方法会先按照渠道对结果进行分组,然后再在每个渠道内按照收入进行排序。
第4章:使用Excel进行数据处理
许多营销部门仍然非常依赖Excel。
幸运的是,pandas使得操作Excel文件变得相对容易。
df = pd.read_excel( "marketing_data.xlsx" )你可以指定具体的工作表:
df = pd.read_excel( "marketing_data.xlsx", sheet_name="Campaigns" )你还可以使用以下方法查看可用的工作表:
excel_file = pd.ExcelFile( "marketing_data.xlsx" ) print(excel_file.sheet_names)在处理大型工作簿时,这种方法会非常有用。
将数据导出到Excel
你可以将DataFrame导出为Excel文件:
df.to_excel( "marketing_report.xlsx", index=False )如果你需要创建多个工作表,也可以这样做:
with pd.ExcelWriter( "marketing_report.xlsx" ) as writer: df.to_excel( writer, sheet_name="Data", index=False ) channel_summary.to_excel( writer, sheet_name="Channels" )在项目最终阶段,这种功能会变得非常重要,因为最终的系统需要生成结构化的营销报告。
第5章:日期与时间
营销效果在很大程度上取决于时间因素。
一个在六个月内创造了20,000美元收入的营销活动,与另一个在两天内就实现了同样收入的营销活动,其效果是截然不同的。
首先,需要将日期列转换为合适的格式:
df["date"] = pd.to_datetime( df["date"] )之后就可以提取日期中的各个组成部分了:
df["year"] = df["date"].dt.year df["month"] = df["date"].dt.month df["day"] = df["date"].dt.day你还可以提取月份的名称:
df["month_name"] = ( df["date"] .dt.month_name() )以及星期几的信息:
df["weekday"] = ( df["date"] .dt.day_name() )基于时间的营销分析问题
一旦日期格式正确,你就可以回答诸如以下这类问题:
- 哪个月份带来的收入最多?
- 哪个星期几的转化率最高?
- 在进行了某些具体调整之后,营销效果是否有所改善?
- 是否存在季节性变化吗?
- 顾客的购买频率是不是在降低?
例如:
monthly_revenue = (
    df.groupby(
        df["date"].dt.to_period("M")
    )["revenue"]
    .sum()
)
这样就能得到每个月的收入总额了。
第6章:使用营销API进行数据交互
当有人需要手动导出数据时,文件确实非常有用。但如果你希望自己的营销智能系统能够自动收集数据呢?
这时,API就显得非常重要了。
API,也就是应用程序编程接口,为不同的程序提供了一种结构化的通信方式。
例如,某个平台可能会提供一个用于获取活动信息的接口。
Python可以发送请求来获取这些信息:
import requests

response = requests.get(
    "https://example.com/api/campaigns"
)

print(response.status_code)
如果请求成功,响应的状态码通常会是像200这样的数值。
你可以查看响应的内容:
print(response.text)如果响应中包含JSON格式的数据,你可以这样处理它:
data = response.json()然后就可以进一步分析这些数据了:
print(data)API认证
实际上,大多数API都需要进行认证才能使用。
例如:
api_key = "your-api-key"但是,你绝对不应该将真实的密钥直接写在那些需要公开共享的代码中。
应该使用环境变量来存储这些密钥。
import os

api_key = os.getenv(
    "MARKETING_API_KEY"
)
之后,你可以构造请求头:
headers = {
    "Authorization": f"Bearer {api_key}"
}
最后发送请求即可:
response = requests.get(
    "https://example.com/api/campaigns",
    headers=headers
)
具体的认证方式取决于所使用的API。
API错误处理
你的程序不应该假设所有的请求都会成功完成。
response = requests.get(
    api_url,
    timeout=30
)

if response.status_code == 200:
    data = response.json()
else:
    print(
        f"请求失败:"
        f"{response.status_code}"
    )
当你发送API请求时,收到响应并不一定意味着请求已经成功。服务器可能会返回一些错误状态码,比如404 Not Found或500 Internal Server Error。
raise_for_status()这个方法会检查HTTP响应的状态码。如果响应表明请求失败了,它就会抛出异常,而不是让程序继续执行,仿佛一切都很正常一样。
通过使用try...except块,你可以妥善处理这些异常:
import requests

try:
    response = requests.get(
        "https://example.com/api/campaigns",
        timeout=30
    )
    response.raise_for_status()
    campaigns = response.json()

except requests.exceptions.RequestException as error:
    print(f"无法获取活动数据:{error}")
requests.get()用于发送请求,timeout=30这一设置可以防止程序无限期地等待响应,而raise_for_status()则会在收到失败的HTTP响应时抛出异常。except块用于捕获与请求相关的错误,并显示相应的提示信息。
在实际的生产环境中,你应该记录这些错误,并决定是应该重试请求、跳过失败的数据源,还是停止报告的生成。切勿将失败的请求简单地视为空数据集,因为这样可能会导致生成的营销报告出现错误或误导性结果。
当你的系统是自动运行的时候,这一点尤为重要。如果某个API在凌晨3点发生故障,你肯定不希望程序默默地生成一份空白的营销报告,而是希望它能够及时报告这个问题。
API分页功能
有些API每次请求只能返回有限数量的记录。例如,如果一个账户中有数千条活动记录,那么API可能会返回前100条记录,并提供链接或令牌以便获取后续的数据。这种处理方式被称为分页。
分页的具体实现方式取决于所使用的API。有些服务使用页码来进行分页,有些则使用偏移量;还有一些服务会提供继续访问下一页的令牌或URL。在实施分页功能之前,务必查阅相关API的文档。
以下示例展示了一个返回results列表以及nextURL的API:
import requests
def fetch_all_campaigns(api_url, headers):
all_campaigns = []
next_url = api_url
while next_url:
response = requests.get(
next_url,
headers=headers,
timeout=30
)
response.raise_for_status()
payload = response.json()
all_campaigns.extend(payload["results"])
next_url = payload.get("next")
return all_campaigns
这个函数从初始的API地址开始请求数据,只要next_url还存在有效值,就会继续发送请求。extend()方法用于将每一页获取到的记录添加到同一个列表中。当API不再返回下一页的URL时,循环就会终止。
这只是一个示例性的实现方式,并非适用于所有情况的通用解决方案。你所使用的API可能会使用不同的字段名称,或者需要采用其他的分页机制。在实际进行集成开发时,务必遵循相关服务的文档说明,并考虑设置重试次数限制或最大页面数限制等安全措施。
API请求速率限制
许多API都会对客户端在特定时间段内可以发出的请求数量进行限制。这类限制被称为请求速率限制。例如,某些服务可能规定每分钟只能发送一定数量的请求。
如果你的营销自动化脚本发送的请求次数过多,API可能会返回HTTP429 Too Many Requests错误响应。因此,程序不应该立即反复发送请求,而应该根据服务的规则暂停一段时间后再尝试发送。某些API会提供Retry-After响应头,该头部指示客户端应等待多长时间。以下是一个简化的示例:
import time
import requests
def get_with_rate_limit(url, headers, max_retries=5):
for attempt in range(max_retries):
response = requests.get(
url,
headers=headers,
timeout=30
)
if response.status_code == 429:
retry_after = response.headers.get(
"Retry-After", "2"
)
time.sleep(float(retry_after))
continue
response.raise_for_status()
return response
raise RuntimeError(
"在连续收到速率限制响应后,API请求失败。"
)
当API返回429响应时,该函数会尝试有限次数的重试。如果响应中包含Retry-After头部,函数会使用该值来确定等待时间;如果没有这个头部,函数则会等待两秒钟。
这只是一个起点,并不是一个完整的生产环境中的重试系统。某些API采用不同的重试规则,因此生产环境中的系统还应该考虑临时服务器错误、日志记录、指数级退避策略以及防止过度重试的措施。在任何情况下,都应遵循API提供者的文档说明。
在跨多个活动或账户自动化处理数据报告时,速率限制机制尤为重要。遵守这些限制可以使你的集成方案更加可靠,从而降低数据收集过程中出现中断的风险。
第三部分:使用Pandas进行数据清洗与分析
市场分析的第一条原则应该很简单:在仔细检查数据集之前,千万不要相信其中的数据。
这并不是说你的数据有问题,而是意味着在进行分析并据此做出决策之前,你应该先验证这些数据的准确性。
一个数据集可能包含数百万条格式正确的记录,但这些记录仍然可能反映错误的信息。
第七章:检查数据质量
首先可以执行以下操作:
df.info()
这将显示以下信息:
- 记录总数
- 列名
- 缺失值的情况
- 数据类型
- 内存占用情况
你还可以使用:
df.describe()
这将提供数值型列的统计信息。
例如,你可能会发现如下结果:
revenue
count 1000
mean 5820
min -250
max 85000
如果出现负数的最小值,那么你就应该立即对此进行调查。
负数的收入数值可能是合理的,比如代表退款情况;但也可能说明数据录入出现了错误。
仅凭这个数值本身,是无法判断具体情况的。
缺失值
使用以下方法检查缺失值:
df.isnull().sum()
你可能会看到如下结果:
customer_id 0
campaign 3
channel 0
revenue 12
cost 4
现在你已经清楚地知道哪些地方存在缺失信息了。
为什么缺失数据很重要
假设你想要计算平均收入:
df["revenue"].mean()
pandas在计算时会自动排除缺失值。
这样做虽然方便,但你仍然需要了解这些数值为何会缺失。
如果缺失值是随机出现的,那么某种处理方法可能适用;但如果所有缺失的收入数据都来自某个特定的销售渠道,直接忽略这些数据就会导致分析结果出现偏差。
缺失数据不仅仅是一个技术问题,它还会影响你从营销分析中得出的结论。
假设有几条记录中的收入数据为空。如果你将所有缺失值都替换为0,那就意味着这些营销活动没有产生任何收入。但实际上,这些缺失值可能表示收入数据尚未被记录下来,或者购买信息存储在其他地方。
这些情况并不相同,因此不能简单地进行处理。
在填补或删除缺失值之前,请先问自己以下问题:
- 为什么这个数值会缺失?
- 缺失的值是否确实表示0,还是相关信息尚未被获取?
- 有多少条记录受到了影响?
- 删除这些记录是否会影响到分析结果?
例如,如果将所有缺失的广告费用都替换为0,那么计算出的广告投资回报率就会失真或失去意义。同样,如果删除所有客户信息缺失的记录,就会忽略掉一部分重要的客户群体。
只有在你弄清楚这些缺失值在数据集中的具体含义后,才能使用`fillna()`或`dropna()`函数。同时,要把你的假设记录下来,这样其他人就能理解你是如何得到这些分析结果的。
重复记录
可以使用以下方法检查重复记录:
df.duplicated().sum()
如果结果为25,那就说明有25条记录是完全相同的重复记录。
你可以这样删除它们:
df = df.drop_duplicates()
但请记住分析的重点是什么。
如果两条记录的客户ID相同,并不意味着它们是重复记录,因为同一个客户可能会进行多次购买。
如果两条记录的活动名称相同,也不一定表示它们是重复记录,因为同一场活动可能在不同的日期产生了数据记录。
千万不要仅仅因为某些记录有一两个相同的数值就直接删除它们。一定要先仔细检查这些数值的含义。
第8章:清理文本数据
营销数据集中往往包含格式不一致的文本信息。
您可能会发现:
Email
email
EMAIL
Email Marketing
Python会将这些视为不同的值。
首先,需要对字符大小写进行统一处理:
df["channel"] = (
df["channel"]
.str.lower()
)
然后去除不必要的空格:
df["channel"] = (
df["channel"]
.str.strip()
)
这样,原本如下这样的内容:
Email
email
EMAIL
都会被统一处理成:
email
您还可以对特定的标签进行统一处理:
df["channel"] = df["channel"].replace({
"email marketing": "email",
"paid social": "social media",
"social": "social media"
})
为什么标准化如此重要
假设您在清理数据之前就已经按渠道计算了收入。
那么您可能会得到如下结果:
email $20,000
Email $15,000
EMAIL $8,000
实际上,该业务可能通过某个渠道获得了43,000美元的收入,但如果您没有对数据进行标准化处理,分析结果就会错误地将这些视为不同的渠道。
这个例子说明了数据质量会如何影响商业决策。
第9章:清理数值数据
有时,数据集中的数字会以文本形式出现,而不是数值形式。尤其是在处理从电子表格、广告平台或客户关系管理系统中导出的营销报告时,这种情况尤为常见。
例如,一个代表收入的列中可能包含如下这样的值:
"$5,000"
"$7,500"
"$2,300"
虽然这些值表示金钱,但Python会将它们存储为字符串,因为其中包含了美元符号和逗号等字符。字符串只是一串字符,并不是Python可以直接用于数学计算的数值。
因此,Python无法从包含货币符号的字符串中可靠地计算出总数或平均值。在计算营销指标之前,您需要先清理这些数据,并将其转换为适当的数值类型。
去除货币符号和分隔符
第一步就是去除那些会妨碍Python将这些值识别为数字的字符。
df["revenue"] = (
df["revenue"]
.str.replace("$", "", regex=False)
.str.replace(",", "", regex=False)
)
这里,“去除符号”指的是将美元符号和逗号等格式字符从文本中删除。这样,"$5,000"就会变成"5000"。需要注意的是,处理后的结果仍然是字符串,并不会自动转换为数值。
将清理后的数值转换为数字类型
在去除了格式化字符之后,需要将这些清理过的字符串转换成数值类型:
df["revenue"] = pd.to_numeric(
df["revenue"],
errors="coerce"
)
在这个例子中,“转换”意味着将清理后的文本转换为Python可以用来进行加法、减法、乘法、除法以及统计计算的数值类型。
参数`errors="coerce"`告诉pandas,对于那些无法被解释为数字的值,应该用`NaN`来替代——`NaN`代表缺失或不可用的数值。这样就可以防止无效文本被误认为是有效的数字,但同时也意味着你需要仔细检查那些变成了`NaN`的值。
你可以通过以下代码来识别受到影响的记录:
df[df["revenue"].isna()]
如果原始数据列中可能包含缺失值,在进行清理之前先保存一份副本,这样就能区分那些原本就缺失的值,以及那些在转换过程中变成了无效值的记录。
original_revenue = df["revenue"].copy()
cleaned_revenue = (
original_revenue
.str.replace("$", "", regex=False)
.str.replace(",", "", regex=False)
)
numeric_revenue = pd.to_numeric(
cleaned_revenue,
errors="coerce"
)
invalid_revenue = (
cleaned_revenue.notna()
& numeric_revenue.isna()
)
df["revenue"] = numeric_revenue
print(df.loc[invalid_revenue, "revenue"])
如果需要进行更详细的检查,可以在替换原始数值之前,将它们保存在另一个单独的列中。
检查无效值
将文本转换为数字类型后,并不能保证得到的结果一定是合理的。某些数据集中可能会包含负数的转化率或异常高的百分比。
例如:
conversion_rate
5.2
4.8
-17
250
如果某个指标代表的是“转化次数除以点击次数”,而每次点击最多只能产生一次转化,那么250%的转化率就显得很可疑。不过,在某些特定的计算场景下,这个数值也可能是有效的——比如当该指标统计的是每次点击所产生的多次转化事件时。至于负数的转化率,通常是需要进一步调查的。
你可以通过以下代码来找出那些超出常规转化率范围的值:
df[
(df["conversion_rate"] < 0)
| (df["conversion_rate"] > 100)
]
这段代码会标出需要进一步审核的记录,但它并不能自动判断这些记录是否属于错误数据。在修改或删除任何记录之前,请先仔细核对相关指标的定义、数据来源以及业务背景。
因此,请记住:一定要先清理格式化字符,然后将清理后的数值转换为正确的数据类型,在将其用于营销分析之前,务必对结果进行验证。
第10章:使用pandas创建营销指标
原始的营销数据只能告诉你发生了什么,而经过计算得出的指标则能帮助你评估各项营销活动的效果。借助pandas,你可以创建新的列来衡量各类营销活动在将展示量转化为点击量、将点击量转化为转化结果,以及将广告支出转化为收入方面的效率。
在计算这些指标之前,请确保相关列中包含数值数据,并且所有数据都使用统一的计量单位。
计算常见的营销指标
点击率(CTR)用于衡量有多少展示量最终转化为了点击量。
df["ctr"] = (
df["clicks"]
.div(df["impressions"])
.mul(100)
)
转化率用于衡量有多少点击量最终实现了转化。
df["conversion_rate"] = (
df["conversions"]
.div(df["clicks"])
.mul(100)
)
每次点击的成本(CPC)用于衡量每次点击所对应的平均广告支出。
df["cpc"] = (
df["cost"]
.div(df["clicks"])
)
每获取一个转化结果所需的成本(CPA)用于衡量为获得一个转化结果所需支付的平均成本。这一指标的具体定义取决于企业的实际运营方式。
df["cpa"] = (
df["cost"]
.div(df["conversions"])
)
广告支出回报率(ROAS)用于衡量广告所带来的收入与所投入的广告成本之间的比例关系。
你可以使用pandas来计算ROAS,具体方法如下:
df["roas"] = (
df["revenue"]
.div(df["cost"])
)
对于每个营销指标的正确解读,取决于你的数据集中所使用的定义。例如,“转化”可能代表一次购买、一次注册、一个合格的潜在客户,或者任何其他你希望记录的行为。
避免使用零值
营销数据集中可能会存在一些点击次数为零、转化次数为零或广告支出为零的营销活动。这些零值需要特别处理,因为除以零是没有意义的。
以以下计算为例:
df["conversion_rate"] = (
df["conversions"]
.div(df["clicks"])
.mul(100)
)
如果某个营销活动的点击次数为零,那么计算转化率时分母就会变为零,这样一来就无法得出有效的转化率数值。同样地,当没有转化发生时,就无法计算CPA;而当广告支出为零时,也无法计算ROAS。
一种更安全的处理方法是:在进行除法运算之前,将分母中的零值替换为缺失值:
df["conversion_rate"] = (
df["conversions"]
.div(df["clicks"].replace(0, float("nan")))
.mul(100)
)
df["cpa"] = (
df["cost"]
.div(df["conversions"].replace(0, float("nan"))
)
df["roas"] = (
df["revenue"]
.div(df["cost"].replace(0, float("nan")))
)
这种处理方式更加安全,因为它能够避免将那些没有明确计算结果的数值当作有效数据来展示。当点击次数为零时,转化率就会缺失,而不会被报告为一个有效的百分比;当转化次数为零时,每次获取用户的成本也就无法计算出来;当广告支出为零时,投资回报率同样无法计算,更不会被视为一个有效的比率。
缺失的值并不意味着相关指标就等于零。例如:
- 点击100次但没有任何转化:此时转化率为0%。
- 没有点击次数:基于点击次数的转化率就无法计算。
- 广告支出为零:由于无法用收入除以支出来计算投资回报率,因此也就无法得到这个数值。
这些情况在商业意义上是不同的,不能被简单地视为可以互换的概念。
你可以检查哪些记录中的指标是缺失的:
df[
df[
["conversion_rate", "cpa", "roas"]
].isna().any(axis=1)
]
在将这些指标用于报告或制定营销策略之前,先仔细检查这些记录的内容。
解读结果
创建各种指标仅仅只是一个开始。较高的点击率并不一定意味着某个营销活动能够带来有价值的客户,而较高的投资回报率也不一定表示该活动是盈利的。
应该综合使用多种指标来进行分析。点击率有助于评估用户的参与度,转化率能反映点击行为转化为目标行动的有效性,每次获取用户的成本可以用来评估营销活动的效率,而投资回报率则能帮助我们了解广告支出所带来的收益情况。
我们的目标并不是孤立地最大化每一个指标的值,而是要理解这些指标是如何共同发挥作用、以及它们是否能够支持企业的整体业务目标。
第11章:数据筛选
通过数据筛选,我们可以有针对性地获取所需信息。例如,你可以这样进行搜索:
筛选出投资回报率高于3的营销活动:
high_roas = df[
df["roas"] > 3
]
筛选出转化率较高的营销活动:
high_conversion = df[
df["conversion_rate"] > 5
]
筛选出同时满足以上两个条件的营销活动:
strong_campaigns = df[
(df["roas"] > 3) & (
df["conversion_rate"] > 5
)
]
或者筛选出至少满足其中一个条件的营销活动:
promising_campaigns = df [
(df["roas"] > 4) | (
df["conversion_rate"] > 7
)
]
按文本进行筛选
如果想查找与“电子邮件”相关的营销活动,可以这样操作:
email = df[
df["channel"] == "email"
]
如果你需要搜索特定的文本内容,也可以这样做:
holiday = df [
df["campaign"]
.str.contains(
"holiday",
case=False,
na=False
)
]
当活动名称遵循某种规律时,这种方法会非常有用。
第12章:GroupBy——营销分析的核心
在营销分析中,pandas提供的最实用的函数之一就是groupby()。它允许你将数据按具有相同值的字段进行分组,并为每个组计算相应的汇总数据。
假设你的数据集包含了来自电子邮件、搜索广告、社交媒体以及展示广告等多种营销渠道的活动结果。如果分别分析每项活动,就很难判断哪些渠道带来的收入最多,或者哪些渠道产生了最多的转化。
使用groupby()功能,你可以按渠道将这些活动记录合并起来,然后为每个渠道计算相应的指标。
按渠道对活动进行分组
假设你的数据集中有一列名为channel,另一列名为revenue,那么你可以计算每个渠道的总收入:
channel_revenue = (
df.groupby("channel")["revenue"]
.sum()
)
print(channel_revenue)
这段代码会将所有属于同一渠道的记录归为一组,选取revenue这一列,然后计算每组中的收入总和。
使用同样的方法,你也可以计算平均收入:
channel_average = (
df.groupby("channel")["revenue"]
.mean()
)
或者计算每个渠道中活动记录的数量:
campaign_count = (
df.groupby("channel")
.size()
)
当然,你也可以计算每个渠道带来的转化数量:
channel_conversions = (
df.groupby("channel")["conversions"]
.sum()
)
每种计算方法都能解答不同的问题:总收入反映了某个渠道所带来的收益;平均收入表示每条记录的平均收益;活动记录的数量说明了该渠道涉及了多少次营销活动;而转化数量则表明了这个渠道为业务带来了多少实际成果。
制作一份完整的营销报告
在做出营销决策时,通常需要考虑多个指标。因此,你不必分别计算每个汇总数据,而是可以使用agg()函数一次性计算出多个数值。
channel_summary = (
df.groupby("channel")
.agg({
"impressions": "sum",
"clicks": "sum",
"conversions": "sum",
"cost": "sum",
"revenue": "sum"
})
)
这样就能生成一个表格,其中每一行代表一个渠道,每列则显示相应的汇总数值。接下来,你可以利用这些数据来计算ROAS和CPA等指标:
channel_summary["roas"] = (
channel_summary["revenue"]
.div(channel_summary["cost"].replace(0, float("nan")))
)
channel_summary["cpa"] = (
channel_summary["cost"]
.div(
channel_summary["conversions"].replace(
0, float("nan")
)
)
)
print(channel_summary.round(2))
例如,假设你的数据生成了如下示例报告:
渠道
展示次数
转化次数
收入
每次点击成本
电子邮件
50,000
4,000
500
2,000美元
10,000美元
4.00美元
搜索
80,000
6,000
300
3,000美元
9,000美元
10.00美元
社交媒体
100,000
5,000
250
2,500美元
7,500美元
10.00美元
这些示例数据用于说明报告的结构。
与单独列出各项总数相比,这个表格更加实用,因为它能让你在同一处比较各种渠道的展示效果、用户参与度、转化情况、成本以及带来的收入。
在这个例子中,在三种渠道中,电子邮件的投资回报率最高,每次点击成本最低;社交媒体的展示次数最多,但这种高展示量并没有转化为最高的收入或转化数量。这些结果引发了我们需要进一步探究的问题,但它们并不能自动说明为什么某个渠道的表现会优于其他渠道。
为什么要从总数中计算比率呢?
在计算整个渠道的投资回报率时,需要将带来的总收入除以广告总成本;而在计算每次点击成本时,则需将总成本除以转化次数。
如果你想得到整个渠道的综合指标,就不要简单地对各个单独活动的投资回报率或每次点击成本进行平均。因为不同活动的预算和转化数量可能差异很大,如果简单平均的话,那些预算较低、转化数量较少的活动就会与预算较高、转化数量较多的活动获得相同的权重。
这里的关键在于:groupby()这个函数可以帮助我们将各个单独的活动数据汇总起来,从而便于进行渠道间的比较和数据分析。只有从这些汇总后的数据中计算出相关的指标,并结合具体背景来解读它们,所得到的结果才会具有实际意义。
第13章:探索性数据分析
探索性数据分析,通常被称为EDA,是指在得出结论或构建预测模型之前,对数据集进行仔细研究,以了解其结构、质量、规律以及可能存在的关联关系的过程。
进行探索性数据分析的目的既包括生成各种统计信息,也包括回答关于这些数据的实际问题:
- 这个数据集包含了哪些信息?
- 是否存在缺失值、重复值或格式错误的数值?
- 哪些活动或渠道的表现似乎与其他渠道不同?
- 是否有需要进一步调查的异常数值?
- 这些变量之间是否存在相互关联的关系?
- 是否存在某些规律可以帮助我们解释营销活动的效果?
EDA能够帮助你了解数据能提供哪些信息,以及哪些方面还需要进一步研究。它还能揭示那些可能会导致错误报告或不可靠的机器学习模型的数据质量问题。
步骤1:理解数据集
首先,检查数据的行数和列数,预览部分记录,并查看数据类型。
print(df.shape)
print(df.head())
print(df.info())
df.shape 可以显示数据集的维度。df.head() 会展示前几行数据,而 df.info() 则会总结列的信息、数据类型以及非空值的数量。
通过这些检查,你可以发现一些问题,比如某个收入字段被存储成了文本格式,或者某个字段中的非空记录数量低于预期。
步骤2:分析汇总统计信息
print(df.describe())
对于数值型字段,describe() 会输出计数、平均值、标准差、最小值、四分位数以及最大值等统计信息。
这些数据有助于你了解数据的典型分布情况,并帮助你发现可能的异常值。例如,如果某个营销活动的广告支出异常高,这可能是正常的业务行为,也可能是数据录入错误造成的。仅凭汇总统计结果,我们无法判断哪种解释是正确的。
步骤3:检查缺失值和重复记录
print(df.isnull().sum())
print(df.duplicated().sum())
缺失值会影响计算结果和模型的准确性。重复的记录可能表明数据在生成过程中出现了错误,但需要注意的是,并非所有重复的值都属于重复记录。在删除这些记录之前,需要先确定它们究竟是真正重复的数据,还是代表不同的事件。
步骤4:分析分类信息
营销数据中通常会包含诸如渠道、活动类型、地区、目标受众或设备类型等分类信息。
print(df["channel"].value_counts())
print(df["campaign"].value_counts())
这些统计结果可以显示每个分类下记录的数量。如果某个渠道只出现了一次,而另一个渠道出现了数百次,这种不平衡情况可能会影响你对数据对比结果的解读。
步骤5:探索数据分布与关联关系
你可以总结收入数据的分布情况:
print(df["revenue"].describe())
你还可以分析数值型变量之间的相关性:
numeric_columns = [
"impressions",
"clicks",
"conversions",
"cost",
"revenue"
]
print(df[numeric_columns].corr())
相关性用来描述两个数值型变量是如何共同变化的。正相关意味着一个变量的高值往往伴随着另一个变量的高值;负相关则意味着一个变量的高值往往伴随着另一个变量的低值。
例如,广告支出与收入之间可能存在正相关关系,因为预算较高的广告活动往往能带来更多的收入。但这并不能证明是增加支出导致了收入的增长。广告活动的质量、目标受众的数量、季节性因素、产品需求等其他因素也可能对此产生影响。
EDA能提供哪些洞察?
EDA可以帮助你发现以下问题:
- 数据质量问题:缺失值、无效的数据类型、重复记录或可疑的测量结果。
- 表现差异:某些渠道或广告活动的收入、转化率或成本高于或低于其他活动。
- 分布规律:大多数订单的值是否相似,还是少数金额较大的订单影响了平均数值。
- 潜在关联:那些看似会共同变化的变量,这些变量值得进一步分析。
- 需要深入调查的问题:一些出乎意料的结果,需要结合业务背景、通过可视化工具进行分析或进行统计测试才能得出结论。
EDA并不能自动确定因果关系,但它能帮助你更深入地了解数据集,并帮助你决定接下来应该进行哪些分析。
第14章:群体分析
当你随时间推移来分析客户行为时,会发现其中许多有趣的现象。
群体分析是根据客户共同的起始点将他们分成不同的组。例如,你可以根据客户首次购物的月份来将他们分组。
假设有一位客户在1月首次购物,另一位在3月首次购物,那么他们就属于不同的群体。
df["purchase_date"] = pd.to_datetime(
df["purchase_date"]
)
first_purchase = (
df.groupby("customer_id")[
"purchase_date"
].min()
)
你可以将这些信息添加到数据集中:
df["first_purchase"] = (
df["customer_id"]
.map(first_purchase)
)
df["cohort_month"] = (
df["first_purchase"]
.dt.to_period("M")
)
现在你可以比较不同群体在各个时间段内的客户行为了。
群体分析对于了解客户的留存情况尤其有用。企业可能会发现,在某次广告活动中获得的客户比通过其他活动获得的客户保持活跃的时间更长。
这种洞察力远比仅仅知道哪次广告活动带来了最多的初始转化效果更有价值。
第15章:留存分析
获取客户只是营销工作的一部分,留住这些客户同样非常重要。
假设一家企业在1月获得了1,000位客户,但如果只有50位客户在2月再次购买了产品,那么这家企业就存在留存率低的问题。
你可以用以下方法来计算回头客的数量:
monthly_customers = (
df.groupby(
df["purchase_date"].dt.to_period("M")
)["customer_id"]
.nunique()
)
要想进行更详细的客户留存分析,就必须明确究竟什么才算作“活跃客户”。对于电子商务公司来说,活跃行为可能意味着发生了购买;而对于SaaS产品而言,活跃行为可能是登录;而在电子邮件营销活动中,活跃行为则可能是打开邮件或点击链接。这种定义必须与企业的商业模式相匹配。
第四部分:营销可视化
在清理并分析了数据之后,接下来的挑战就是如何将这些数据分析结果有效地传达给他人。
虽然营销分析师可能能够完全理解某份数据集的含义,但营销经理可能并不愿意去查看多达50,000行数据。而可视化工具正好为解决这个问题提供了帮助。
第16章:可视化作为沟通工具
一份可视化图表应该能够回答某个特定的问题。例如:
- 哪种营销渠道带来的收入最多?在这种情况下,使用条形图会比较合适。
- 收入随时间的变化趋势是怎样的?这时,线形图会更加适用。
- 广告支出与收入之间是否存在关联?对于这个问题,散点图可以帮助我们探究两者之间的关系。
虽然图表确实看起来很专业,但我们的真正目的并不是为了追求视觉效果,而是为了让重要的信息更容易被人们理解。
如何选择合适的图表类型
那么,如何判断应该使用哪种类型的图表呢?
对于反映随时间变化的趋势,应使用线形图;进行类别对比时,可以使用条形图;分析数值变量之间的关系时,散点图是最佳选择;展示数据分布情况时,直方图非常有用;而当需要显示具体的数值时,表格也是不错的选择。
一份可视化图表必须能够与所要解答的问题相匹配。
第17章:收入随时间的变化趋势
只有通过分析收入随时间的变化情况,才能获得更有价值的信息。有时候,一家企业在某个月份可能会获得大量的收入,但在接下来的几个月里收入却会下降;而另一家企业的总收入可能较低,但其收入却在持续增长。因此,分析收入变化趋势有助于我们发现各种规律、季节性变化模式、突发性的变动,以及那些需要特别关注的时期。
在绘制收入变化图表之前,请确保数据集中包含有效的日期列和数值型的收入列。下面的示例假设数据集中有purchase_date这一列,并且每一行都代表一次收入交易或事件。
准备月度收入数据
首先,需要将日期列转换为datetime格式:
import pandas as pd
import matplotlib.pyplot as plt
df["purchase_date"] = pd.to_datetime(
df["purchase_date"],
errors="coerce"
)
df = df.dropna(
subset=["purchase_date", "revenue"]
)
接下来,按月份对收入数据进行分类:
monthly_revenue = (
df.set_index("purchase_date")["revenue"]
.resample("MS")
.sum()
)
“MS”这种时间划分方式是按照月份来组织数据的,每个时间段都以该月的起始日为标志。`sum()`操作用于计算每个月的收入总额。
这种计算方法的前提是:数据集中的每一行都代表一个应被计入总收入的数值。如果数据集已经包含了各月份的营收总和,在没有检查数据结构的情况下,切勿对重复出现的月份数据进行求和,否则可能会导致收入被重复计算。
可视化趋势
monthly_revenue.plot(
kind="line",
marker="o"
)
plt.title("月度营销收入变化情况")
plt.xlabel("月份")
plt.ylabel("收入(美元)")
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
折线图能够更直观地展示数据随时间的变化情况。横轴代表时间,纵轴代表收入;每个数据点表示某个月的总收入,而连接这些点的线条则有助于人们更清晰地理解整体变化趋势。
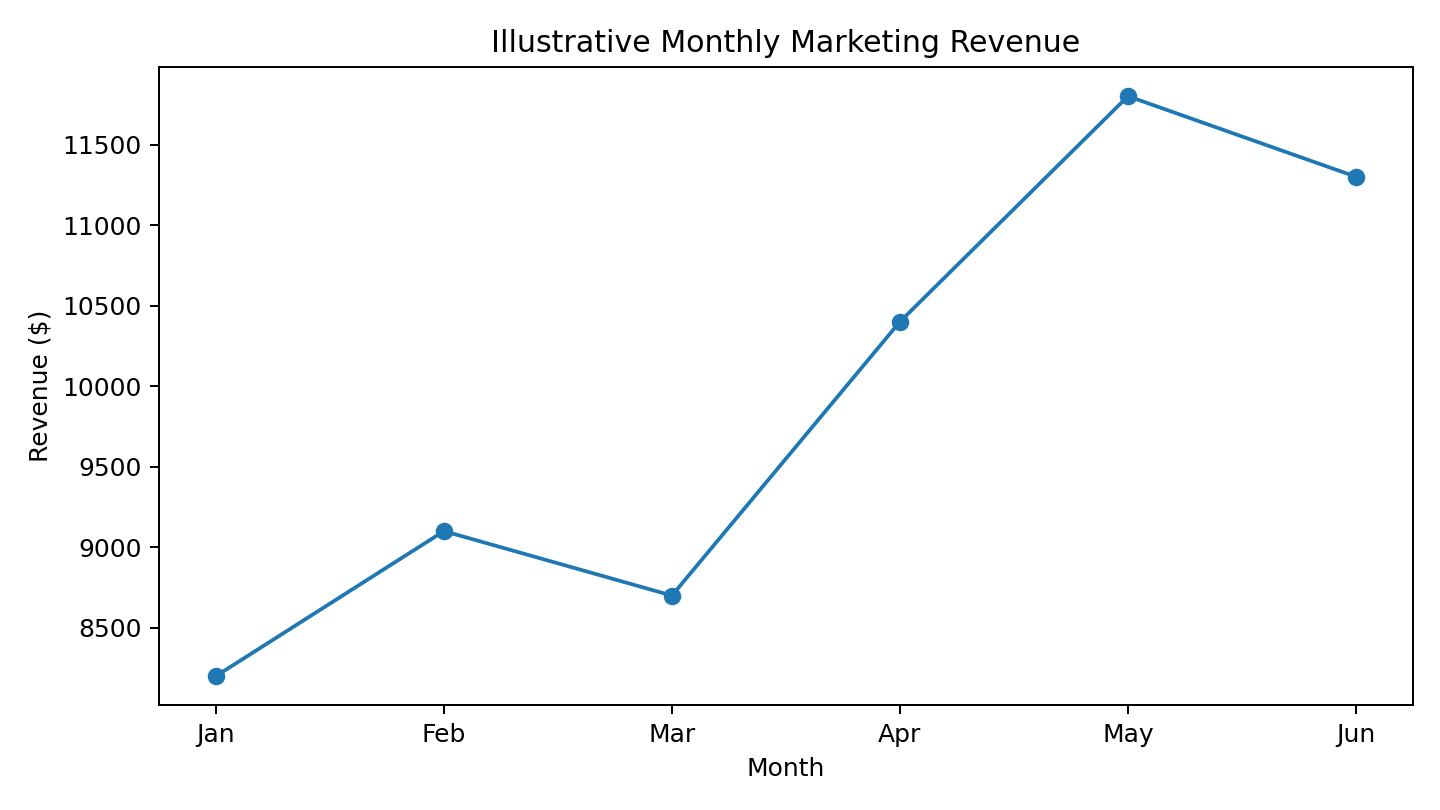
仅供学习参考用的示例数据
解读图表
在查看图表时,可以思考以下问题:
- 收入是总体上在增加、减少,还是保持稳定?
- 是否存在突然的增长或下降趋势?
- 每年同一季节是否会出现类似的变化?
- 某些营销活动、价格调整、促销活动或新产品的推出,是否能够解释这些变化?
- 所比较的各个时间段的数据是否具有完整性,且测量方式是否一致?
即使线条呈上升趋势,也不一定意味着是某次营销活动导致了收入的增加。季节性因素、定价策略、产品供应情况以及消费者需求的变化,都可能影响收入水平。
如果数据集只包含了少数几个月的数据,那么可能无法识别出可靠的季节性规律。因此,可以先利用图表来发现问题,然后再将观察到的趋势与相关的营销活动或其他业务信息进行对比分析。
请记住:通过绘制收入随时间变化的图表,可以清楚地了解各项指标的表现情况,这为进一步探究变化趋势及找出其背后的原因提供了重要依据。
第18章:渠道对比分析
营销团队通常会同时使用多种营销渠道。电子邮件、搜索广告、社交媒体和展示广告等都可能为增加收入做出贡献,但它们在覆盖范围、转化率以及成本方面可能存在差异。
进行渠道对比分析有助于解答以下问题:
- 哪些渠道带来的收入最多?
- 哪些渠道产生的转化效果最好?
- 哪些渠道最能高效地利用广告预算?
- 那些覆盖范围广的渠道是否也能带来实质性的成果?
通过可视化图表,这些对比会更容易理解,尤其是当报告中涉及多个渠道时。
按渠道比较收入情况
首先按照渠道对收入进行分类:
channel_revenue = (
df.groupby("channel")["revenue"]
.sum()
.sort_values(ascending=False)
)
然后制作一个柱状图:
import matplotlib.pyplot as plt
channel_revenue.plot(
kind="bar"
)
plt.title("各营销渠道带来的收入情况")
plt.xlabel("营销渠道")
plt.ylabel("收入(美元)")
plt.xticksrotation=45, ha="right")
plt.tight_layout()
plt.show()
每个柱状图代表一个渠道所带来的总收入。将数据从高到低排序,就能更容易地看出哪些渠道为数据集贡献了最多的收入。
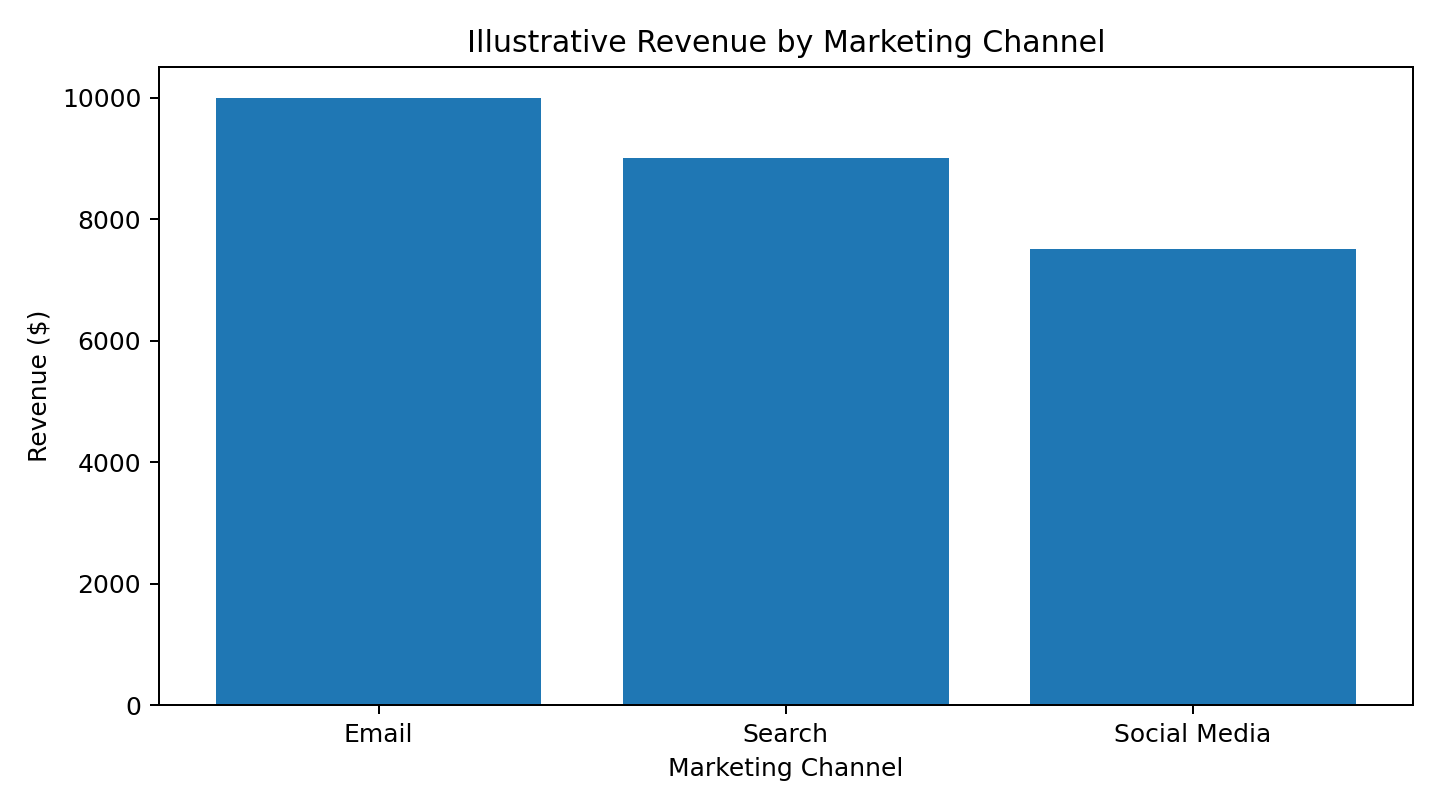
仅供学习参考的示例数据
按渠道比较转化效果
收入并不能反映全部情况。某个渠道可能带来的收入较少,但根据具体的业务目标,它可能会产生大量的注册量、潜在客户或销售订单。
channel_conversions = (
df.groupby("channel")["conversions"]
.sum()
.sort_values(ascending=False)
)
channel_conversions.plot(
kind="bar"
)
plt.title("各营销渠道带来的转化效果")
plt.xlabel("营销渠道")
plt.ylabel("转化数量")
plt.xticksrotation=45, ha="right")
plt.tight_layout()
plt.show()
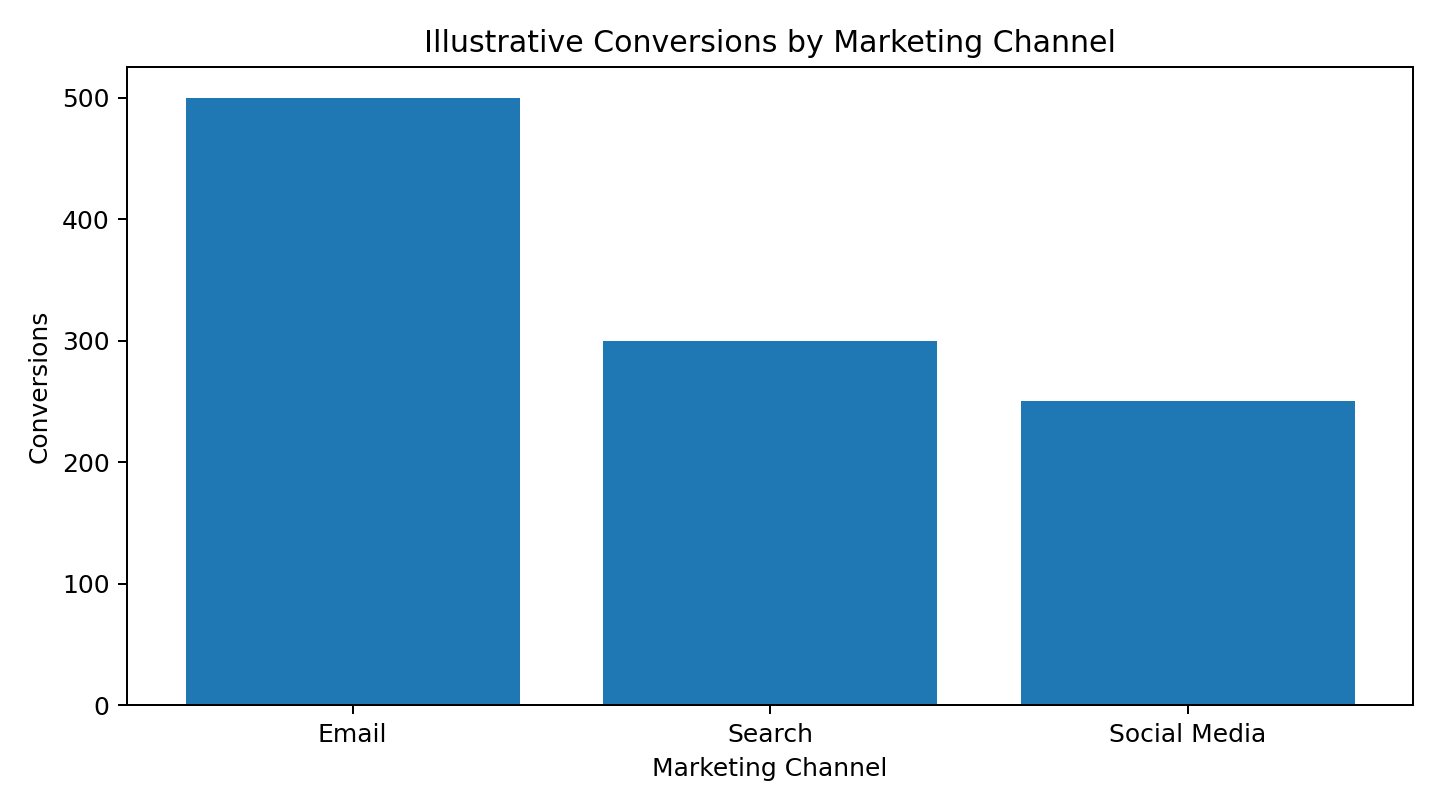
仅供学习参考的示例数据
第一个图表比较的是收入规模,而第二个图表比较的是转化数量。将这两个图表结合起来看,就能获得比单独查看任何一个图表更全面的信息。
为什么一个指标不够用
想象一下以下这样的数据结果:
渠道
收入
转化数量
广告费用
电子邮件营销
50,000美元
1,000次
40,000美元
搜索广告
45,000美元
300次
5,000美元
电子邮件营销能带来更多的收入和转化效果。然而,搜索广告仅花费5,000美元的广告费用,却能产生45,000美元的收入;而电子邮件营销则需要投入40,000美元才能获得50,000美元的收入。
它们的投资回报率分别为:
- 电子邮件:50,000美元 ÷ 40,000美元 = 1.25
- 搜索广告:45,000美元 ÷ 5,000美元 = 9.00
在这个例子中,尽管电子邮件营销带来的总收入更多,但搜索广告的投资回报率更高。请记住,投资回报率是用来衡量广告费用所带来的收益的,并不等同于利润。
这些数据说明了为什么我们应该比较相关的指标,而不是仅仅选择收入最高的营销渠道。
第19章:散点图
假设你想探究广告支出与收入之间是否存在关联。
plt.scatter(
df["cost"],
df["revenue"]
)
plt.title(
"广告支出与收入"
)
plt.xlabel("广告支出")
plt.ylabel("收入")
plt.tight_layout()
plt.show()
通过观察所得到的数据分布模式,你可以进一步分析两者之间的关系。
但不要立刻得出“增加广告支出就会导致收入增加”的结论。
这种关系可能会受到以下因素的影响:
- 广告活动的质量
- 目标受众的数量
- 季节性因素
- 产品的需求情况
- 品牌知名度
- 现有客户的行为习惯
- 其他营销渠道的作用
数据可视化可以帮助你提出更有意义的问题,但它并不能替代对数据的实际分析。
第20章:分布分析
分布分析用于研究数据中的数值是如何分布的。它不仅仅关注总数或平均值,还能帮助你了解哪些数值出现得最为频繁、数据之间存在多大的差异,以及是否存在少数异常高或低的数值对整体结果产生了影响。
在市场营销领域,分布分析可以帮助你了解顾客的单笔消费金额、广告活动的成本、网站访问次数、转化率等其他数值指标。
这与单纯分析历史数据是不同的。历史数据分析是对比不同时期的数据变化,而分布分析则是研究数据集或特定时间段内数值的分布情况与出现频率。你可以将这两种方法结合起来使用,但它们所解答的问题是不同的。
例如,历史分析可以用来判断平均单笔消费金额是否在逐月增加;而分布分析则能帮助你了解大多数订单的金额是否大致相同,还是因为少数金额异常高的订单拉高了平均值。
分析顾客订单金额
假设你的数据集中包含一个order_value字段,首先可以查看它的基本统计信息:
print(df["order_value"].describe())
输出结果会包括该字段的计数、平均值、标准差、最小值、四分位数以及最大值等信息。
平均值是指所有订单金额的算术平均数:将所有订单金额相加,然后除以订单的数量。而中位数则是当这些订单按金额排序后位于中间的那个数值。因此,少数金额极高的交易对中位数的影响要小得多。
举个例子,来看这五个订单金额:
$20, $25, $30, $35, $390
平均值是$100,但中位数却是$30。尽管其中四个订单的金额都低于$40,但那笔$390的订单使平均值大幅上升。
正因为如此,平均值并不总能准确反映典型客户的消费情况。如果订单金额分布严重偏斜,那么中位数以及整个数据分布情况可能会提供更准确的信息。
可视化数据分布
直方图将数值分成不同的区间,并显示每个区间内有多少个观测值属于该区间。
import pandas as pd
import matplotlib.pyplot as plt
df = pd.DataFrame({
"order_id": range(1, 11),
"order_value": [20, 25, 30, 35, 390, 28, 32, 40, 45, 50]
})
plt.figure(figsize=(9, 5))
plt.hist(
df["order_value"],
bins=8,
edgecolor="black"
)
plt.title("客户订单金额的分布情况")
plt.xlabel("订单金额(美元)")
plt.ylabel("订单数量")
plt.grid(axis="y", alpha=0.3)
plt.tight_layout()
plt.show()
每个条形代表一个订单金额区间,其高度表示该区间内有多少笔订单。
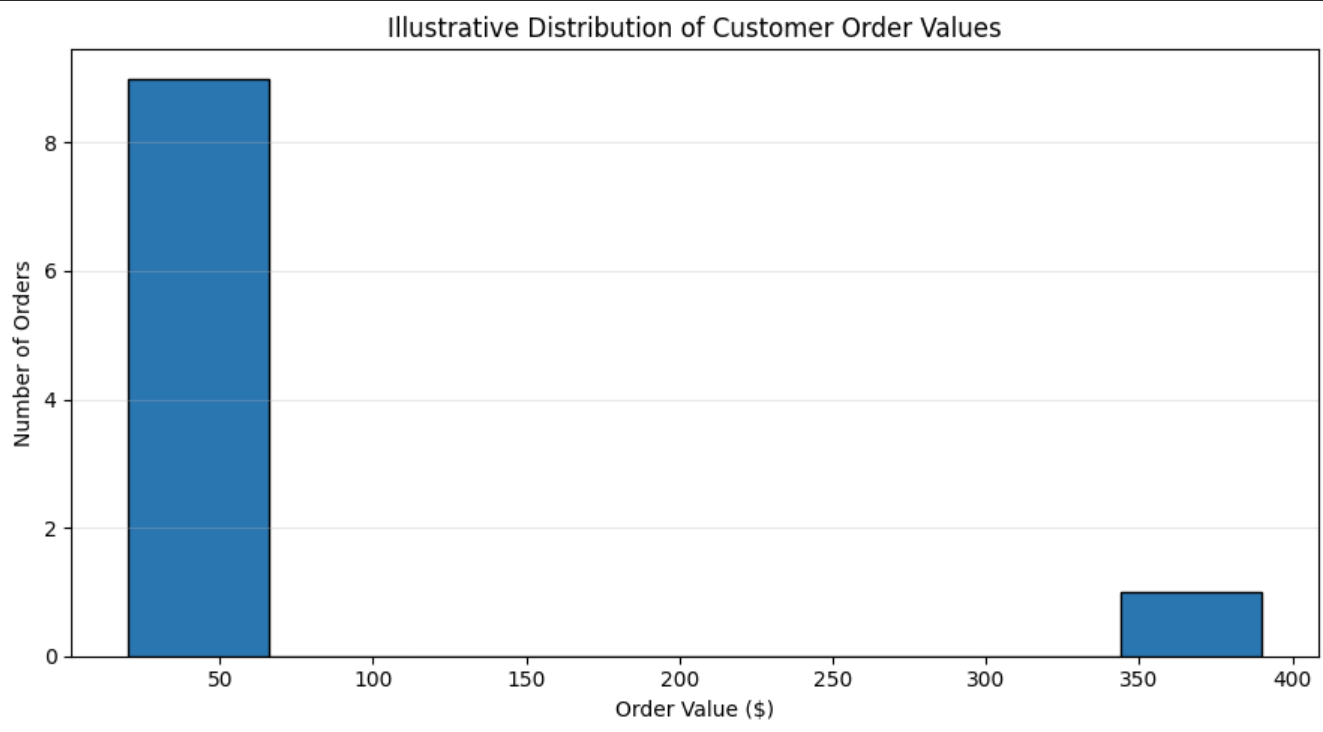
通过直方图,我们可以看出:大多数订单是否集中在某个特定的金额区间内;数据分布是否存在高价值交易的“长尾”现象;或者是否存在多个不同的订单金额群体。
需要注意哪些方面?
在分析数据分布时,请考虑以下几点:
- 中心趋势:数值们倾向于聚集在哪个位置?平均值和中位数可以帮助我们了解这一点。
- 离散程度:数值之间的差异有多大?如果分布范围很广,说明数值的变动幅度较大;而如果数值紧密集中,则说明变动幅度较小。
- 偏态:数值是否偏向某一端,而另一端的数据分布较为分散?
- 异常值:是否存在一些与其余数据相差甚远的数值?
- 不同群体:数据分布是否暗示存在不同类型的客户或交易类型?
一个异常值并不一定表示数据错误。一笔金额极高的订单也可能来自一位重要的客户。在删除或修改这类数据之前,请先核实其来源及业务背景。
为什么数据分析如此重要
假设在某个月里,平均订单金额大幅上升。如果只看平均值,你可能会认为顾客们的消费额普遍增加了;但实际上,这种增长可能是由少数几笔金额较大的交易所导致的,而大多数顾客的消费额其实并没有变化。通过比较平均值、中位数、直方图以及历史数据趋势,可以帮助我们区分这些不同情况。
关键在于:分布分析能帮助你了解哪些情况属于正常现象,各种数值的变化程度如何,以及极端数据是否会影响汇总统计结果所反映的信息。
第五部分:客户分析与活动分析
当你不再仅仅追问“我们的营销活动效果如何”,而是开始思考“哪些人做出了回应?他们为何会回应?接下来我们应该采取什么行动?”时,市场分析就会变得有趣得多。
第21章:客户细分
客户细分是指根据客户共有的特征或行为将他们划分为不同群体的过程。企业不必把所有客户都视为完全相同的对象,而是可以识别出那些对营销活动会有不同反应的群体。
例如,有些客户会频繁购物,有些只购买过一次商品,而还有一些已经好几个月没有进行任何购买了。企业可能会选择奖励经常购物的客户,鼓励那些仅购买过一次的商品的客户再次购买,或者与那些已经不再活跃的客户重新建立联系。
客户细分有助于营销人员为不同的客户群体制定更加针对性的策略。虽然它不能自动告诉你每个客户的具体需求,但它提供了一种系统化的方法来理解客户行为中的规律性。
RFM分析
一种常见的方法是RFM分析,该方法使用三个指标来进行评估:
- 最近购买频率:客户是在多久之前进行最后一次购买的?
- 购买频次:在所分析的这段时间内,该客户共进行了多少次购买?
- 消费金额:在这段时间内,该客户总共花费了多少钱?
这些指标能从不同的角度反映客户的购买行为。如果“最近购买频率”数值较低,说明客户最近才进行过购买;而如果这个数值较高,则说明该客户已经有一段时间没有购买了。较高的“购买频次”意味着该客户购买次数较多,而较大的“消费金额”则表明其消费能力较强。
假设一个数据集包含`customer_id`、`purchase_date`和`order_value`这三个字段。首先,需要将这些购买日期转换为datetime类型的数据:
df["purchase_date"] = pd.to_datetime(
df["purchase_date"],
errors="coerce"
)
选定一个分析日期,然后计算每位客户的最后一次购买时间、购买频次以及总消费金额:
analysis_date = pdTimestamp("2026-09-05")
customer_rfm = (
df.groupby("customer_id")
.agg(
last_purchase=("purchase_date", "max"),
frequency=("purchase_date", "count"),
monetary=("order_value", "sum")
)
)
customer_rfm["recency"] = (
analysis_date - customer_rfm["last_purchase"]
).dt.days
customer_rfm = customer_rfm[
["recency", "frequency", "monetary"]
]
print(customer_rfm)
这个示例假设每一行代表一笔交易,且order_value字段包含了该笔交易的金额。如果你的数据中每笔订单包含多行记录,那么就需要使用唯一的订单标识符来确保计数的准确性。请选择与你要分析的报告周期相匹配的分析日期。
了解RFM表格
下表展示了RFM汇总数据的典型格式:
客户ID
最近购买次数(天)
交易金额
C001
8
12
960美元
C002
75
4
240美元
C003
180
1
45美元
C004
20
7
525美元
这些示例数值仅用于说明目的。
在本案例中,客户C001最近才进行购买,购买次数较多,且消费金额最高;而客户C003已经很长时间没有购物了,只进行过一次交易,因此其消费金额最低。
这样的差异提示我们可能需要采取不同的营销策略:对于经常购买的客户,可以提供忠诚度奖励;对于偶尔购物的客户,可以发送跟进优惠信息;而对于长期不活跃的客户,则需要开展重新吸引他们的活动。
不过,RFM数值必须结合具体情境来解读。对于某些产品而言,如果客户一年只购买一次,那么其购买频率较低也是完全正常的。此外,观察期的长度也会影响分析结果——因为一个活跃了两个月的客户,积累的交易金额肯定少于一个活跃了两年的客户。
第22章:客户生命周期价值
客户生命周期价值用于衡量客户在与企业建立关系期间所创造的总价值。
一种简单的计算方法是:
customer_ltv = (
df.groupby("customer_id")[
"order_value"
].sum()
)
这种方法可以告诉你每位客户过去总共花费了多少钱。
更复杂的模型还可以预测客户的未来价值。
例如,一个概念性的计算公式可能会考虑以下因素:
平均交易金额 × 购买频率 × 预计客户生命周期
不过,实际的客户生命周期价值计算往往会涉及更多变量。
这些变量可能包括:
- 毛利率
- 客户留存率
- 客户流失率
- 折扣因素
- 获取客户的成本
- 产品类别
- 客户行为习惯
需要强调的是,客户生命周期价值只是一个估算值,并非不可动摇的真理。
第23章:客户获取成本
客户获取成本,即CAC,用于衡量获取一位客户所需支付的费用。
一个简单的计算公式如下:
cac = 总营销费用 / 新获得客户数量
假设以下数据:
营销费用 = 20000
新获得客户数量 = 400
cac = 营销费用 / 新获得客户数量
print(cac)
计算结果为:
50.0
这意味着平均每位客户的获取成本为50美元。
将CAC与客户生命周期价值进行比较,有助于判断这种客户获取方式是否具有经济可行性。
CAC与客户生命周期价值的结合分析
假设以下数据:
CAC = 50美元
客户生命周期价值 = 300美元
从这些数据来看,这种客户获取方式似乎是可行的。
但如果再假设:
CAC = 250美元
客户生命周期价值 = 180美元
那么这家企业获得的客户可能其价值超过了获取这些客户所花费的成本。
尽管如此,这些指标仍然需要谨慎解读。客户生命周期价值可能是估算得出的,而CAC也会因获取客户的渠道不同而有很大差异。
某些获取客户的成本可能会在简单的计算中被忽略,但综合来看,这些指标为分析营销活动的经济效益提供了有用的框架。
第24章:漏斗分析
营销漏斗描绘了客户在完成某项目标行动之前所经历的各个阶段。例如,购买商品、注册服务或填写联系表单等。
一个典型的在线购物漏斗流程可能包括:
- 访问网站
- 查看产品信息
- 将产品加入购物车
- 开始结账流程
- 完成购买
在每个阶段,都会有一部分人继续进入下一阶段,而另一部分人则会离开。漏斗分析可以用来衡量有多少人能够顺利从某个阶段过渡到下一个阶段,并帮助你确定哪些环节需要进一步关注。
计算各阶段的转化率
假设某网站在同一个统计周期内记录了以下数据:
访问人数 = 50000
产品浏览次数 = 30000
加入购物车次数 = 8000
开始结账次数 = 4000
完成购买次数 = 2500
阶段转化率是指达到某个阶段后能够继续进入下一阶段的人所占的比例。
阶段转化率的计算公式为:
**阶段转化率 = 到达下一阶段的人数 ÷ 到达前一阶段的人数 × 100%**
例如,产品浏览转化率的计算方法是将产品浏览次数除以访问人数:
产品浏览转化率 = (产品浏览次数 / 访问人数) × 100%
类似地,其他阶段的转化率也可以用同样的方法计算。
product_view_rate = (
product_views / visitors * 100
)
cart_rate = (
cart_adds / productViews * 100
)
checkout_rate = (
checkouts / cart_adds * 100
)
purchase_rate = (
purchases / checkouts * 100
)
print(f"访问网站后看到产品的转化率:{product_view_rate:.1f}%")
print(f>看到产品后加入购物车的转化率:{cart_rate:.1f}%")
print(f>加入购物车后开始结账的转化率:{checkout_rate:.1f}%")
print(f>开始结账后完成购买的转化率:{purchase_rate:.1f}%")
根据这些数据可以看出:60%的访问者会查看某件产品,其中约26.7%的人会将该产品加入购物车,50%的购物车中的商品会进入结账环节,而最终有62.5%的结账行为会转化为实际购买。
每个百分比都代表一个具体的转化过程。请不要将这些阶段性的转化率与整体的购买率混淆——后者的计算方式是将所有购买行为直接与访问者数量进行对比。
这些数据还假设各个阶段的统计对象是统一的,并且指的是在同一报告周期内、具有相似特征的用户或会话。如果统计对象不同,或者使用的跟踪规则有所差异,那么这些转化率可能就无法准确反映用户的购买过程了。
探究客户体验
较低的阶段转化率可以告诉我们用户在哪个环节放弃了继续操作,但无法解释他们为何会退出。下一步就是深入研究该阶段的客户体验情况。
例如,如果很多用户在结账环节放弃购买,那么可能需要检查以下问题:
- 意外的运费或税费
- 结账流程步骤过多
- 在移动设备上难以填写的表格
- 支付选项过于有限
- 页面加载速度过慢或存在技术故障
- 配送或退换货信息不够清晰明了
- 广告内容与落地页不匹配
你可以通过分析各种数据、进行设备间的对比研究、收集客户支持反馈、开展可用性测试以及查看错误日志来探究这些可能的原因。这些方法能帮助你找到问题的真正根源,而不仅仅是根据转化率本身下结论。
如果证据表明对结账流程进行调整会有所帮助,你可以尝试简化结账步骤或提供更清晰的定价信息。这种做法将漏斗分析与A/B测试结合起来:漏斗分析可以帮助确定需要重点调查的环节,而实验则能验证这些调整是否真的能够改善最终结果。
漏斗分析能够揭示客户在哪个环节停止了继续操作,而对客户体验的深入研究则有助于你找到问题的原因,并判断哪些改进措施值得尝试。
第25章:A/B测试
A/B测试是一种受控实验,用于比较两种不同的营销方案。企业可以通过对比两个不同的落地页、邮件主题行、广告内容、结账界面或行动号召语,来找出哪种方案在实现特定目标方面更有效。
版本A代表现有的方案或对照组,而版本B则是正在测试的改进方案。理想情况下,符合条件的用户会被随机分配到这两个组中,这样就能确保对比结果不会受到两组之间差异的影响。
计算转化率
假设你正在测试两个不同的落地页,并想了解访问者是否会完成预期的操作。
visitors_a = 5000
conversions_a = 240
visitors_b = 5000
conversions_b = 290
计算各自的转化率:
rate_a = (
conversions_a / visitors_a
)
rate_b = (
conversions_b / visitors_b
)
print(f"版本A的转化率为:{rate_a:.2%}")
print(f"版本B的转化率为:{rate_b:.2%}")
在这个例子中,版本A的转化率为4.8%,而版本B的转化率为5.8%。两者之间的差异为1个百分点。
然而,观察到的这种差异并不一定能证明版本B确实更优秀。即使两个版本在更广泛的用户群体中的表现相似,结果也可能会因为随机因素而有所不同。
理解统计不确定性
A/B测试通过使用一部分访问者样本来推测这些版本在更大规模的用户群体中会取得怎样的效果。由于测试通常并不涵盖所有潜在用户,因此测量得到的转化率实际上只是估算值,并非真实反映整个用户群体的情况。
统计不确定性指的是这些估算值可能会因样本的不同而有所差异。即使两个版本的实质表现没有变化,不同组的访问者也可能产生略有不同的测试结果。
有几种因素会影响实验结果的不确定性:
- 样本规模:样本规模较小的情况下,估算结果的精确度通常会低于样本规模较大的情况。
- 转化发生的频率:如果目标行为发生的频率较低,那么就需要进行更多的观察才能准确计算出转化率。
- 随机性因素:个别访问者的行为是难以完全预测的。
- 实验设计:如果分配样本的方式不均匀、跟踪数据存在问题,或者在测试过程中进行了某些调整,都可能影响实验结果的准确性。
在样本规模较小的情况下,观察到的细微差异很可能是由随机因素造成的。而一个设计严谨、样本量较大的实验则能提供更有力的证据,但仅仅依靠样本规模本身,并无法解决样本分配不均匀或数据跟踪错误等问题。
统计显著性与商业意义
统计显著性用于判断在假设两个版本之间没有实际差异的统计模型下,观察到的结果是否属于异常情况。它并不能直接说明这种差异对业务来说有多大的价值,也不能证明这一结果在未来所有情况下都会再次出现。
而商业意义则关注的是这种改进所带来的效果是否值得采取行动。例如,对于一个访问量很大的网站来说,即使转化率只提高了少量,也可能带来可观的额外收益;但对于访问量很小的网站而言,这种提升可能带来的附加价值就非常有限了。此外,实施这些改变所需要付出的成本和承担的风险也同样重要。
一个负责任的A/B测试流程应当做到以下几点:
- 在测试开始之前,明确主要评估指标。
- 在适当的情况下,将符合条件的访问者随机分配到不同版本中。
- 确保两种版本的转化跟踪功能能够一致地运行。
在评估测试结果之前,需要先确定所需收集的数据量以及合适的测试时长。
- 要考虑到统计上的不确定性,以及观察到的差异在实际中的意义有多大。
- 除非测试方法本身允许进行连续监测,否则应避免反复检查结果,也不要在某个版本看起来更优时就立即停止测试。
- 必须将测试结果、存在的局限性以及最终做出的决策记录下来。
A/B测试并不仅仅是为了选择哪个版本的效果更好。其真正的目的是收集可靠的数据,以证明某项变更是否确实能够改善预期的结果。
这里需要重点理解的一点是:统计上的不确定性非常重要,因为样本测试的结果可能与实际的整体表现存在差异。了解这种不确定性有助于我们避免基于随机波动做出代价高昂的营销决策。
第六部分:营销自动化
营销团队往往要花费大量时间去重复那些遵循固定规则的操作流程。
正因为如此,自动化成为了Python语言最强大的应用领域之一。
第26章:寻找自动化应用的契机
一个适合进行自动化的任务通常具备以下特征:
- 该任务会反复出现。
- 其执行步骤具有规律性,可以预测。
- 它涉及结构化数据的处理。
- 进行这项任务时几乎不需要主观判断。
- 如果手动完成这项任务,很容易出错。
- 通过自动化处理,能够节省大量时间。
例如:
“每周一,下载活动数据,计算投资回报率,找出那些效果低于预设标准的活动,然后生成报告。”
这样的任务非常适合进行自动化处理。
第27章:构建报告功能
与其手动执行每一个步骤,不如直接编写一个函数来完成任务。
def generate_campaign_report(
input_file,
output_file
):
df = pd.read_csv(input_file)
df["roas"] = (
df["revenue"] /
df["cost"]
)
df["conversion_rate"] = (
df["conversions"] /
df["clicks"] *
100
)
df.to_csv(
output_file,
index=False
)
然后,就可以这样调用这个函数来执行任务了:
generate_campaign_report(
"campaigns.csv",
"campaign_report.csv"
)
现在,这样的工作流程就可以被重复应用了。
第28章:日志记录
当脚本自动运行时,仅仅使用print()语句往往是不够的。
通过日志记录,可以以更加有条理的方式保存测试过程中的各种信息。
import logging
logging.basicConfig(
level=logging.INFO
)
logging.info(
"营销报告开始执行了。"
)
那么:
logging.info(
"活动数据已成功加载。"
)
如果出现错误:
logging.error(
"无法加载活动数据。"
)
当定时任务在无人监督的情况下运行时,日志记录功能就显得尤为重要了。
第29章:调度
一旦你的脚本能够正常运行,你就可以对其进行调度安排了。
例如,你可以配置操作系统让报告程序在每个周一早上自动执行。
调度系统的具体实现方式取决于你所使用的环境。在Windows系统中,任务计划程序可以用来执行Python程序;在macOS和Linux系统中,cron是一个常用的工具;云平台也同样能够支持定时任务的执行。
一个重要的概念是:只有当某个流程能够在无人手动启动的情况下可靠地运行时,自动化才算真正完成。
第30章:自动警报机制
营销系统不应该总是等待有人去查看报告结果。
它应该能够自行识别出一些重要的情况。
if overall_roas < 1:
alert = (
"警告:整体投资回报率低于1。"
)
或者:
if conversion_rate < previous_rate * 0.8:
alert = (
"转化率与上期相比有所下降。"
)
这些警报信息可以发送到电子邮件、Slack、Microsoft Teams或其他通知系统中。
关键在于,系统必须能够及时发现那些需要引起注意的情况。
第31章:负责任的自动化
自动化可以让营销工作变得更高效、更一致,但同时也可能让错误在更大范围内重复发生。如果一个脚本曾经计算出错误的指标,那么它以后每次运行时都可能会得到同样的错误结果。而如果这些报告被用于制定营销策略或自动发送客户通知,后果可能会非常严重。
假设有一份报告错误地将某些不符合条件的客户标记为符合促销资格,那么人工审核或许能够发现这个问题;但一个没有验证机制的自动化系统却可能会反复分发这些错误的名单。
因此,生产环境中的自动化流程必须包括数据输入验证、错误处理、日志记录、测试以及监控等功能。某些重要的操作可能还需要人工审批才能执行。
一个简单且适用于生产环境的自动化工作流程
一个基本的营销报告自动化工作流程可以遵循以下步骤:
- 加载数据源:读取最新的活动数据导出文件或已审核的输入文件。
- 验证数据:检查所需列是否齐全,数值字段是否包含有效内容,以及是否存在异常记录。
- 计算各项指标:生成转化率、每次点击成本和投资回报率等指标,并确保在分母为0的情况下能够正确处理这些情况。
- 保存报告结果:将计算得到的数据写入指定的输出位置。
- 记录执行结果:记录报告是成功完成还是出现了错误,以便后续有人可以排查问题。
- 安排调度并监控流程:使用操作系统的任务计划程序或成熟的协调工具来确保流程能够按预期运行,并检查是否产生了预期的输出结果。
以下示例展示了一个用于生成活动报告的简单工作流程。该流程假设输入的CSV文件中每行对应一个活动,且文件中包含campaign、clicks、conversions、cost和revenue这几列数据。
import logging
from pathlib import Path
import pandas as pd
logging.basicConfig(
level=logging.INFO,
format="%(asctime)s %(levelname)s: %(message)s"
)
REQUIRED_columns = {
"campaign",
"clicks",
"conversions",
"cost",
"revenue"
}
def generate_report(input_file, output_file):
input_path = Path(input_file)
output_path = Path(output_file)
try:
if not input_path.exists():
raise FileNotFoundError(
f"输入文件未找到:{input_path}"
)
df = pd.read_csv(input_path)
missing = REQUIRED_columns - set(df.columns)
if missing:
raise ValueError(
f"缺少必要的列:{sorted(missing)}
)
numeric_columns = [
"clicks",
"conversions",
"cost",
"revenue"
]
for column in numeric_columns:
df[column] = pd.to_numeric(
df[column],
errors="coerce"
)
if df[numeric_columns].isna().any().any():
raise ValueError(
"必要的数值字段中存在缺失或无效的值。"
)
if (df[numeric_columns] < 0).any().any():
raise ValueError(
"在不应为负数的指标中检测到了负值。"
)
if (df["conversions"] > df["clicks]).any():
logging.warning(
"某些活动的转化次数多于点击次数,请检查相关指标的定义。"
)
df["conversion_rate"] = (
df["conversions"]
.div(df["clicks"].replace(0, float("nan"))
.mul(100)
)
df["cpa"] = (
df["cost"]
.div(
df["conversions"].replace(
0, float("nan")
)
)
)
df["roas"] = (
df["revenue"]
.div(df["cost"].replace(0, float("nan"))
)
output_path.parent.mkdir(
parents=True,
exist_ok=True
)
df.to_csv(output_path, index=False)
logging.info(
"报告已成功保存到 %s",
output_path
)
except Exception:
logging.exception(
"生成营销报告时出现错误"
)
raise
if __name__ == "__main__":
generate_report(
"campaigns.csv",
"reports/campaign_report.csv"
)
是什么让这个工作流程更加安全?
该脚本会检查输入文件是否存在,以及所需的列是否都已包含在内。它会尝试将那些表示度量的列转换为数值类型;如果发现某些必填字段中存在缺失或无效的数据,程序就会停止执行。此外,对于那些通常不应该为负数的度量值,该脚本也会将其标记为负数。当转化次数超过点击次数时,系统会记录警告信息,而不会自动修改相关数据。根据企业对“转化”的定义,出现这种结果也是有可能的,因此应该对此进行调查,而不是默默地对其进行修正。
在计算各种比率时,如果分母为零,系统会使用缺失值来处理这种情况,这样就可以避免将无意义的比值当作有效数值来报告。此外,该脚本还会在必要时创建输出目录,记录执行成功的操作,并在出现故障时记录故障信息,以便调度程序或监控系统能够及时发现这些问题。
这只是一个实用的起点,并不是一个完整的监控平台。在实际应用中,还需要考虑数据的时效性、重复导入数据的问题、预期的数据行数、访问权限、数据的安全存储方式、备份机制、报警功能,以及是否需要人工审核报告内容,才能确保这些报告不会对营销活动产生负面影响。
工作流的调度
在测试阶段,可以手动运行该脚本。一旦确认其能够可靠地执行任务,就可以使用Windows任务调度程序或Linux/MacOS系统中的cron等工具来安排它的运行时间。调度程序负责决定脚本何时执行,而Python代码则决定了脚本具体要完成哪些操作。
在正式安排脚本运行之前,应先使用样本数据来测试工作流程,并故意设置一些故障条件,比如缺少某些字段或输入无效的数值。这样就可以确保脚本会在出现问题时明确地失败,而不会生成误导性的报告。
这里需要强调的一点是:可靠的自动化并不意味着完全不需要人工干预。还需要关注输入数据的有效性验证、故障处理机制、结果记录方式,以及如何确保自动化生成的输出结果是可以信赖的。
第七部分:营销领域的机器学习
当人们希望从描述已经发生的事情转向预测未来可能发生的情况时,机器学习就显得非常有用了。
第32章:从分析到预测
传统的分析方法可能会回答这样的问题:“上个月哪些客户购买了产品?”
而机器学习则可能会给出这样的答案:“下个月哪些客户最有可能购买产品?”
传统分析关注的是“哪些营销线索最终转化成了销售?”
机器学习则会探究“哪些营销线索最有可能带来转化结果?”
传统分析会统计“哪些客户流失了?”
机器学习则会预测“哪些客户最有可能流失?”
这种区别非常重要:机器学习并不是取代传统的分析方法,而是在其基础上进行进一步的拓展和发展。
第33章:特征与目标变量
机器学习模型通常需要一些被称为“特征”的输入变量来进行训练。
假设你想预测客户流失的情况,那么可能的特征变量包括:
购买频率
总消费金额
上次购买至今的天数
邮件打开次数
网站访问时长
“流失用户”这一标签
<在Python中:features = [
"购买频率",
"总消费金额",
"上次购买至今的天数",
"邮件打开情况",
"网站访问次数"
]
X = df[features]
y = df["流失用户"]
<在这里:X包含用于预测的信息。y包含你想要预测的结果。
第34章:数据划分
<在训练机器学习模型之前,你需要将用于训练模型的数据与用于评估模型的数据分开。
<这一点非常重要,因为一个模型可能在它已经见过的样本上表现良好,但在新的样本上却不能取得同样的效果。如果你使用模型所学用的相同数据来评估它,那么评估结果可能会高估该模型在实际应用中的表现。
<一种常见的方法是创建训练集和测试集:
- 训练集:模型用来学习规律的数据。
- 测试集:留到评估阶段使用的数据,用于检测训练好的模型在未用于学习的数据上的表现。
<例如,按照80/20的比例划分数据,意味着大约80%的数据被用于训练,20%的数据被用于测试。这是一个常见的分割方法,但并不是绝对适用的规则。合适的分割比例取决于数据集的大小、预测任务的性质以及模型的使用方式。
使用scikit-learn进行数据划分
<假设X包含了模型的输入特征,而y包含了你想要预测的目标变量。
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(
X,
y,
test_size=0.2,
random_state=42
)
<在这里,test_size=0.2表示将20%的数据用于测试。random_state=42确保随机划分的结果具有可重复性,这样在数据集和代码不变的情况下,每次分割得到的结果都会相同。
<对于分类问题来说,你可能还希望保持两个数据集中各类样本的比例大致一致:X_train, X_test, y_train, y_test = train_test_split(
X,
y,
test_size=0.2,
random_state=42,
stratify=y
)
<当目标类别的数量不平衡时,使用stratify=y通常会很有帮助。但是,这种分层方法要求每个类别都有足够的样本数量,并且并不适用于所有类型的预测任务。
避免时间相关性带来的影响
<对于营销数据而言,随机划分方法并不总是适用的选择。如果你要预测未来的购买行为或用户流失情况,这些数据是按照时间顺序排列的。如果使用后来的数据来进行训练,而用早期的数据来进行测试,那么未来发生的信息就可能会影响到评估结果。对于那些依赖于时间变化的预测任务,可以考虑使用较早时期的数据来进行训练,而用较晚时期的数据来进行测试。这种数据划分方式应当能够反映在做出预测时实际可用的信息。
还需要记住的是,仅仅对数据进行分割本身并不能防止数据泄露。任何那些会从数据集中提取信息的预处理步骤(比如填补缺失值或对特征进行缩放处理)都应该仅使用训练数据来进行训练,然后再将这些处理方法应用到测试数据上。
请记住:数据划分有助于评估模型在面对未见过的数据时的表现,但这种划分方式必须能够反映该模型在现实世界中将被如何使用。
第35章:分类
分类是一种机器学习任务,在这种任务中,模型会预测某个对象所属的类别。在市场营销领域,这类应用的例子包括判断客户是否会流失、潜在客户是否会转化为实际顾客、某封邮件是否会被标记为垃圾邮件,或者判断客户是否会在指定的时间内完成购买。
分类与回归有所不同:分类是用来预测类别,而回归则是用来预测数值型结果,比如预期收入或客户的生命周期价值。
分类模型会从那些已知正确结果的历史数据中学习规律,然后利用这些规律来预测新数据的结局。模型的预测结果只是估计值,并不能保证一定准确。
准备特征数据和目标变量
假设你想预测客户是否会流失,那么你的数据集中可能会包含以下这些特征:
purchase_frequency
total_spend
days_since_last_purchase
email_opens
website_sessions
目标变量可能是一列名为churned的字段,其中每一条记录都会标明该客户在某个明确规定的时间段内是否发生了流失。
在Python中,可以这样操作:
features = [
"purchase_frequency",
"total_spend",
"days_since_last_purchase",
"email_opens",
"website_sessions"
]
X = df[features]
y = df["churned"]
在这里,X包含了用于进行预测的特征数据,而y则包含了模型需要预测的结果。特征数据中只能包含在做出预测时确实能够获取的信息。
在训练模型之前,需要适当地处理缺失值和分类变量,并且要按照前一章介绍的方法将数据集划分为训练集和测试集。
训练逻辑回归分类器
逻辑回归是进行二分类任务的常用方法,比如预测客户是否会流失这类问题。
from sklearn.linear_model import LogisticRegression
model = LogisticRegression(
max_iter=1000
)
model.fit(
X_train,
y_train
)
fit()方法使用训练特征及其已知的目标标签来训练模型。该模型会学习输入变量与结果之间的关系。
可以使用训练好的模型来预测那些被保留下来用于测试的特征所属的类别:
predictions = model.predict(
X_test
)
predict()方法会生成预测出的类别标签。对于二分类的流失模型来说,这些标签可能表示“客户会流失”或“客户不会流失”。
你可以使用分类报告来评估这些预测结果:
from sklearn.metrics import classification_report

print(
    classification_report(
        y_test,
        predictions,
        zero_division=0
    )
)
这份报告会总结每个类别的精确度、召回率以及F1分数等指标。
其他分类模型
逻辑回归并不是唯一的选择。根据数据的特点和所要解决的问题,你还可以考虑以下模型:
- 决策树:根据特征值学习一系列决策规则。
- 随机森林:结合多棵决策树的预测结果进行判断。
- 梯度提升:通过构建多个模型序列来提升预测性能。
- 支持向量机:确定用于区分不同类别的决策边界。
- 朴素贝叶斯:利用概率论假设来估计样本所属类别。
不同的模型具有不同的优势、计算要求以及可解释性。更复杂的模型并不一定就更好。应该使用相同的数据划分方式和评估标准来比较各种模型,而不要仅仅依据训练效果来选择模型。
因此请记住:分类模型是通过学习带有标签的历史数据样本来预测新数据的类别的。它们的实际效用取决于数据的质量、特征提取的时间点、所选择的模型类型,以及预测结果的评估方式。
第36章:为什么准确性可能会产生误导
准确性指的是分类模型做出正确预测的比例。这个指标很容易理解,但当类别分布不平衡,或者不同类型的错误在业务上造成的影响不同时,准确性就会产生误导。
假设只有1%的顾客会流失,那么一个总是预测“顾客不会流失”的模型,其准确性约为99%;但实际上,这种模型会漏掉所有那些确实会流失的顾客。
虽然这种模型的准确性很高,但如果它的目的是识别那些需要被挽留的顾客,那么它实际上可能毫无用处。
为了更有效地评估分类模型,我们应该考虑精确度、召回率、F1分数、ROC-AUC值以及混淆矩阵等因素。
混淆矩阵
混淆矩阵用于将模型预测的结果与实际结果进行对比。对于二分类模型而言,混淆矩阵包含四种结果:
- 真正例(TP):模型预测该样本属于正类,而实际类别也确实为正类。
- 真负例(TN):模型预测该样本属于负类,而实际类别也确实为负类。
- 假正例(FP):模型预测该样本属于正类,但实际类别为负类。
- 假负例(FN):模型预测该样本属于负类,但实际类别为正类。
对于客户流失预测模型而言,真正例指的是被正确识别为会发生流失的客户;假正例则是指被错误地判断为可能发生流失的客户;而假负例指的是那些实际上发生了流失,但却未被模型检测到的客户。
这些不同的错误类型会产生不同的后果。假正例可能会导致企业为那些本来就不会流失的客户花费资源进行挽留尝试;而假负例则意味着企业会错过联系那些即将离开的客户的机会。
准确性
准确性用于衡量所有预测结果中正确的比例。
准确性 = (真正例 + 真负例) ÷ (真正例 + 真负例 + 假正例 + 假负例)
当各个类别之间的分布较为均衡,且错误所带来的后果相对较轻时,使用准确性这一指标会很有帮助。然而,当某一类别的出现频率远高于其他类别时,准确性可能会掩盖模型在较少出现的类别上的表现不佳的情况。
精确度
精确度用于衡量被预测为正类的样本中,实际确实属于正类的样本所占的比例。
精确度 = 真正例 ÷ (真正例 + 假正例)
对于客户流失预测模型而言,精确度能够回答这样一个问题:“在那些被模型判断为可能发生流失的客户中,实际上有多少人确实发生了流失?”
当与客户联系的成本较高,或者错误的预警会浪费有限的资源时,高精确度就显得非常有用。
召回率
召回率用于衡量模型正确识别出实际属于正类的样本所占的比例。
召回率 = 真正例 ÷ (真正例 + 假负例)
对于客户流失预测模型而言,召回率能够说明:“在所有实际上发生了流失的客户中,有多少人被模型检测到了?”
当错过那些处于高风险中的客户会带来特别严重的后果时,高召回率就显得非常重要。然而,提高召回率也可能会导致假正例的数量增加,这取决于具体的模型以及决策阈值设置。
F1分数
F1分数通过计算精确度和召回率的调和平均值来综合评估模型的性能:
F1分数 = 2 × (精确度 × 召回率) ÷ (精确度 + 召回率)
当精确度和召回率都重要的时候,F1分数会是一个有用的指标。不过,F1分数并没有直接反映假负例的情况,因此也不应将其视为适用于所有业务问题的最佳评估标准。
ROC-AUC曲线
ROC-AUC曲线用于衡量模型在不同分类阈值下,将正样本区分开来的能力。当ROC-AUC曲线的值接近1时,说明模型的分类性能非常好;而当该值接近0.5时,则说明模型的分类性能与随机排序的结果相似。
ROC-AUC并不能告诉你某个特定的阈值是否适合用于营销活动。当正例数据较为稀少时,精确度-召回率分析也可能提供有用的信息。无论哪种情况,都应在未用于训练模型的数据上对模型进行评估。
在Python中计算这些指标
你可以使用scikit-learn来计算其中的一些指标:
from sklearn.metrics import (
    accuracy_score,
    precision_score,
    recall_score,
    f1_score,
    roc_auc_score,
    confusion_matrix
)

predictions = model.predict(X_test)

print("准确率:", accuracy_score(y_test, predictions))
print(
    "精确度:",
    precision_score(
        y_test, predictions, zero_division=0
    )
)
print(
    "召回率:",
    recall_score(
        y_test, predictions, zero_division=0
    )
)
print(
    "F1分数:")
    f1_score(
        y_test, predictions, zero_division=0
    )
)
print("混淆矩阵:")
print(confusion_matrix(y_test, predictions))
对于ROC-AUC来说,应该使用模型生成的概率估计值或决策分数,而不是最终的预测标签:
probabilities = model.predict_proba(X_test)[:, 1]

print(
    "ROC-AUC:",
    roc_auc_score(y_test, probabilities)
)
这一方法的前提是模型支持`predict_proba()`函数,并且正类是由概率值中的第二列表示的。请根据你使用的具体模型和目标标签,确认类别的排序方式是否正确。
选择合适的评估指标
并没有一种适用于所有情况的最佳分类评估指标。合适的选择取决于具体的目标、数据中的类别分布以及不同错误类型所带来的影响。
例如,预算有限的客户保留团队可能会优先考虑精确度,因为他们只能联系到少数客户;而如果错过高风险客户会带来重大损失,那么另一个团队则可能会更重视召回率。
在选择评估指标之前,先思考该模型所能辅助做出的业务决策。一个有用的评估结果不仅应该能说明模型的表现如何,还应该表明它的错误在特定应用场景中是否可以接受。
这里的关键在于:准确率仅仅是模型评估的一个方面。精确度、召回率、F1分数、ROC-AUC以及混淆矩阵这些指标能够揭示模型性能的不同层面,帮助我们将模型质量与实际业务效果联系起来。
第37章:利用机器学习进行客户细分
基于规则的客户细分方法是根据预先定义的条件来对客户进行分类的。而机器学习提供了另一种方法——聚类分析。聚类算法会寻找数据中的模式,然后将具有相似特征或距离值的观测对象归为同一组。
对于营销团队来说,聚类分析可以帮助他们发现那些购买行为、消费水平或互动模式相似的客户群体。这些分组结果可以为后续的分析提供起点,但它们本身并不一定能代表有实际意义的客户类型。
使用K-Means聚类算法
K-Means是一种聚类算法,它将观测数据分成指定数量的簇。该算法会反复将观测值分配到相应的簇中心,并不断更新这些中心的位置,以降低同一簇内各数据点之间的距离。
在这个例子中,假设数据集中已经为每位客户记录了一行信息,且数据包含最近购买频率、购买频次以及消费金额这三列字段。
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

features = df[
    [
        "recentness",
        "frequency",
        "monetary"
    ]
].copy()

scaler = StandardScaler()

scaled_features = scaler.fit_transform(
    features
)

model = KMeans(
    n_clusters=4,
    random_state=42,
    n_init=10
)

df["segment"] = model.fit_predict(
    scaled_features
)
在这个例子中,我们在进行聚类之前先对这三列数据进行了标准化处理。这样做是必要的,因为消费金额在数值上可能远大于最近购买频率或购买频次;如果不进行标准化处理,那些数值范围较大的字段就会影响距离计算的结果。
标准化只是改变了输入变量的量纲,并不会使这些变量从商业角度来看变得同等重要。如果数据中存在极端值,那么还需要进一步考虑是否适合使用标准化方法,以及这些特征是否需要额外的预处理步骤。
设置n_clusters=4意味着K-Means算法会生成四个簇。该算法会为每位客户分配一个数字标签,而代码会将这些标签存储在segment列中。
簇编号仅是标识符,并不代表优劣等级
标签0、1、2和3仅仅是对这四个簇的标识,并不表示某个簇就一定比另一个簇更好或更有价值。
这些数字并不代表客户的质量或等级。如果使用不同的参数或数据重新运行模型,即使整体分组模式相似,分配给各簇的数字标签也可能有所不同。
要想了解每个簇所代表的含义,就需要总结每个簇中客户的原始特征值:
cluster_summary = (
    df.groupby("segment")
    .agg(
        customer_count=("segment", "size"),
        average_recency=("recentness", "mean"),
        average_frequency=("frequency", "mean"),
        average_monetary=("monetary", "mean")
    )
    .round(2)
)

print(cluster_summary)
通过这份汇总数据,我们可以了解每个簇中客户的典型特征。例如,某个簇可能包含购买频率较高、最近购买时间较近的客户,而另一个簇则可能由那些购买频次较低、距离上次购买已经间隔很长时间的客户组成。
根据观察到的这些模式,可以为这些簇起一些描述性的名称;当然,这样的命名必须以数据为依据。比如,对于那些购买频率高且最近购买时间较近的客户群体,可以将其称为“高频活跃客户”;而对于那些最近购买次数较多、消费金额也较高的客户群体,则值得进一步研究如何重新吸引他们继续使用你的服务。
不要仅根据簇编号来为这些簇命名。应该仔细检查实际数据,确保所选择的名称能够准确反映该簇的行为特征。
选择与评估聚类结果
聚类的数量其实是一个需要根据具体需求来决定的建模参数。对于某个数据集来说,四个簇可能比较合适;但对于另一个数据集而言,这个数字可能就不适用了。你可以使用“肘部法则”或“轮廓系数”等方法来比较不同的簇数设置,并同时判断这些分组结果是否具有实际意义,以及是否对业务分析有帮助。
聚类结果还会受到特征选择、数据缩放方法、异常值处理方式以及所选簇数的影响。因此,这些分组并不一定能够对应到真实的客户类型,而且不同的算法也可能产生不同的聚类结果。
关键在于:聚类分析能够帮助我们发现一些有用的模式,从而帮助我们更好地了解客户群体。不过,这些聚类的标签本身并没有内在的含义,我们需要通过分析每个簇的特征,并验证这些模式是否对业务有帮助,才能真正理解它们的意义。
第38章:特征工程
当原始数据被转化为有意义的特征后,机器学习模型的效果往往会得到显著提升。
假设你有如下这样的数据:
purchase_date如果你直接将原始的日期值输入到模型中,可能会得到不准确的结果;而如果你计算出“距离上次购买已过去的天数”这一特征,那么这个数值就会更有参考价值。
同样地,对于原始的交易记录,你也可以计算出“总订单数量”、“平均单笔订单金额”、“总支出金额”以及“距离首次购买已过去的天数”等特征,这些经过加工的特征能够更准确地反映客户的消费行为。
特征工程通常是机器学习项目中非常重要的一个环节。
第39章:避免数据泄露
当某些在模型进行预测时本不应被使用的信息影响了模型的训练或评估过程,就会发生数据泄露现象。这种泄露会导致模型在面对未来的真实数据时出现误导性的结果。
假设你正在构建一个模型,用来预测某位客户在未来30天内是否会进行购买。你的目标是通过当前可用的信息来推测这位客户在接下来的一个月里会采取什么行动。
但如果你不小心将客户在未来那个时间段内的实际购买结果作为输入数据,那么模型就会接收到本不应在预测时被使用的信息,这样就会导致评估结果的准确性大打折扣。
数据泄露的一个实例
假设某个数据集包含以下几列数据:
past_purchases
website_visits
purchased_next_30_days
前两列数据反映了客户的历史购买行为,而最后一列数据则记录了你需要预测的结果。
以下代码存在数据泄露问题:
# 错误做法:将目标变量作为输入特征包含在数据集中。
X = df[
    [
        "过去购买记录",
        "网站访问次数",
        "未来30天内是否会购买"
    ]
]

y = df["未来30天内是否会购买"]
目标变量“未来30天内是否会购买”同时出现在X和y中。模型得到的其实就是它本来就应该预测的结果。因此,该模型可能会获得非常高的评分,但这种评分并不能证明模型真的能够根据历史数据来预测未来的购买行为。
这就是典型的“直接目标变量泄露”现象。其他形式的数据泄露可能不那么明显,比如使用在预测日期之后收集到的信息,或者在将整个数据集分为训练集和测试集之前就对其进行预处理。
修复数据泄露问题
解决方法是将目标变量以及任何在预测时无法获取的信息从输入特征中剔除。
# 正确做法:只使用在预测之前可获取的信息。
X = df[
    [
        "过去购买记录",
        "网站访问次数"
    ]
]

y = df["未来30天内是否会购买"]
接下来,需要将数据集分为训练集和测试集:
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

model = RandomForestClassifier(
    random_state=42
)

model.fit(
    X_train,
    y_train
)

predictions = model.predict(
    X_test
)

print(
    "准确率:
accuracy_score(y_test, predictions)
这种做法更加安全,因为模型接收的只有X中指定的那两个历史特征。而“未来30天内是否会购买”这个目标变量仍然是模型需要预测的对象。
但是,仅仅将目标变量从输入特征中剔除还不够,还必须确保过去购买记录和网站访问次数这些字段中包含的是在预测日期之前发生的交易信息。如果其中任何一列包含了未来30天内的交易数据,仍然可能会发生数据泄露问题。
在预处理阶段防止数据泄露
在预处理过程中,如果使用了应该被保留下来用于评估的数据,也可能会导致数据泄露。例如,如果在将数据集分为训练集和测试集之前就使用整个数据集来计算缩放参数或填充缺失值,那么测试集中的信息就会影响训练过程的结果。
更安全的做法是仅使用训练数据来进行预处理操作,然后将处理后的结果应用到测试数据上。Scikit-learn提供的管道功能可以帮助实现这种分离机制。对于那些依赖于时间变化的预测问题,如果条件合适,应采用基于时间的划分方法:使用早期的观测数据来进行训练,而使用后期的观测数据来进行评估。这样才能更准确地反映在进行未来预测时所能够获取的信息。
实用的泄漏检查清单
在相信某个模型的评估结果之前,请先思考以下问题:
- 在预期的预测时间点,所有输入特征是否都已准备好?
- 是否有任何特征包含了目标变量本身或能够直接反映预测结果的指标?
- 预处理步骤是否仅使用了训练数据来拟合?
- 训练集与测试集的划分方式是否真实反映了实际的应用场景?
- 在数据划分过程中,是否存在某些记录或客户被重复计算,从而导致评估结果被人为夸大?
- 评估过程所使用的数据是否确实属于从未被模型见过的数据?
虽然得分很高并不一定意味着存在数据泄漏的问题,但这一情况确实提醒我们有必要仔细检查特征选择、数据收集流程以及评估方法的设计。
这里的关键在于:模型必须仅使用在预测时能够合法获取的信息来进行评估。防止数据泄漏有助于确保所报告的性能结果是真实可靠的,而不是被人为夸大的。
第八部分:构建营销智能系统
到目前为止,你们已经学习了许多单独的技术方法。现在,我们可以将这些方法结合起来使用了。
一个真正的营销智能系统不应该仅仅是一系列相互独立的Python脚本的集合,而应该具备清晰、逻辑严密的工作流程。
第一步:明确业务目标
在开始编写系统代码之前,首先需要确定这个系统应该解决哪些问题。
对于我们的最终项目来说,我们需要探讨以下问题:
- 我们的营销活动产生了多少收入?
- 哪些传播渠道的效果最好?
- 哪些营销活动的表现最为突出?
- 哪些活动可能需要重点关注?
- 哪些客户最具价值?
- 哪些客户可能需要重新进行互动或联系?
- 客户在哪个环节退出了销售流程?
- 是否存在具有特定特征的客户群体?
系统的性能随时间发生了怎样的变化?
机器学习技术能否识别出那些有可能流失的客户?
该系统能否自动生成报告?
当关键指标发生变化时,系统能否及时提醒营销团队?
这些问题将决定整个项目的架构设计。
第二步:确定项目结构
一个实际可行的项目可以按照以下结构来组织:
marketing_intelligence/
    data/
        raw/
        processed/

    reports/

    notebooks/

    models/

    src/
        data_loader.py
        cleaning.py
        metrics.py
        customer_analysis.py
        campaign_analysis.py
        segmentation.py
        reporting.py
        alerts.py

    tests/

    main.py

    requirements.txt
你不必在第一天就创建整个结构。这样做的目的是为了展示一个大型项目最终是如何被组织起来的。
步骤3:数据加载模块
创建文件:
src/data_loader.py然后编写代码:
import pandas as pd


def load_marketing_data(path):
    return pd.read_csv(path)
现在,主程序可以导入这个模块来使用它:
from src.data_loader import (
    load.marketing_data
)

df = loadMARKeting_data(
    "data/raw/marketing_data.csv"
)
这样就可以将数据加载逻辑与分析逻辑分开来处理了。
步骤4:数据清洗模块
创建文件:
src/cleaning.py然后编写代码:
import pandas as pd


def clean_marketing_data(df):
    df = df.copy()

    df = df.drop_duplicates()

    df["date"] = pd.to_datetime(
        df["date"],
        errors="coerce"
    )

    numeric_columns = [
        "impressions",
        "clicks",
        "conversions",
        "cost",
        "revenue"
    ]

    for column in numeric_columns:
        df[column] = pd.to_numeric(
            df[column],
            errors="coerce"
        )

    df["channel"] = (
        df["channel"]
        .str.strip()
        .str.lower()
    )

    return df
这个函数用于执行常见的数据清洗操作。
步骤5:指标计算模块
创建文件:
src/metrics.py然后编写代码:
def calculate_metrics(df):
    df = df.copy()

    df["ctr"] = (
        df["clicks"]
        .div(
            df["impressions"]
            .replace(0, None)
        )
        .mul(100)
    )

    df["conversion_rate"] = (
        df["conversions"]
        .div(
            df["clicks"]
            .replace(0, None)
        )
        .mul(100)
    )

    df["cpc"] = (
        df["cost"]
        .div(
            df["clicks"]
            .replace(0, None)
        )
    )

    df["cpa"] = (
        df["cost"]
        .div(
            df["conversions"]
            .replace(0, None)
        )
    )

    df["roas"] = (
        df["revenue"]
        .div(
            df["cost"]
            .replace(0, None)
        )
    )

    return df
现在,所有的指标计算逻辑都被集中放在了一个可以重复使用的文件中。
步骤6:活动分析模块
创建文件:
src/campaign_analysis.py然后编写代码:
def analyze_campaigns(df):
    summary = (
        df.groupby("campaign")
        .agg({
            "impressions": "sum",
            "clicks": "sum",
            "conversions": "sum",
            "cost": "sum",
            "revenue": "sum"
        })
    )

    summary["roas"] = (
        summary["revenue"] /
        summary["cost"]
    )

    summary["cpa"] = (
        summary["cost"] /
        summary["conversions"]
    )

    return summary.sort_values(
        "roas",
        ascending=False
    )
这样就可以得到一个可重复使用的活动效果分析表格。
步骤7:渠道分析
def analyze_channels(df):
    summary = (
        df.groupby("channel")
        .agg({
            "impressions": "sum",
            "clicks": "sum",
            "conversions": "sum",
            "cost": "sum",
            "revenue": "sum"
        })
    )

    summary["roas"] = (
        summary["revenue"] /
        summary["cost"]
    )

    summary["cpa"] = (
        summary["cost"] /
        summary["conversions"]
    )

    return summary.sort_values(
        "roas",
        ascending=False
    )
现在,活动分析和渠道分析已经被分开了,这样会让项目更易于维护。
步骤8:识别表现不佳的活动
可以创建一个可重复使用的规则来帮助完成这一分析:
def identify_underperforming_campaigns(
    campaign_summary,
    roas_threshold=1,
    conversion_threshold=2
):
    return campaign_summary[
        (campaign_summary["roas"] < roas_threshold) & (
            campaign_summary["conversion_rate"] < conversion_threshold
        )
    ]
但你有没有注意到一个问题?目前的活动分析数据中并没有计算转化率。
这个例子很好地说明了为什么在开发软件时必须验证自己的假设。
我们可以对代码进行修改,以便包含转化率的计算:
def analyze_campaigns(df):
    summary = (
        df.groupby("campaign")
        .agg({
            "impressions": "sum",
            "clicks": "sum",
            "conversions": "sum",
            "cost": "sum",
            "revenue": "sum"
        })
    )

    summary["conversion_rate"] = (
        summary["conversions"] / summary["clicks"] * 100
    )

    summary["roas"] = (
        summary["revenue"] / summary["cost"]
    )

    summary["cpa"] = (
        summary["cost"] / summary["conversions"]
    )

    return summary.sort_values(
        "roas",
        ascending=False
    )
这是一个非常重要的开发习惯:在构建下一阶段之前,必须先测试当前阶段的代码。
步骤9:建立客户情报层
客户情报层应该能够汇总客户层面的各种行为数据。
def analyze_customers(df):
    summary = (
        df.groupby("customer_id")
        .agg({
            "revenue": "sum",
            "conversions": "sum",
            "campaign": "count"
        })
        .rename(
            columns={
                "campaign": "purchase_activity"
            }
        )
    )

    summary["average_order_value"] = (
        summary["revenue"] / summary["purchase_activity"]
    )

    return summary
这使系统能够从客户的角度来分析问题。
步骤10:识别高价值客户
我们可以制定一条简单的规则:
def identify_high_value_customers(
    customer_summary,
    threshold=5000
):
    return customer_summary[
        customer_summary["revenue"]
        >= threshold
    ]
需要再次强调的是,这个阈值并不是通用的。
对于某家公司来说,5,000美元的阈值可能比较合适,但对另一家公司而言则可能不切实际。
一个功能强大的营销分析系统应该能够让用户自行设置这些关键阈值。
步骤11:推荐系统
现在我们可以开始生成推荐建议了。
def generate_channel_recommendation(
    row
):
    if row["roas"] >= 4:
        return (
            "表现优异。"
            "应考虑扩大规模以提高效率。"
        )

    if row["roas"] >= 2:
        return (
            "表现中等。"
            "继续关注并测试优化方案。"
        )

    return (
        "回报较低。在增加投入之前,需重新审视目标定位、创意内容、成本控制以及转化效果。"
    )
应用这个规则的方法如下:
channel_summary[
    "recommendation"
] = channel_summary.apply(
    generate_channel_recommendation,
    axis=1
)
这就是一个基于规则的简单分析系统。
它并不会假装Python本身就知道完美的营销策略,而是将预先定义好的分析条件转化为对决策者有用的提示信息。
顶点项目:构建Python营销分析平台
这个顶点项目是将本书中所学的所有知识综合应用起来的最终成果。
你将构建一个基于Python的系统,该系统能够将原始的营销数据转化为结构化、易于分析的报告。
- Python基础知识
- pandas库
- 数据清洗技术
- 营销关键绩效指标
- 活动效果分析工具
- 渠道运营分析模块
- 客户行为分析系统
- RFM客户细分方法
- 群体分析技术
- 销售漏斗分析工具
- 数据可视化功能
- 自动化警报机制
- 机器学习算法 >
- 报告生成系统
- 自动化操作流程
我们的目标并不是创建一个能够“神奇地”了解客户需求的虚构“AI营销平台”,而是要构建一个实际可用、功能完备的分析系统。
项目目标
这个系统应该能够回答以下问题:
“我们的营销数据中发生了什么?哪些方面需要重点关注?我们能提供哪些证据来支持接下来的决策?”
这就是整个项目背后的核心问题。
步骤1:创建数据集
出于学习目的,我们可以这样生成合成数据:
import random
import pandas as pd

random.seed(42)

campaigns = [
    "春季促销",
    "夏季促销",
    "开学季优惠",
    "节日促销"
]

channels = [
    "电子邮件",
    "搜索",
    "社交媒体",
    "展示广告"
]

rows = []

for _ in range(5000):
    impressions = random.randint(
        1000,
        50000
    )

    clicks = random.randint(
        20,
        5000
    )

    conversions = random.randint(
        0,
        500
    )

    cost = round(
        random.uniform(
            100,
            5000
        ),
        2
    )

    revenue = round(
        random.uniform(
            100,
            15000
        ),
        2
    )

    rows.append({
        "customer_id": random.randint(
            1,
            1000
        ),
        "campaign": random.choice(
            campaigns
        ),
        "channel": random.choice(
            channels
        ),
        "impressions": impressions,
        "clicks": clicks,
        "conversions": conversions,
        "cost": cost,
        "revenue": revenue
    })

df = pd.DataFrame(rows)

df.to_csv(
    "marketing_data.csv",
    index=False
)
这样我们就得到了一个初始的数据集。
步骤2:加载数据
df = pd.read_csv(
    "marketing_data.csv"
)
立即查看数据内容:
print(df.head())
print(df.shape)
print(df.info())
步骤3:验证数据
检查缺失值的情况:
print(
    df.isnull().sum()
)
检查重复记录:
print(
    df.duplicated().sum()
)
检查各个渠道的相关数据:
print(
    df["channel"].value_counts()
)
还要检查各种促销活动的数据情况:
print(
    df["campaign"].value_counts()
)
我们的目标是弄清楚究竟有哪些信息被输入到了系统中。
步骤4:清洗数据
df = df.drop_duplicates()

numeric_columns = [
    "impressions",
    "clicks",
    "conversions",
    "cost",
    "revenue"
]

for column in numeric_columns:
    df[column] = pd.to_numeric(
        df[column],
        errors="coerce"
    )

df["channel"] = (
    df["channel"]
    .str.strip()
    .str.lower()
)
现在,数据已经准备好用于后续的分析环节了。
步骤5:计算关键绩效指标
df["ctr"] = (
    df["clicks"] /
    df["impressions"] *
    100
)

df["conversion_rate"] = (
    df["conversions"] /
    df["clicks"] *
    100
)

df["cpc"] = (
    df["cost"] /
    df["clicks"]
)

df["cpa"] = (
    df["cost"] /
    df["conversions"]
)

df["roas"] = (
    df["revenue"] /
    df["cost"]
)
在最终版本中,我们必须确保所有数据字段的值都不会为零。
步骤6:制作渠道报告
channel_summary = (
    df.groupby("channel")
    .agg({
        "impressions": "sum",
        "clicks": "sum",
        "conversions": "sum",
        "cost": "sum",
        "revenue": "sum"
    })
)
接下来,进行以下操作:
channel_summary["ctr"] = (
    channel_summary["clicks"] /
    channel_summary["impressions"] *
    100
)

channel_summary["conversion_rate"] = (
    channel_summary["conversions"] /
    channel_summary["clicks"] *
    100
)

channel_summary["roas"] = (
    channel_summary["revenue"] /
    channel_summary["cost"]
)

channel_summary["cpa"] = (
    channel_summary["cost"] /
    channel_summary["conversions"]
)
最后对结果进行排序:
channel_summary = (
    channel_summary
    .sort_values(
        "roas",
        ascending=False
    )
)
步骤7:制作活动报告
campaign_summary = (
    df.groupby("campaign")
    .agg({
        "impressions": "sum",
        "clicks": "sum",
        "conversions": "sum",
        "cost": "sum",
        "revenue": "sum"
    })
)
然后计算相关指标:
campaign_summary["ctr"] = (
    campaign_summary["clicks"] /
    campaign_summary["impressions"] *
    100
)

campaign_summary["conversion_rate"] = (
    campaign_summary["conversions"] /
    campaign_summary["clicks"] *
    100
)

campaign_summary["roas"] = (
    campaign_summary["revenue"] /
    campaign_summary["cost"]
)

campaign_summary["cpa"] = (
    campaign_summary["cost"] /
    campaign_summary["conversions"]
)
现在你可以根据各项指标对活动进行排序了。
campaign_summary.sort_values(
    "roas",
    ascending=False
)
步骤8:制作客户报告
customer_summary = (
    df.groupby("customer_id")
    .agg({
        "revenue": "sum",
        "conversions": "sum",
        "campaign": "count"
    })
)
将“活动类型”这一列的名称进行修改:
customer_summary = (
    customer_summary
    .rename(
        columns={
            "campaign": "purchase_activity"
        }
    )
)
计算平均订单金额:
customer_summary[
    "average_order_value"
] = (
    customer_summary["revenue"] /
    customer_summary[
        "purchase_activity"
    ]
)
步骤9:客户细分
创建基于RFM模型的分析指标。
rfm = customer_summary.copy()

rfm["frequency"] = (
    rfm["purchase_activity"]
)

rfm["monetary"] = (
    rfm["revenue"]
)
如果你的数据集中包含了实际的购买日期,那么就需要添加“最近性”这一维度:
today = pd Timestamp("2026-09-05")
last_purchase = (
    df.groupby("customer_id")[
        "purchase_date"
    ].max()
)

rfm["recency"] = (
    today - last_purchase
).dt.days
之后,就可以对客户进行排序了。
rfm["monetary_score"] = pd.qcut(
    rfm["monetary"],
    5,
    labels=False,
    duplicates="drop"
) + 1
同样的方法也可以应用于“频率”和“最近性”这两个维度上。
步骤10:创建客户细分群体
你可以定义一些简单的行为分类标准。
例如:
def classify_customer(row):
    if (
        row["monetary"] >= 5000 and
        row["frequency"] >= 5
    ):
        return "高价值客户"

    if row["frequency"] >= 5:
        return "频繁购买客户"

    if row["monetary"] >= 5000:
        return "高消费客户"

    return "发展中的客户"
然后,就可以将这些分类结果应用到数据集中:
rfm["segment"] = (
    rfm.apply(
        classify_customer,
        axis=1
    )
)
最后,对各个细分群体的特征进行总结:
segment_summary = (
    rfm.groupby("segment")
    .agg({
        "monetary": "平均金额",
        "frequency": "购买频率"
    })
)
现在,营销团队就可以了解每个细分群体的特点了。
步骤11:构建营销漏斗分析模型
需要向数据集中添加关于客户转化过程的信息。
例如:
funnel = {
    "访问者数量": 50000,
    "产品浏览次数": 32000,
    "加入购物车次数": 9000,
    "完成结账次数": 4500,
    "实际购买次数": 2700
}
接下来,计算各个转化环节的转化率:
funnel_rates = {}

previous = None

for stage, value in funnel.items():

    if previous is None:
        funnel_rates[stage] = 100
    else:
        funnel_rates[stage] = (
            value / previous * 100
        )

    previous = value
这样就可以得到一个简单的营销漏斗分析结果。
步骤12:制作数据可视化图表
按渠道划分的收入情况:
import matplotlib.pyplot as plt

channel_summary["revenue"].plot(kind="bar")

plt.title("各营销渠道的收入情况")

plt.xlabel("营销渠道")
plt.ylabel("收入金额")

plt.tight_layout()
plt.show()
按渠道划分的ROAS情况:
channel_summary["roas"].plot KIND="bar")

plt.title("各营销渠道的ROAS情况")

plt.xlabel("营销渠道")
plt.ylabel("ROAS")

plt.tight_layout()
plt.show()
客户价值分布情况:
plt.hist(rfm["monetary"], bins=30)

plt.title("客户的货币价值分布")

plt.xlabel("客户收入金额")
plt.ylabel("客户数量")

plt.tight_layout()
plt.show()
步骤13:创建性能警报
假设ROAS低于1被视为警告信号。
alerts = []

for channel, row in (
    channel_summary.iterrows()
):

    if row["roas"] < 1:
        alerts.append(
            f"{channel}: ROAS低于1。
        )
显示这些警报:
for alert in alerts:
    print(alert)
你还可以发现转化率或收入的突然变化。
步骤14:创建推荐方案
recommendations = []

for channel, row in (
    channel_summary.iterrows()
):

    if row["roas"] >= 4:
        recommendations.append(
            f"{channel}: ROAS很高。"
            "请研究该渠道是否可以
           高效地扩大规模。"
        )

    elif row["roas"] < 1:
        recommendations.append(
            f"{channel}: ROAS低于盈亏平衡点。
            "请重新评估目标定位、创意设计、
           成本控制以及转化效果。"
        )

    else:
        recommendations.append(
            f"{channel}:表现中等。"
            "继续进行测试和优化。"
        )
这样就能为最终报告增添分析层和预测功能。
步骤15:应用机器学习技术
一旦分析系统开始运行,我们就可以添加预测功能了。
假设数据集中包含一个名为churned的列。
选择相关特征:
features = [
    "purchase_frequency",
    "total_spend",
    "email_opens",
    "website_sessions"
]

X = df[features]
y = df["churned"]
将数据集分为训练集和测试集:
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.2,
        random_state=42
    )
)
进行训练:
from sklearn.linear_model import LogisticRegression

model = LogisticRegression(
    max_iter=1000
)

model.fit(
    X_train,
    y_train
)
进行预测:
predictions = model.predict(
    X_test
)
评估预测结果:
from sklearn.metrics import classification_report

print(
    classification_report(
        y_test,
        predictions
    )
)
现在,这个模型就成为了额外的智能分析工具。
步骤16:导出报告
with pd.ExcelWriter(
    "marketing_intelligence_report.xlsx"
) as writer:

    df.to_excel(
        writer,
        sheet_name="Processed Data",
        index=False
    )

    channel_summary.to_excel(
        writer,
        sheet_name="Channels"
    )

    campaign_summary.to_excel(
        writer,
        sheet_name="Campaigns"
    )

    customer_summary.to_excel(
        writer,
        sheet_name="Customers"
    )

    rfm.to_excel(
        writer,
        sheet_name="Segments"
    )
现在,该系统能够生成可重复使用的报告。
步骤17:将项目转变为流程化系统
最后的步骤就是将所有这些组件整合到一起。
最终,这个主程序在功能上应该呈现出如下结构:
from src.data_loader import (
    load_marketing_data
)

from src.cleaning import (
    clean.marketing_data
)

from src.metrics import (
    calculate_metrics
)

from src.campaign_analysis import (
    analyze_campaigns
)

from src.channel_analysis import (
    analyze_channels
)

from src.customer_analysis import (
    analyze_customers
)


def main():

    df = load_marketing_data(
        "data/raw/marketing_data.csv"
    )

    df = clean.marketing_data(df)

    df = calculate_metrics(df)

    campaigns = analyze_campaigns(
        df
    )

    channels = analyze_channels(
        df
    )

    customers = analyze_customers(
        df
    )

    print(
        "市场情报分析 "
        "已完成."
    )


if __name__ == "__main__":
    main()
这就是我们希望这个最终成果能够达到的目标。
与那些由数百个相互独立的部分组成的庞大脚本不同,这个系统是由一系列可重复使用的组件构成的。
是什么让这成为一个市场情报系统?
在这个阶段,我们有必要停下来思考一下。我们不仅仅编写了一份报告,这个系统实际上能够完成很多任务,比如:
- 导入数据
- 验证数据的准确性
- 清洗数据
- 转换数据格式
- 计算关键绩效指标
- 分析各种营销渠道
- 分析各类营销活动
- 分析客户信息
- 对客户进行分类
- 研究销售流程 >
- 发现存在的问题
- 提出相应的建议
- 运行预测模型
- 导出报告
正是这些功能的组合,使得这个项目成为一个真正的市场情报系统,而不仅仅是一个简单的分析工具。
该系统能够将原始信息转化为结构化的数据,进而帮助人们做出决策。
系统目前还无法做到什么
即使是一个先进的市场情报系统,也存在着一些局限性。
- 它无法自动理解某项营销活动取得成功的原因。
- 它无法仅凭客户购买了产品就判断他们是否满意。
- 它也不能保证机器学习模型的预测结果一定是正确的。
- 在没有具体的业务背景信息的情况下,它无法确定最佳的营销策略。
- 它更不能取代市场营销人员的工作。
它的作用仅仅是提供有依据的参考信息。这一点必须始终作为这个项目的核心理念。
最后的挑战
一旦你完成了这个基础性的项目,还有很多方法可以对其进行改进。例如:
- 添加数据库
- 连接外部API
- 实现自动调度功能
- 创建数据仪表盘
- 加入群体分析功能
- 优化客户流失风险分类模型
- 训练预测模型 >
- 添加模型评估机制
- 设置自动提醒功能
- 生成PDF格式的报告
- 发送授权通知
- 编写单元测试代码
- 创建配置文件,以便在不修改源代码的情况下调整阈值
最终,这个项目应该能够成为构建内部营销分析工具的基础。
这才是这个总结性项目的真正目的——它证明了你可以将本书中学习到的各种技术结合起来,形成一个完整的系统。
结论 / 后续步骤
学习Python用于营销并不意味着你需要死记硬背Python的语法,而是意味着你需要学会用不同的方式来思考营销问题。
电子表格可以告诉你发生了什么,但Python能帮助你探究其中的原因;分析仪表板可以显示收入下降了,但Python的工作流程可以帮助确定是哪些渠道、活动、客户群体或时间段导致了这一变化;手工制作的报告可以总结过去的情况,但自动化的智能系统能够持续监控各种动态,并将重要的变化信息及时呈现给相关人员。
这种逐步进步的过程才是真正的机会所在。
在总结性项目之后继续前进
这个总结性项目不应该是你完成的最后一个项目,而应该是一个能让你有信心去开展下一个项目的起点。
把这个系统拆解开来,了解它的每一个功能,改变所使用的指标,有意识地修改代码。
尝试使用不同的数据集,添加一些新的功能,或者删除某些功能。
验证你的假设,然后重新构建这个系统。目标是要培养自己解决新问题的能力。
打造自己的营销分析作品集
当你对Python熟练掌握了之后,可以考虑再做一些规模较小的项目。
例如:
- 活动效果分析工具:编写一个程序,导入活动数据并自动计算关键绩效指标。
- 客户细分系统:构建一个基于客户行为的RFM分析系统。
- 营销漏斗分析工具:分析用户在转化过程中在哪个环节退出了流程。
- A/B测试辅助工具:开发一个可以比较两组实验结果并生成相关统计数据的工具。
- 营销报告自动生成器:实现自动定期生成营销报告的功能。
- 客户流失预测模型:训练一个机器学习模型,用来识别那些可能面临流失风险的客户。
每个项目都能体现不同的技能,但它们共同构成了一个作品集,证明你的能力远不止掌握Python语法而已。
始终把业务需求放在首位
在学习技术时,最容易犯的错误之一就是从工具本身开始学习。
你可能会想:“我学会了pandas,用它能做什么呢?”
但更应该问的是:“pandas能帮助我解决什么样的营销问题呢?”
同样的原则也适用于机器学习。
不要一开始就说“我想使用机器学习”,而应该先思考“我们需要预测哪些客户可能会流失”。
只有确定了这一点之后,再判断机器学习是否真的适合解决这个问题。
技术应该是为了解决问题而存在的,而不是为了证明某种技术的必要性而创造问题。
数据素养是一种营销技能
你并不需要成为数据科学家才能从数据素养中受益。
你应该能够自如地提出以下这些问题:
- 这个数字是从哪里得来的?
- 这个指标具体衡量的是什么?
- 分母是多少?
- 这些数据是如何收集的?
- 有哪些信息缺失了?
- 是否存在偏见?
- 这是相关性还是因果关系?
- 样本量是否足够大?
- 这个结果对业务来说真的有意义吗?
这些问题往往比掌握某个Python库更为重要。
Python能为你带来巨大优势
那些能够手动分析数据集的营销人员也可以完成分析工作,但那些会使用Python的营销人员可以将这种分析过程转化为可重复使用的自动化流程。
他们不仅可以分析一份报告,还可以分析数百份报告;不必手动计算各种指标,而是可以编写相应的函数;无需每天早上都手动检查各项数据,而是可以创建自动化的监控系统;他们不仅能汇报已经发生的事情,还能构建模型来预测未来可能发生的情况。
这就是所谓的“优势”。
营销分析的未来
营销技术会不断发展,新的平台会出现,现有的API也会发生变化。
机器学习模型会不断完善,人工智能也会越来越多地融入营销工作流程中。
但一些基本的技能始终会具有价值:理解数据、提出恰当的问题、设计实验、解读结果、编写可靠的代码、传达洞察力、批判性地分析预测结果,以及保护客户信息。
这些技能并不依赖于任何特定的平台。
结语
在使用Python之前,你并不需要先成为一名程序员。可以从一个具体问题入手,找到相关数据,编写一个小程序,犯错并加以修改,然后不断改进这个程序。
最终,这些小程序会发展成工作流程,这些工作流程会变成系统,而这些系统则会成为帮助我们了解客户、优化营销活动、自动化重复性工作以及做出更明智决策的强大工具。
Python是工具,营销是应用场景,数据则是支持这些活动的证据。真正的能力在于将这三者有机地结合起来。
祝编程愉快!
相关文章
PingCAP系统发生安全漏洞,导致客户信息及源代码被泄露
PingCAP最近确认,其内部系统遭到了未经授权的访问,同时源代码以及与客户相关的数据也被盗取。攻击者是一个名为FulcrumSec的网络勒索组织,他们声称窃取了总计10.6 TB的数据,这些数据包括TiDB Cloud的控制平面记录、客户的SQL语句、API密钥、连接日志、账单信息、内部文档,以及413个私有的源代码仓库。 作者:Renato Losio
阅读全文
“从设计层面确保安全性”:在编写任何代码之前,如何将安全机制纳入系统架构之中
在大多数工程团队中,都会进行这样的对话——不过往往为时已晚。 想象一下:某个功能被部署到生产环境中之后,才会进行安全审查;或者在进行渗透测试时发现了问题;更糟糕的是,还会收到事故报告。 这些漏洞确实是存在的,修复它们也需要投入大量成本。而在这些讨论中,总会有人说:“我们需要为这个功能添加安全措施。” 但这个问题就出在这里:安全并不是事后才添加到软件中的东西,而应该从项目一开始就被纳入设计之中。一旦开始考虑为已经存在的东西添加安全功能,那就意味着你已经进入了“事故应对模式”。 “安全驱动设计”是一种完全不同的思维方式——在制定架构决策之前,就应该明确安全要求;在编写任何代码之前,就必须了解潜在的
阅读全文
如何将结构化数据(JSON-LD)添加到Next.js网站中并进行验证
结构化数据对搜索引擎来说一直都非常重要。当搜索引擎读取你的页面时,它看到的是HTML代码:标题、段落、日期以及名称等等。 结构化数据能够直接告诉搜索引擎这些内容的含义。例如,这个页面是一篇文章,这是它的标题,这篇文章是由某个人撰写的,并且发布于某个特定的日期。 对我来说,搜索引擎优化并不是一个需要简单勾选的步骤。我希望自己创建的产品和网站能够被人们找到,并且在被找到之后也能被正确理解。 因此,只要合适,我就会在每一页中添加结构化数据。而且我认为,随着人工智能系统开始根据网页内容来回答问题,结构化数据的重要性只会越来越明显,而不会减弱。 在Next.js应用程序中,没有任何工具会自动为你生成这些
阅读全文
掌握现代React路由技术:TanStack Router快速入门教程
在现代Web应用中,路由机制已经远远超越了仅仅根据URL路径来渲染组件的范畴。如今的开发者们渴望获得端到端的类型安全性、自动化的代码拆分功能、无缝的URL搜索参数管理机制,以及高效的数据获取方式,而无需被繁琐的`useEffect`钩子所困扰。 TanStack Router是一个功能强大的路由框架,它能够提供100%的TypeScript类型安全性,并确保在代码正式投入生产之前就能发现其中存在的错误。 我们最近在freeCodeCamp.org的YouTube频道上发布了一门全面的实践课程: TanStack Router课程——加载器、认证与类型安全的路由机制 ,该课程由Tapascrip
阅读全文