
这么多的数据, 这么多的格式: 转换服务, 1 部分
数据是许多活动的核心资源。处理数据的一个重要挑战是以正确的方式存储数据。我们需要 … Read More
Socrates
数据是许多活动的核心资源。处理数据的一个重要挑战是以正确的方式存储数据。我们需要选择一种格式, 这样就可以很容易地解决手头的问题。当使用相同的数据解决多个问题时, 这可能意味着必须以不同的格式提供相同的数据。有可能不同的参与者可以使用相同的数据块;他们可能是人或项目。这些可能更喜欢或需要使用不同的格式, 在这种情况下, 我们需要转换它们之间的数据。
例如, 您可能有一个程序在 XML 文件中生成一些数据, 但您需要使用期望 JSON 的 API 处理相同的数据。或者你需要与其他部门分享你部门生产的一些数据。问题是, 您的部门的同事希望以某种格式获得数据, 而 B 部门则坚持以另一种格式提供数据。
因此, 您需要在不同格式之间进行转换。这是一个常见的问题, 通常是可解的, 但它是一个重复的任务, 有几个微妙的注意。
作为工程师, 我们知道所有枯燥、容易出错的任务只是乞求一个聪明的解决方案。让我们尝试提供一个。
以多种格式处理数据
在不同格式之间进行转换可能有以下几个原因:
- 如果没有现成的库, 则分析新格式可能会很困难。
- 如果您想支持几种格式, 可能的转换的数量必须迅速爆炸。例如, 如果支持四格式, 则可以有12个不同的转换来处理。如果再添加一个新格式, 现在就有20种不同的转换来支持。
- 不同的格式可以以稍有不同的方式处理相同类型的数据。例如, 字符串始终
"以 JSON 格式在双引号 () 之间, 但它可能在双引号之间, 也可能不是 CSV 格式。在不同的格式中, 转义字符的规则可能类似, 但稍有不同。完全正确地获取所有这些细节需要大量的工作。 - 并非所有格式都兼容。例如, 可以将 CSV 数据转换为 JSON, 但反之亦然。这是因为 CSV 文件旨在表示齐次元素的列表。而 JSON 则可以包含其他数据结构, 如异构元素的集合。
这就是问题所在。现在, 假设您可以创建一个可以在不同格式之间转换的通用服务。通过这种方法, 您可以在每次进行即席转换时获得一些优势。
创建服务以在不同格式之间进行转换时, 您有一条装配线, 允许您从一种格式移动到另一种形式, 抽象出简单但复杂的细节。您还可以将您的装配线配置为执行各种有用的操作, 例如:
- 在生成的输出中强制执行特定规则。例如, 您可能需要指定具有特定数字的十进制数字的所有数字。
- 可以将以格式为 B 或反之亦然的单个文件中的多个文件中表示的数据组合在一起。
- 可以对数据应用筛选规则 (例如, 仅考虑 CSV 文件中的某些行以转换为 JSON)。
在本文中, 我们将只创建此服务的一个简单版本, 但这可以让您了解什么是可能的。
的设计
我们将创建一个简单的 REST API, 用于接收文件并将它们转换为指定的格式。为了限制我们需要处理的转换数, 我们将依赖内部中间表示。这样, 我们就需要将转换只写入和从中间表示形式。因此, 例如, 我们不会直接从 CSV 转换为 JSON
这种方法允许更大的灵活性, 因为为了实现一种新的格式, 我们只需要与我们的中间表示而不是任何特定格式进行交互。
我们不打算在本教程中这样做, 但另一个好处是, 通过使用中间表示, 我们可以很容易地在一个输出文件中合并不同的数据源。
因此, 工作流如下所示:
- 输入文件集 (通常只有一组) 被转换为通用数据结构。
- 一般数据结构转换为请求的输出格式 (例如, JSON), 生成一个或多个输出文件 (通常是一个)。
我们的内部数据格式很简单, 基本上, 在基础上, DataItem 它代表了我们数据的一个通用元素:
DataArray表示值列表 (例如,["one", "two"]但也[ {"name": "john"}, {"name": "mike"} ]DataObject表示一系列具有值的字段名称对 (例如,{"name": "john"}但也{"names": ["mike", "pike", "kite"]}DataValue用于包含单个值 (例如,5,"john")。这将是布尔值、数字和字符串。
因此, 复杂类, 像 DataArray 和 DataObject 可以包含其他元素, 并基本上允许一个树状组织。
关于物理中间格式的说明
现在, 您可能会问自己, 在内存中创建自定义表示形式是一回事, 但我们是否也应该创建自定义格式?嗯, 我们不需要它在我们的教程。但是, 如果我们正在建立一个生产系统, 根据需求, 我们可能需要创建一个自定义格式, 即, 一个专门设计的方式, 以有效地存储数据, 为我们的目的。
如果由于某种原因, 无法在单个进程中实现转换过程 (共享内存), 则此物理中间格式可能很有用。例如, 如果我们希望不同的可执行文件或不同的 web 服务执行解析以及所需输出的序列化, 则需要使这些组件进行通信。在这种情况下, 它们可能需要物理中间格式。
您可能会问: 对于代表任意数据结构, XML 是否完全正常?当然, 对于像这样的简单教程中考虑的案例, JSON 或 XML 将作为自定义中间格式工作正常。但是, 这可能不是真的或最佳的代表我们的假设服务的所有格式和功能。
不同的格式是为不同的东西设计的: 相同的图像可能以不同的格式表示, 但结果文件将具有不同的特征 (例如, JPEG 将小于 PNG)。通过设计我们的自定义表示, 我们可以更好地控制过程, 避免特定现有格式的任何怪癖, 并以最佳的方式为我们的服务保存任何数据。
例如, 我们可以采用一种格式来方便地处理数据上的转换 (例如, 通过存储对数据所做的不同操作)。设计自定义格式并不一定意味着要打乱字节: OpenDocument是一堆压缩文件, 其中的数据存储在具有特定属性和值的 XML 文件中。
这就是设计考虑的原因。让我们看看代码。
设置项目
我们将使用命令行程序创建一个新的 ASP.NET Web API 项目 dotnet 。
dotnew new webapi然后, 我们将添加必要的包来处理 JSON 和分析的事情。
dotnet add package Newtonsoft运行时. 标准 dotnet 添加包 Microsoft.CodeAnalysis.CSharp.Scripting
当然, 我们将使用 ANTLR 来分析这些文件。由于我们使用 visual Studio 代码, 我们还设置了令人敬畏的可视代码扩展, 以便在每次保存语法时自动生成一个 ANTLR 分析器。只需将此值放在项目的设置中即可。
{
    "antlr4.generation": {
        "language": "CSharp",
        "listeners": false,
        "visitors": false,
        "outputDir": "../",
        "package": "ParsingServices.Parsers"
    }
}
如果使用其他编辑器, 则需要为 ANTLR 工具提供正确的选项:
- 我们在命名空间内创建分析器 (Java 术语包)
ParsingServices.Parsers - 我们生成一个 c# 项目。
- 我们既不制造听众也不创造访客。
- 我们在语法上面的目录中生成解析器。
如果你不知道如何使用 ANTLR 我们已经编写了大量的教程, 你可以阅读入门与 ANTLR 在 c# 中, 如果你想要一个简短的介绍, 或我们的ANTLR 超级教程, 如果你想知道很多。
这些选项意味着我们的语法将位于一个 antlr/grammars 文件夹中, 而解析器将在文件夹内生成 antlr 。这使得一个干净的结构, 从生成的代码分离文法。
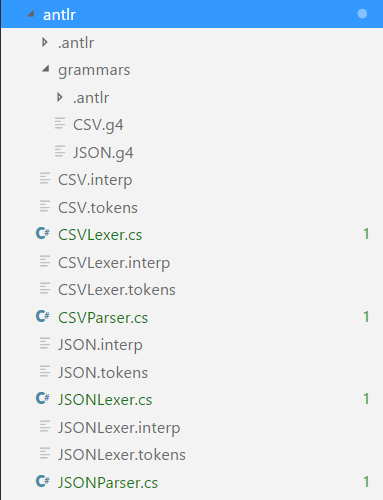
语法
说到 ANTLR 文法: 我们有两个, 一个用于 JSON, 另一个用于 CSV。两者都是从ANTLR 文法的存储库中取出的, 但我们已经对它们进行了修改, 以便清晰和一致。
grammar CSV;

csv     : hdr row+ ;
hdr     : row ;

row     : field (',' field)* '\r'? '\n' ;

field   : TEXT
        | STRING
        |
        ;

TEXT    : ~[,\n\r"]+ ;
STRING  : '"' ('""'|~'"')* '"' ; // quote-quote is an escaped quote
我们还有 JSON 语法, 以方便我们的工作在其余的程序。我们创建了一个独特的案例来区分简单的值 (例如 "number" : 5 ) 与复杂的值 (例如, "numbers" : [5, 3] 或 "number" : { "value": 1, "text": "one" } )。
grammar JSON;

json                    : complex_value ;

obj                     : '{' pair (',' pair)* '}'
                        | '{' '}'
                        ;

pair                    : STRING ':' (value | complex_value) ;

array                   : '[' composite_value (',' composite_value)* ']'
                        | '[' ']'
                        ;

composite_value         : value
                        | complex_value
                        ;

value                   : TRUE
                        | FALSE
                        | NULL
                        | STRING
                        | NUMBER
                        ;

complex_value           : obj
                        | array
                        ;

TRUE                    : 'true' ;
FALSE                   : 'false' ;
NULL                    : 'null' ;

STRING                  : '"' (ESC | SAFECODEPOINT)* '"' ;

fragment ESC            : '\\' (["\\/bfnrt] | UNICODE) ;

fragment UNICODE        : 'u' HEX HEX HEX HEX ;

fragment HEX            : [0-9a-fA-F] ;

fragment SAFECODEPOINT  : ~ ["\\\u0000-\u001F] ;

NUMBER                  : '-'? INT ('
..]
WS: [\n \r] +-> 跳过;
的数据类
在查看如何实现转换之前, 让我们来看看 Data* 构成我们的数据格式结构的类。我们已经解释了他们的一般设计之前, 所以在这里, 我们主要是看代码。
public class DataItem { }

public class DataValue : DataItem
{
    public string Text { get; set; } = "";
    public ValueFormat Format { get; set; } = ValueFormat.NoValue;
}

public class DataField : DataItem
{
    public string Text { get; set; } = "";
    public DataItem Value { get; set; } = null;
}

public class DataObject : DataItem
{
    public IList<DataField> Fields { get; set; } = new List<DataField>();

    [..]
}

public class DataArray : DataItem
{
    public IList<DataItem> Values { get; set; } = new List<DataItem>();

    [..]
}
我们删除了这些方法, 因为它们对于了解类的连接方式是多余的。正如您所看到的, 它们是非常直观的, 可能会看你期望他们如何。
public enum ValueFormat
{
    Bool,
    Integer,
    Numeric,
    String,
    NoValue
}ValueFormat是应表示数据的实际类型的枚举。这是因为我们将每个值视为字符串来简化输入和输出阶段, 因为字符串可以接受任何类型的输入。但我们知道, 实际上, 有不同类型的数据。因此, 我们尝试了解不同的格式在这里。
public class DataValue : DataItem
{
    private string _text = "";
    public string Text
    {
        get {
            return _text;
        }
        set {
            Format = DataValue.DetermineFormat(value);

            _text = DataValue.PrepareValue(Format, value);
        }
    }
    public ValueFormat Format { get; private set; } = ValueFormat.String;

    private static ValueFormat DetermineFormat(string text)
    {
        ValueFormat format = ValueFormat.String;

        text = text.Trim().Trim('"');

        int intNum;

        bool isInt = int.TryParse(text, out intNum);

        if(isInt)
            return ValueFormat.Integer;

        double realNum;

        bool isNum = double.TryParse(text, out realNum);

        if(isNum)
            return ValueFormat.Numeric;

        bool boolean;

        bool isBool = bool.TryParse(text, out boolean);

        if(isBool)
            return ValueFormat.Bool;

        return format;
    }
}
为了了解我们所管理的数据的真实类型, 我们尝试分析每个值, 直到找到匹配项。如果没有匹配的任何类型, 这意味着我们有一个字符串。我们需要找出真正的类型, 因为每种类型都可以用特定的格式不同地表示。例如, 在 JSON 中, 一个数字可以在不带括双引号的情况下编写, 而字符串总是需要它们。因此, 当我们以特定格式输出数据时, 将使用此信息。
我们解决的问题, 不同的格式可能代表相同的数据在输入阶段, 当我们转换原来的格式在我们自己的中间一个。例如, 字符串始终 " 以 JSON 格式在双引号 () 之间, 但它可能在双引号之间, 也可能不是 CSV 格式。我们必须清除输入中的所有数据, 以便在我们的自定义数据格式中具有标准的表示形式。
这部分将是对数据进行任何标准编辑的理想位置, 如确保所有数字都使用一个特定的十进制分隔符。因为我们想保持简单的东西, 我们只是修剪字符串的任何空白。
private static String PrepareValue(string text)
{
    text = text.Trim();

    return text;
}
这是所有的1部分