
Firestore是如何存储数据的,以及如何使用它来执行CRUD操作
大多数应用程序最终都需要存储和操作数据。如果你使用Firebase进行开发,那么这些数据就会存储在Firestore中——这是谷歌提供的一种灵活且可扩展的NoSQL文档数据库。 但在能够自信地创建、读取、更新或删除数据之前,你首先需要了解Firestore实际上是如何组织信息的。Firestore的结构与SQL数据库不同,如果将其视为SQL数据库来使用,那么最终结果很可能就是得到一个结构混乱、难以查询的数据模型。 在本教程中,你将学习 Firestore的NoSQL数据模型是如何工作的,然后通过使用Firebase Web SDK(v9及以上版本)来构建一个简单的任务管理应用程序,从而练习各种
大多数应用程序最终都需要存储和操作数据。如果你使用Firebase进行开发,那么这些数据就会存储在Firestore中——这是谷歌提供的一种灵活且可扩展的NoSQL文档数据库。
但在能够自信地创建、读取、更新或删除数据之前,你首先需要了解Firestore实际上是如何组织信息的。Firestore的结构与SQL数据库不同,如果将其视为SQL数据库来使用,那么最终结果很可能就是得到一个结构混乱、难以查询的数据模型。
在本教程中,你将学习 Firestore的NoSQL数据模型是如何工作的,然后通过使用Firebase Web SDK(v9及以上版本)来构建一个简单的任务管理应用程序,从而练习各种CRUD操作。学完之后,你将能够安全地添加任务、查询任务、更新嵌套字段和数组,以及删除数据,而不会留下任何孤立的子集合。
目录
先决条件
在开始之前,请确保你具备以下条件:
Node.js v18或更高版本(运行
node --version即可确认版本)一个Google账户,用于创建Firebase项目(本教程使用免费的Spark计划即可)
对JavaScript有基本的了解,包括
async/await以及ES模块的概念需要一个代码编辑器和终端环境
你不需要事先具备使用Firebase或NoSQL数据库的经验,因为本教程会从基础开始帮助你掌握这些知识。
Firestore的数据组织结构
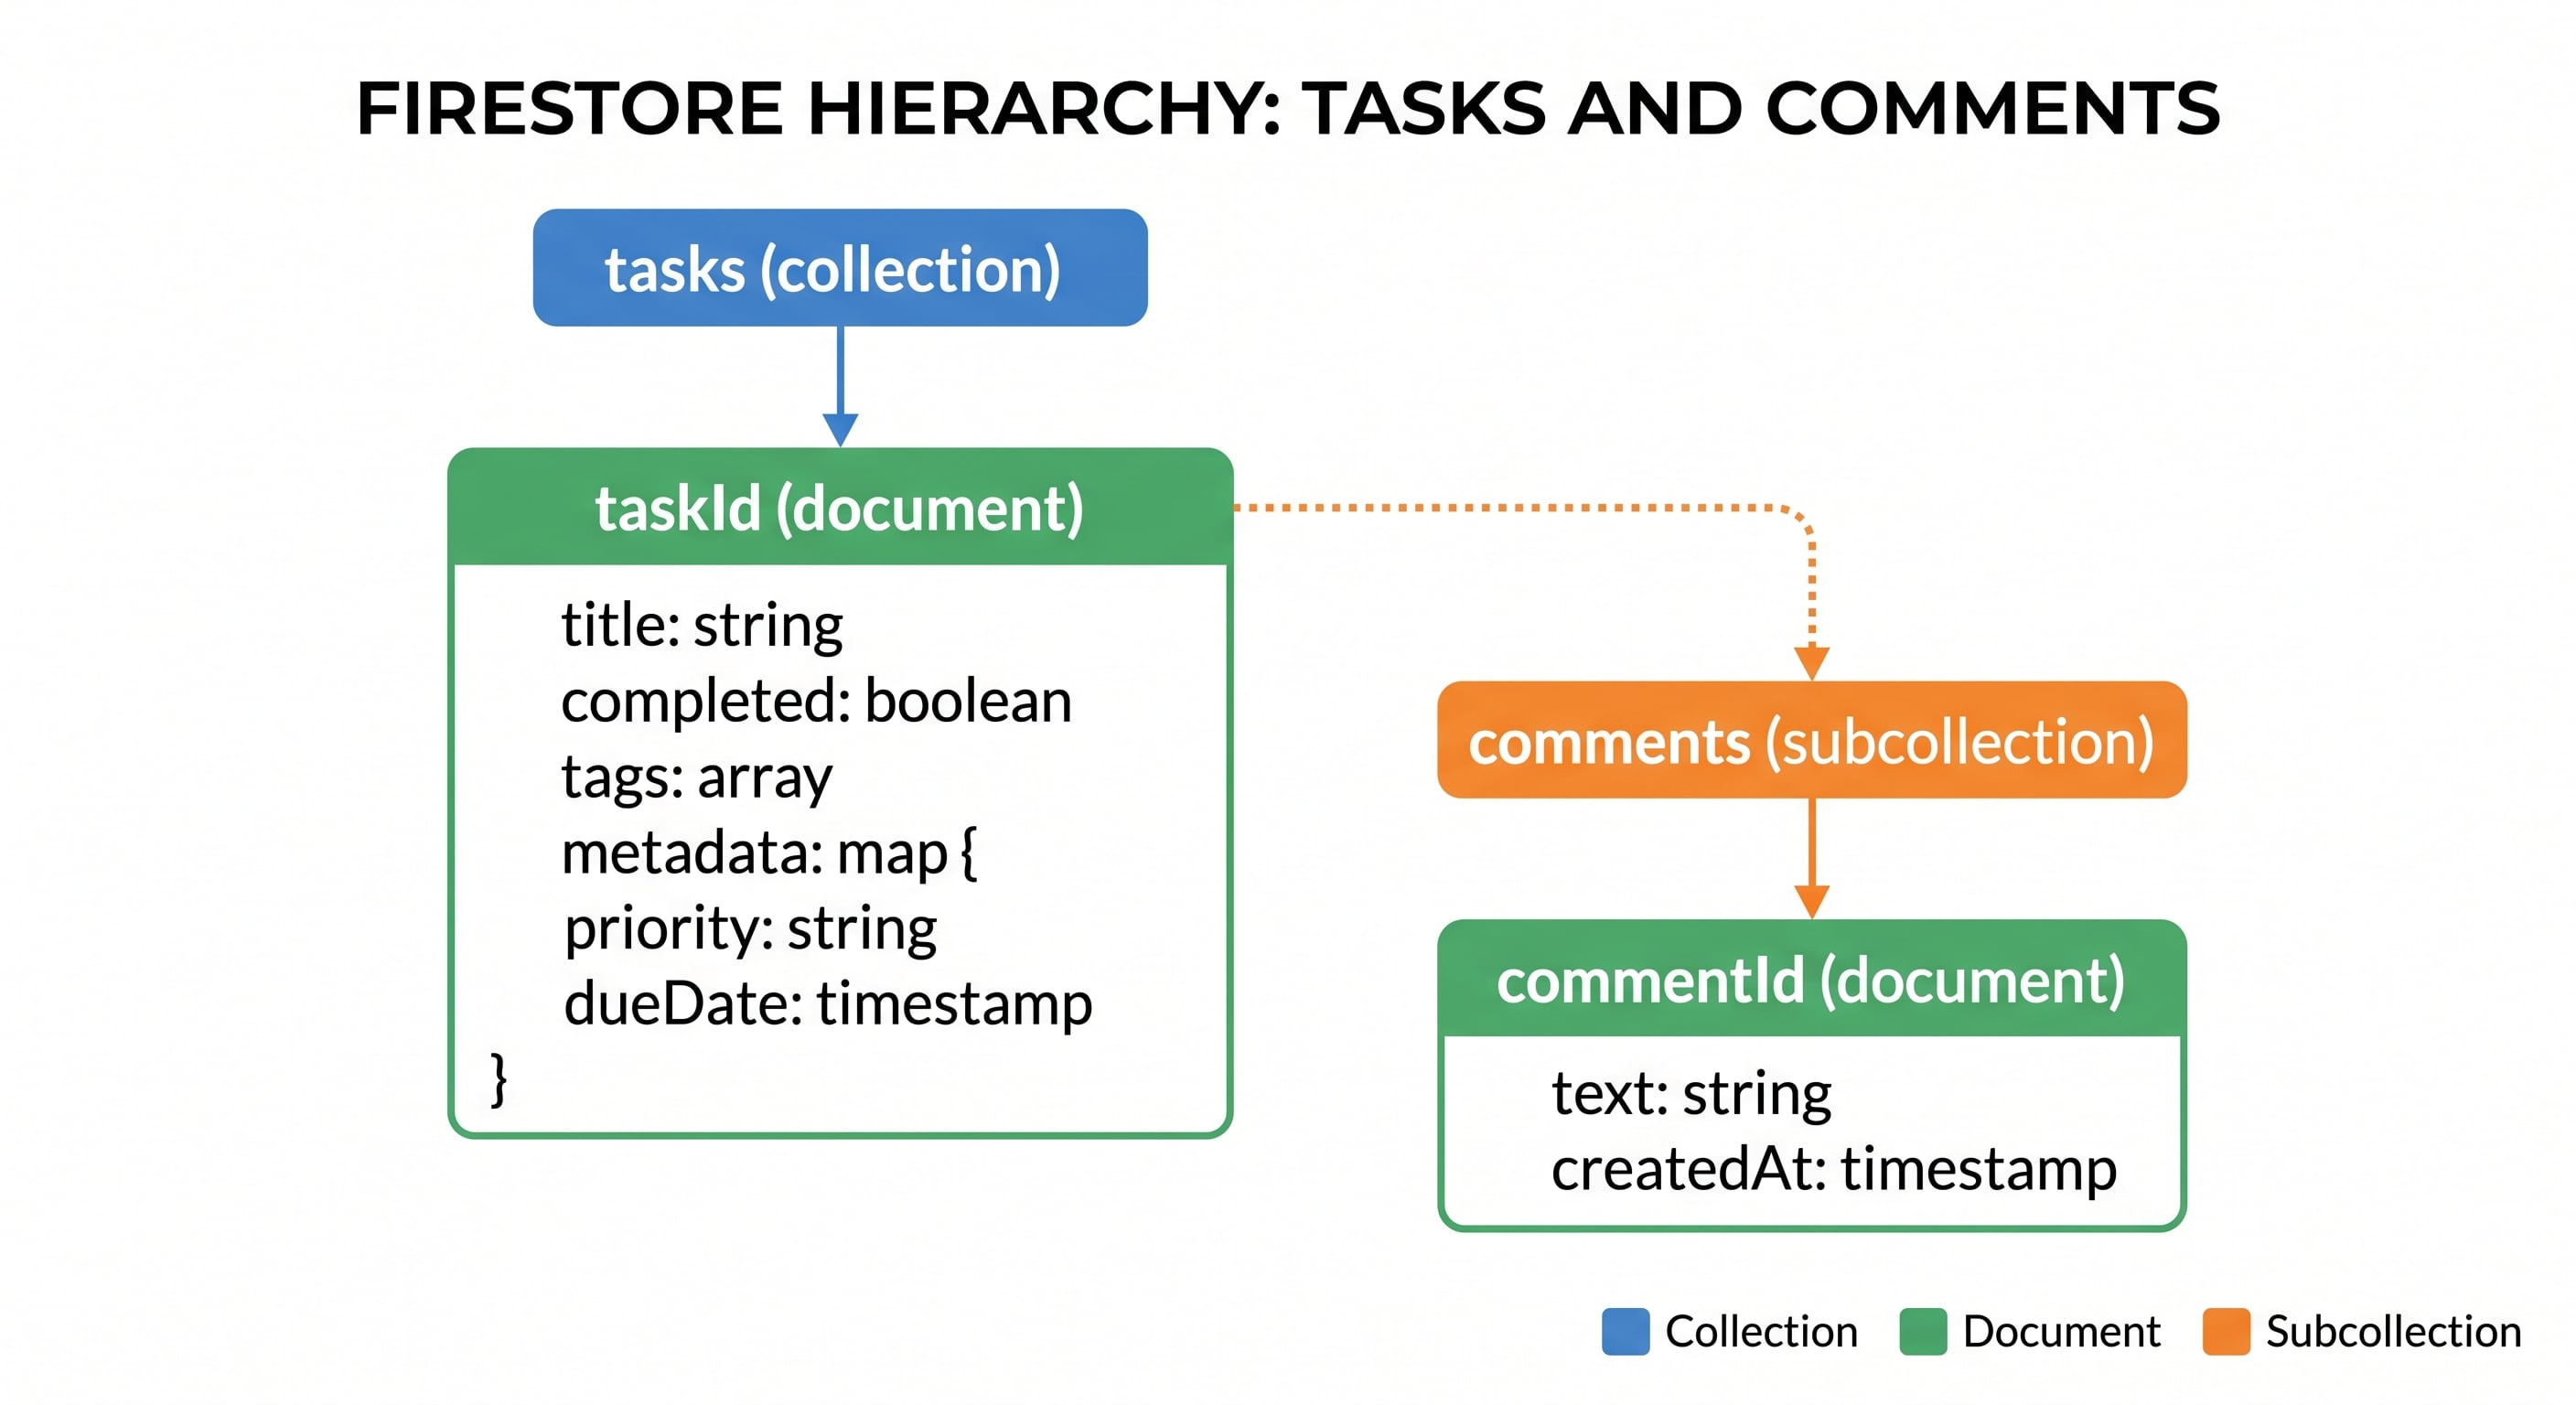
如果你有关系型数据库(如SQL数据库)的使用经验,首先需要摒弃的是那种具有固定数据结构和外键关联的表格概念。Firestore是一种面向文档的NoSQL数据库,它通过两个核心概念来组织数据:集合和文档。
集合是一个用于存储文档的命名容器。例如
tasks、users或orders等。文档是集合中的单个记录,每个文档都由一个唯一的ID标识。数据以键值对的形式存储在文档中,这种结构类似于JSON对象。
这里有一个常常让许多新手犯错的地方:文档并不需要拥有相同的字段。一个任务文档可以包含dueDate字段,而另一个文档则可以没有这个字段。Firestore在数据库层面并不会强制要求数据结构必须遵循某种规范,这一责任由你的应用程序代码来承担。
嵌套与子集合
文档可以包含两种类型的嵌套数据:
映射,即直接嵌套在文档内部的对象(例如,
metadata字段中可能包含{ priority, dueDate }这样的内容)子集合,也就是嵌套在特定文档下的完整集合结构(例如,每个任务都可以拥有自己的
comments子集合)
这样就会形成一种类似树的结构:
tasks (collection)
 └── taskId (document)
      ├── title: "Article title"
      ├── completed: false
      ├── tags: ["writing", "firebase"]
      ├── metadata: { priority: "high", dueDate:  }
      └── comments (subcollection)
           └── commentId (document)
                ├── text: "CRUD Article"
                └── createdAt: >
支持的数据类型
Firestore文档可以存储多种原生数据类型。其中你最常使用的是:
| 类型 | 示例 |
|---|---|
string |
"Write CRUD article" |
number |
42 |
boolean |
true |
array |
["writing", "firebase"] |
map |
{ priority: "high" } |
timestamp |
Timestamp.now() |
reference |
指向另一份文档的引用 |
geopoint |
经纬度坐标对 |
在编写CRUD代码之前了解这些内容的重要性
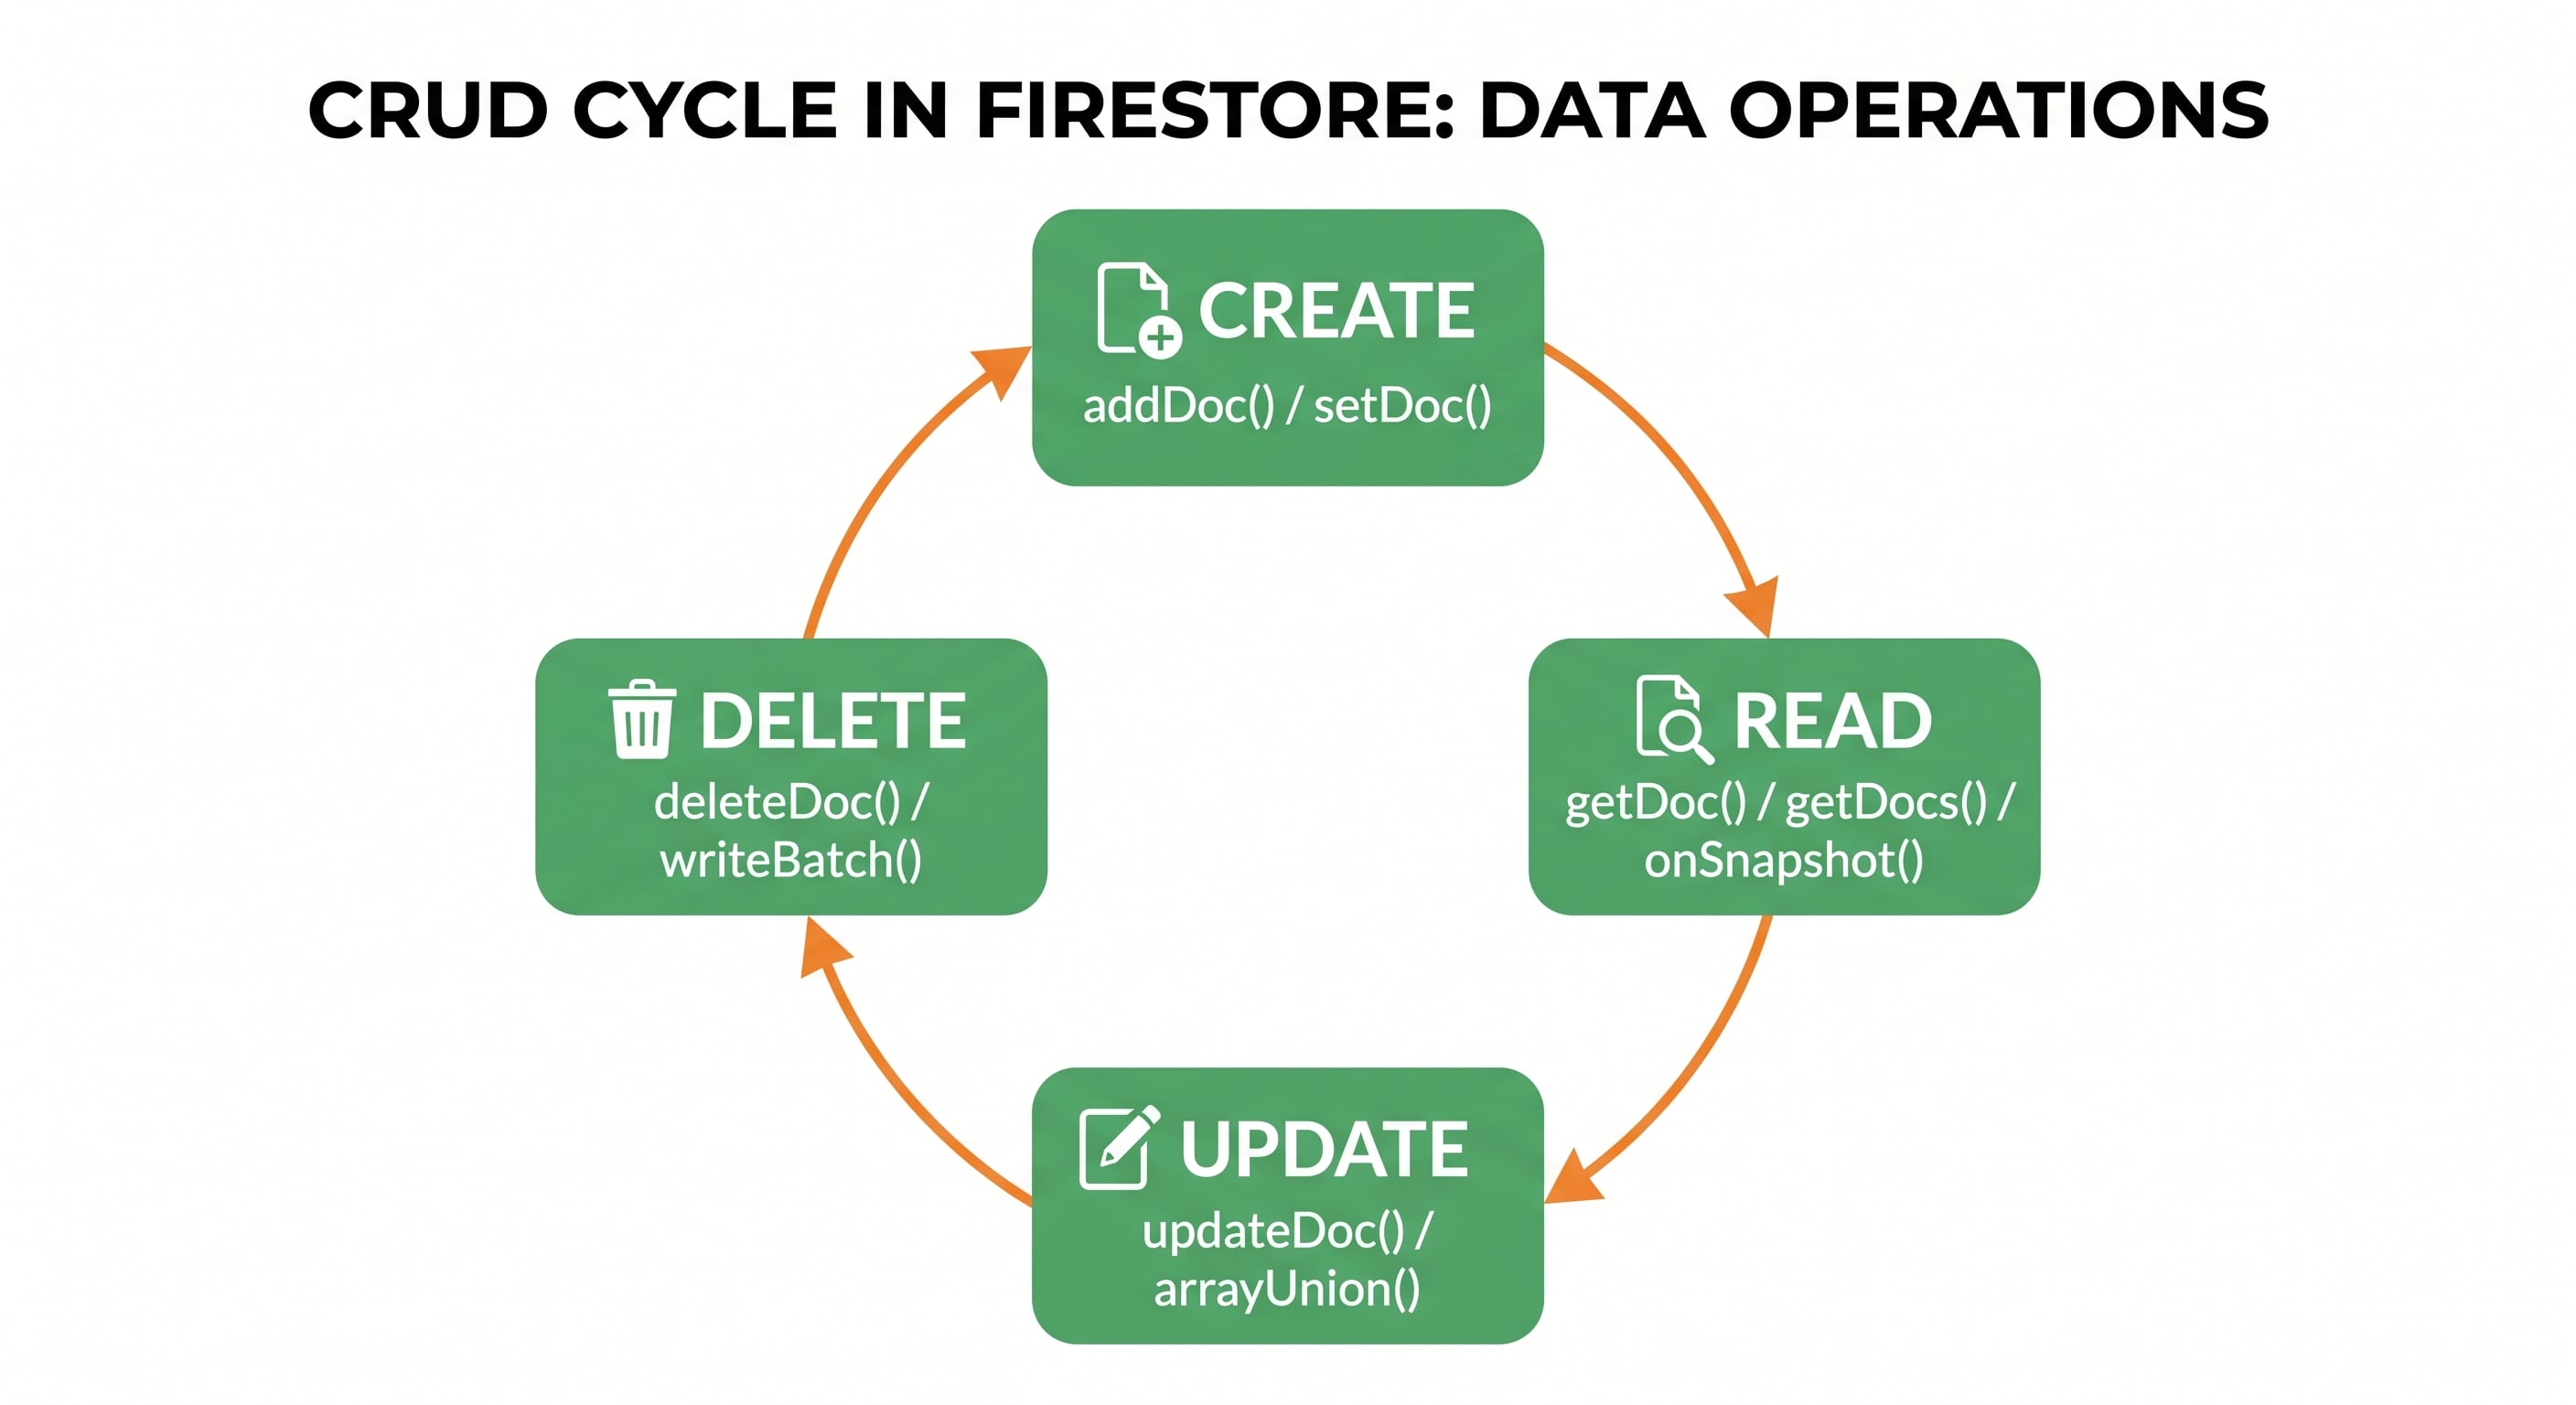
你之后编写的每一条CRUD操作都会依赖于这种数据结构:
创建操作意味着将一份文档添加到某个集合中,系统会自动生成或指定一个唯一的ID。
读取操作意味着通过ID获取单份文档,或者根据查询条件获取多份文档。
更新操作意味着修改现有文档中的字段内容,包括嵌套的映射和数组。
删除操作意味着移除一份文档,不过Firestore不会自动清理其对应的子集合(这一点在第六步中会经常被忽略)。
在建立了相应的思维模型之后,让我们开始创建项目并编写代码吧。
步骤1 – 设置您的Firebase项目
请访问Firebase控制台,然后创建一个新项目。
点击“添加项目”,为该项目起一个名称(例如:
crud-tasks-demo),然后按照设置向导的指示进行操作(在本教程中,使用Google Analytics是可选的)。项目创建完成后,打开左侧侧边栏,点击“数据库和存储”,再选择“Firestore”。
点击“创建数据库”。请选择一个离您较近的位置;对于本教程来说,建议先选择“测试模式”,这样在尚未配置安全规则的情况下,您也可以正常读写数据。
注意:测试模式下,您的数据库会在30天内对任何用户开放。在没有设置适当的Firestore安全规则之前,切勿将应用程序发布到生产环境。我们将在“调试”部分进一步讨论这一点。
现在,您应该看到一个空的Firestore数据库,它已经准备好接收您的第一个数据集合了。
步骤2 – 初始化SDK
创建一个新的项目文件夹,并安装Firebase Web SDK:
mkdir firestore-crud-demo && cd firestore-crud-demo
npm init -y
npm install firebase
从Firebase控制台的“项目设置 – 一般信息 – 您的应用程序 – Web应用程序”中获取您的项目配置信息(如果还没有注册Web应用程序,请先进行注册)。
创建一个名为firebase-config.js的文件:
// firebase-config.js
import { initializeApp } from "firebase/app";
import { getFirestore } from "firebase/firestore";

const firebaseConfig = {
  apiKey: "YOUR_API_KEY",
  authDomain: "YOURPROJECT_ID.firebaseapp.com",
  projectId: "YOUR PROJECT_ID",
  storageBucket: "YOUR_PROJECT_ID.appspot.com",
  messagingSenderId: "YOUR_SENDER_ID",
  appId: "YOUR_APP_ID",
};

const app = initializeApp(firebaseConfig);
export const db = getFirestore(app);
从现在开始,所有的CRUD示例都会从这个文件中导入db变量。在实际项目中,请将真实的配置信息放在版本控制之外(可以使用环境变量来存储这些信息)。
步骤3 – 创建:添加任务
Firestore提供了两种创建文档的方法:让Firestore自动生成ID,或者您自己指定ID。
使用addDoc()自动生成ID
// create-task.js
import { collection, addDoc, Timestamp } from "firebase/firestore";
import { db } from "./firebase-config.js";

async function createTask() {
  try {
    const docRef = await addDoc(collection(db, "tasks"), {
      title: "编写CRUD文章",
      completed: false,
      tags: ["writing", "firebase"],
      metadata: {
        priority: "high",
        dueDate: Timestamp.fromDate(new Date("2026-09-15")),
      },
      createdAt: Timestamp.now(),
    });
    console.log("任务创建成功,其ID为:", docRef.id);
  } catch (error) {
    console.error("创建任务时出现错误:", error);
  }
}

createTask();
使用setDoc()自定义文档ID
当您希望自行控制文档ID时,可以使用这种方法,例如将其与另一个系统中的ID进行匹配。
import { doc, setDoc } from "firebase/firestore";
import { db } from "./firebase-config.js";

async function createTaskWithId(taskId) {
  await setDoc(doc(db, "tasks", taskId), {
    title: "Review pull request",
    completed: false,
    tags: ["code-review"],
  });
}

createTaskWithId("task-001");
将文档添加到子集合中
若要在特定任务下添加评论,首先需要引用该任务的父文档:
import { collection, addDoc, Timestamp } from "firebase/firestore";
import { db } from "./firebase-config.js";

async function addComment(taskId, text) {
  await addDoc(collection(db, "tasks", taskId, "comments"), {
    text,
    createdAt: Timestamp.now(),
  });
}

addComment("task-001", "First draft done");
步骤4 – 阅读:查询任务信息
获取单个文档
import { doc, getDoc } from "firebase/firestore";
import { db } from "./firebase-config.js";

async function getTask(taskId) {
  const snapshot = await getDoc(doc(db, "tasks", taskId));
  if (snapshotexists()) {
    console.log(snapshot.id, snapshot.data());
  } else {
    console.log("没有找到该任务。");
  }
}

getTask("task-001");
获取整个集合
import { collection, getDocs } from "firebase/firestore";
import { db } from "./firebase-config.js";

async function getAllTasks() {
  const snapshot = await getDocs(collection(db, "tasks"));
  snapshot.forEach((doc) => {
    console.log(doc.id, doc.data());
  });
}

getAllTasks();
使用查询进行过滤
import { collection, query, where, orderBy, limit, getDocs } from "firebase/firestore";
import { db } from "./firebase-config.js";

async function getUrgentPendingTasks() {
  const q = query(
    collection(db, "tasks"),
    where("completed", "==", false),
    orderBy("metadata.priority"),
    limit(10)
  );

  const snapshot = await getDocs(q);
  snapshot.forEach((doc) => console.log(doc.id, doc.data()));
}

getUrgentPendingTasks();
注意:当在一个字段上使用where()进行过滤,在另一个字段上使用orderBy()进行排序时,通常需要创建一个复合索引。Firestore会在控制台中显示错误信息,并提供创建该索引的详细说明。更多相关内容请参阅“调试”章节。
使用onSnapshot()实现实时更新
您不必一次性获取所有数据,而是可以订阅实时变化。这对于需要在各种设备上即时更新的任务列表来说非常有用:
import { collection, onSnapshot } from "firebase/firestore";
import { db } from "./firebase-config.js";

const unsubscribe = onSnapshot(collection(db, "tasks"), (snapshot) => {
  snapshot.docChanges().forEach((change) => {
    console.log/change.type, change.doc.id, change.doc.data());
  });
});

// 当您不再需要接收更新时,调用unsubscribe()方法(例如,组件被卸载时)
步骤 5 – 更新:修改任务
使用updateDoc()进行部分更新
与setDoc()不同,updateDoc()只会修改您指定的字段,文档中的其他内容保持不变。
import { doc, updateDoc } from "firebase/firestore";
import { db } from "./firebase-config.js";

async function completeTask(taskId) {
  await updateDoc(doc(db, "tasks", taskId), {
    completed: true,
  });
}

completeTask("task-001");
使用点表示法更新嵌套字段
要修改metadata对象中的某个属性,您无需重新编写整个对象:
await updateDoc(doc(db, "tasks", "task-001"), {
  "metadata.priority": "low",
});
安全地更新数组
在并发环境中,直接覆盖数组字段是危险的。应使用arrayUnion()和arrayRemove()方法来操作数组:
import { doc, updateDoc, arrayUnion, arrayRemove } from "firebase/firestore";
import { db } from "./firebase-config.js";

async function addTag(taskId, tag) {
  await updateDoc(doc(db, "tasks", taskId), {
    tags: arrayUnion(tag),
  });
}

async function removeTag(taskId, tag) {
  await updateDoc(doc(db, "tasks", taskId), {
    tags: arrayRemove(tag),
  });
}
arrayUnion()会去除重复的值,而arrayRemove()则会删除所有匹配的条目。这两种操作都在服务器端原子性地执行。
步骤 6 – 删除:移除任务
删除文档
import { doc, deleteDoc } from "firebase/firestore";
import { db } from "./firebase-config.js";

async function deleteTask(taskId) {
  await deleteDoc(doc(db, "tasks", taskId));
}

deleteTask("task-001");
子集合的陷阱
前面提到过一个需要注意的问题:删除tasks/task-001并不会自动删除其对应的comments子集合。这些评论文档仍然存在于数据库中,只是通过用户界面无法访问它们,除非您知道它们的路径。
要正确地进行清理操作,首先需要删除子集合中的文档,然后再删除父集合中的文档:
import { collection, getDocs, doc, deleteDoc, writeBatch } from "firebase/firestore";
import { db } from "./firebase-config.js";

async function deleteTaskWithComments(taskId) {
  const commentsRef = collection(db, "tasks", taskId, "comments");
  const commentsSnapshot = await getDocs(commentsRef);

  const batch = writeBatch(db);
  commentsSnapshot.forEach((commentDoc) => {
    batch.delete(commentDoc.ref);
  });
  batch.delete(doc(db, "tasks", taskId));

  await batch.commit();
}

deleteTaskWithComments("task-001");
writeBatch() 将多个删除操作合并为一次原子性操作。这些操作要么全部成功,要么全部失败。
删除单个字段
如果你只想删除某个字段而不想删除整个文档,可以使用 deleteField() 方法:
import { doc, updateDoc, deleteField } from "firebase/firestore";
import { db } from "./firebase-config.js";

await updateDoc(doc(db, "tasks", "task-001"), {
  metadata: deleteField(),
});
调试常见问题
FirebaseError: 缺少或权限不足
你的安全规则阻止了该请求的执行。如果你仍处于测试模式,请检查30天的有效期是否已经到期(过了这个期限,规则会自动恢复为拒绝所有请求)。对于正式发布的应用程序,请在Firestore设置中查看规则配置,然后检查这些规则是否与你实际进行读写操作的路径相匹配,包括子集合;子集合也需要单独设置规则。
函数 addDoc() 被调用时传入了无效数据。不支持的值:undefined
与null不同,undefined值是被Firestore明确拒绝的。这种情况通常发生在表单字段为空时,你直接将其传递给写入操作。在进行写入操作之前,请先过滤掉所有值为undefined的字段,或者将它们的值设置为null。
该查询需要索引才能执行
当你在不同的字段上同时使用where()和orderBy()时,就会出现这种错误。Firestore无法利用自动创建的索引来执行这样的查询。错误信息中会提供一个链接,通过这个链接可以在控制台中预先生成所需的复合索引。点击该链接,等待一两分钟让索引生成完成,然后再重新执行查询即可。
读取操作次数过多导致配额警告
无论是在循环中多次调用getDoc(),还是直接获取整个集合的数据,每次操作都会被计为一次读取。为了避免不必要的数据传输,请不要为了在客户端进行过滤而先获取整个集合,而是应该使用where()在查询阶段就完成过滤操作;对于那些可能会无限增长的数据集,还需要使用limit()来限制查询结果的数量。
删除后剩余的子集合
如果您发现认为自己已经删除的文档仍在占用存储空间,或者仍然出现在导出结果中,请检查被删除文档路径下是否存在子集合。正如步骤6中所说明的,deleteDoc()方法永远不会触发级联删除操作,因此清理这些剩余的子集合始终是您的责任。
总结
现在,您已经对Firestore的数据结构有了清晰的认识,并且也通过使用Web SDK v9+亲自体验了所有的CRUD操作。以下是这些内容的简要回顾:
| 操作类型 | 关键函数 |
|---|---|
| 创建 | addDoc(), setDoc() |
| 读取 | getDoc(), getDocs(), query(), onSnapshot() |
| 更新 | updateDoc(), arrayUnion(), arrayRemove() |
| 删除 | deleteDoc(), deleteField(), writeBatch() |
当您熟练掌握了这些基础知识之后,接下来可以尝试以下几个方向进行进一步学习:
事务处理,用于那些必须同时成功或失败的操作(例如在两个用户之间传递任务)。
批量写入操作,正如步骤6中所介绍的,当您需要原子性地修改多份文档时,这种操作非常有用。
复合索引,可以帮助您实现更复杂的过滤和排序功能。
分页处理,通过使用
startAfter()方法,可以分批加载大量数据,而无需一次性全部加载。
如果您还没有这样做的话,建议在针对数据编写查询语句之前,先重新思考如何对数据进行建模。在建模阶段做出的决策(比如是否需要嵌套数据或使用子集合),会直接影响到后续使用哪些CRUD操作会更加自然、高效。
相关文章
“从设计层面确保安全性”:在编写任何代码之前,如何将安全机制纳入系统架构之中
在大多数工程团队中,都会进行这样的对话——不过往往为时已晚。 想象一下:某个功能被部署到生产环境中之后,才会进行安全审查;或者在进行渗透测试时发现了问题;更糟糕的是,还会收到事故报告。 这些漏洞确实是存在的,修复它们也需要投入大量成本。而在这些讨论中,总会有人说:“我们需要为这个功能添加安全措施。” 但这个问题就出在这里:安全并不是事后才添加到软件中的东西,而应该从项目一开始就被纳入设计之中。一旦开始考虑为已经存在的东西添加安全功能,那就意味着你已经进入了“事故应对模式”。 “安全驱动设计”是一种完全不同的思维方式——在制定架构决策之前,就应该明确安全要求;在编写任何代码之前,就必须了解潜在的
阅读全文
如何阻止人工智能代理生成尼日利亚的邮政编码
2026年10月1日,尼日利亚的邮政编码从六位数字改为由11个字符组成的代码,这种编码能够唯一标识某栋建筑,例如 EK-01-A03-FK-01 。 在此之前训练的语言模型仍然会自信地使用旧格式来处理邮政编码。这会影响两种类型的程序:一种是负责生成验证代码的编程程序,另一种是在运行时从客户信息中读取邮政编码或填写配送表格的程序。 本文将介绍如何解决这个问题。对于那些生成验证代码的程序,你需要检测它们目前生成的代码是否存在错误,并为它们提供相应的规则来纠正这些错误;而对于在运行时处理邮政编码的程序,则需要为它们设定明确的边界:当模型提出一个邮政编码时,由特定的程序来判断该编码是否符合规范、是否已
阅读全文
如何打破人工智能编程代理的循环机制
你很可能已经看过这样的情景:在使用人工智能编码工具构建的应用程序中,出现了某些故障。你让这个工具去修复这些问题,它似乎也“修复”了它们,但实际上错误依然存在,或者又出现了新的问题。 于是你会说“还是不行”。工具会再次尝试修复。二十分钟后,你会发现代码中的错误更多了,可用的功能也更少了,而且完全不知道该如何让应用程序恢复到正常状态。 人们常常用“人工智能反而使问题更加严重”或者“工具陷入了无限循环的修复模式”这样的表述来描述这种情况。这并不是某个特定产品的缺陷,像Replit、Cursor、Claude Code、Base44这类工具都会出现同样的问题,因为这种故障的本质是系统性的。 本教程将解
阅读全文
如何向英国税务海关总署的“数字化纳税”API提交季度更新报告
每年有四次,所有参与“税收数字化”计划的个体经营者和房东都必须向英国税务海关总署提交一份收入与支出的汇总报表。 2026-27纳税年度的第一个截止日期是8月7日,这个期限已经过去;第二个截止日期则是11月7日。每份汇总报表都需要通过软件向英国税务海关总署发送一次API请求,而本教程正是专门讲解如何正确完成这些请求操作的。 您无需事先阅读任何其他资料即可跟随本教程进行操作。每次进行“税收数字化”集成时所需的一次性设置信息(包括沙箱应用程序、OAuth 2.0访问令牌以及防欺诈相关配置)已在下方的简要总结中列出,同时每段代码示例中也都会使用到一些辅助函数。 如果您想深入了解这些设置步骤,我曾在 之
阅读全文