
神经网络的工作原理:为什么单纯的直线并不能满足需求
直线方程是理解神经网络工作原理的一个很好的切入点。在我之前的文章《如何理解神经网络的工作原理——用直线方程(y=ax+b)来解释》中,我们就探讨了这个话题。 但是,如果输入与输出之间的关系 并非线性的 呢? 我们都知道,在现实世界中,数据并不总是遵循直线规律分布的。这时问题就变得有趣了:有时候,仅仅用一条规则是无法描述变量之间的关系的。 这就是非线性概念发挥作用的地方。它使神经网络能够捕捉数据中的复杂变化规律。 在这篇文章中,我们将探讨这种非线性机制,以及它们如何帮助神经网络识别那些无法用直线方程来描述的复杂关系。通过一些简单的例子,我们会尝试理解分段线性曲线、ReLU函数、S形曲线和Sigm
直线方程是理解神经网络工作原理的一个很好的切入点。在我之前的文章《如何理解神经网络的工作原理——用直线方程(y=ax+b)来解释》中,我们就探讨了这个话题。
但是,如果输入与输出之间的关系并非线性的呢?
我们都知道,在现实世界中,数据并不总是遵循直线规律分布的。这时问题就变得有趣了:有时候,仅仅用一条规则是无法描述变量之间的关系的。
这就是非线性概念发挥作用的地方。它使神经网络能够捕捉数据中的复杂变化规律。
在这篇文章中,我们将探讨这种非线性机制,以及它们如何帮助神经网络识别那些无法用直线方程来描述的复杂关系。通过一些简单的例子,我们会尝试理解分段线性曲线、ReLU函数、S形曲线和Sigmoid函数在这些过程中的作用。
目录
先决条件
对线性函数有基本的了解
熟悉深度神经网络的概念
何时直线方程足够使用
直线方程意味着在整个关系中都适用同一条规则。
y = ax + b
y => 输出变量
x =>> 输入变量
a =>> 当x变化时y的变化幅度(斜率)
b =>> 当x为0时y的值(y轴截距)
我们可以通过一个例子来更好地理解这一点。
Poly老师是一位数学教师,她想为学生制定一份学习计划,帮助他们取得优异的成绩。她根据一个因素制定了这个计划:学生每周学习的小时数。这意味着,学生的考试成绩与他们所花费的学习时间成正比。
根据她的假设,她得出了一个形如 y = ax + b 的方程。
y => 获得的分数
x => 学习的小时数
a => 每学习一小时分数增加的幅度
b => 每个学生不学习也能取得的最低分数
因此,在一次季度考试之后,她与学生们进行了谈话,了解了他们每周学习数学的小时数。她制作了一个包含两列的表格:一周学习的小时数(x)和获得的分数(y),然后将这些数据绘制成图表。
| 学习的小时数 | 获得的分数 |
|---|---|
| 0 | 40 |
| 1 | 40 |
| 2 | 41 |
| 3 | 40 |
| 4 | 48 |
| 5 | 58 |
| 6 | 69 |
| 7 | 80 |
| 8 | 80 |
然而,当她尝试使用这个简单的公式时,发现它与收集到的数据并不一致,这证明了现实生活中的数据往往并不那么简单明了。
当一条直线不够用时
波莉老师仔细观察了这张图表,发现了一些规律:那些学习时间很短的学生,他们的分数提升并不明显;但一旦他们达到某个特定的学习时间点,分数就会随着学习时间的增加而上升;而再超过另一个时间点后,分数又会趋于稳定。
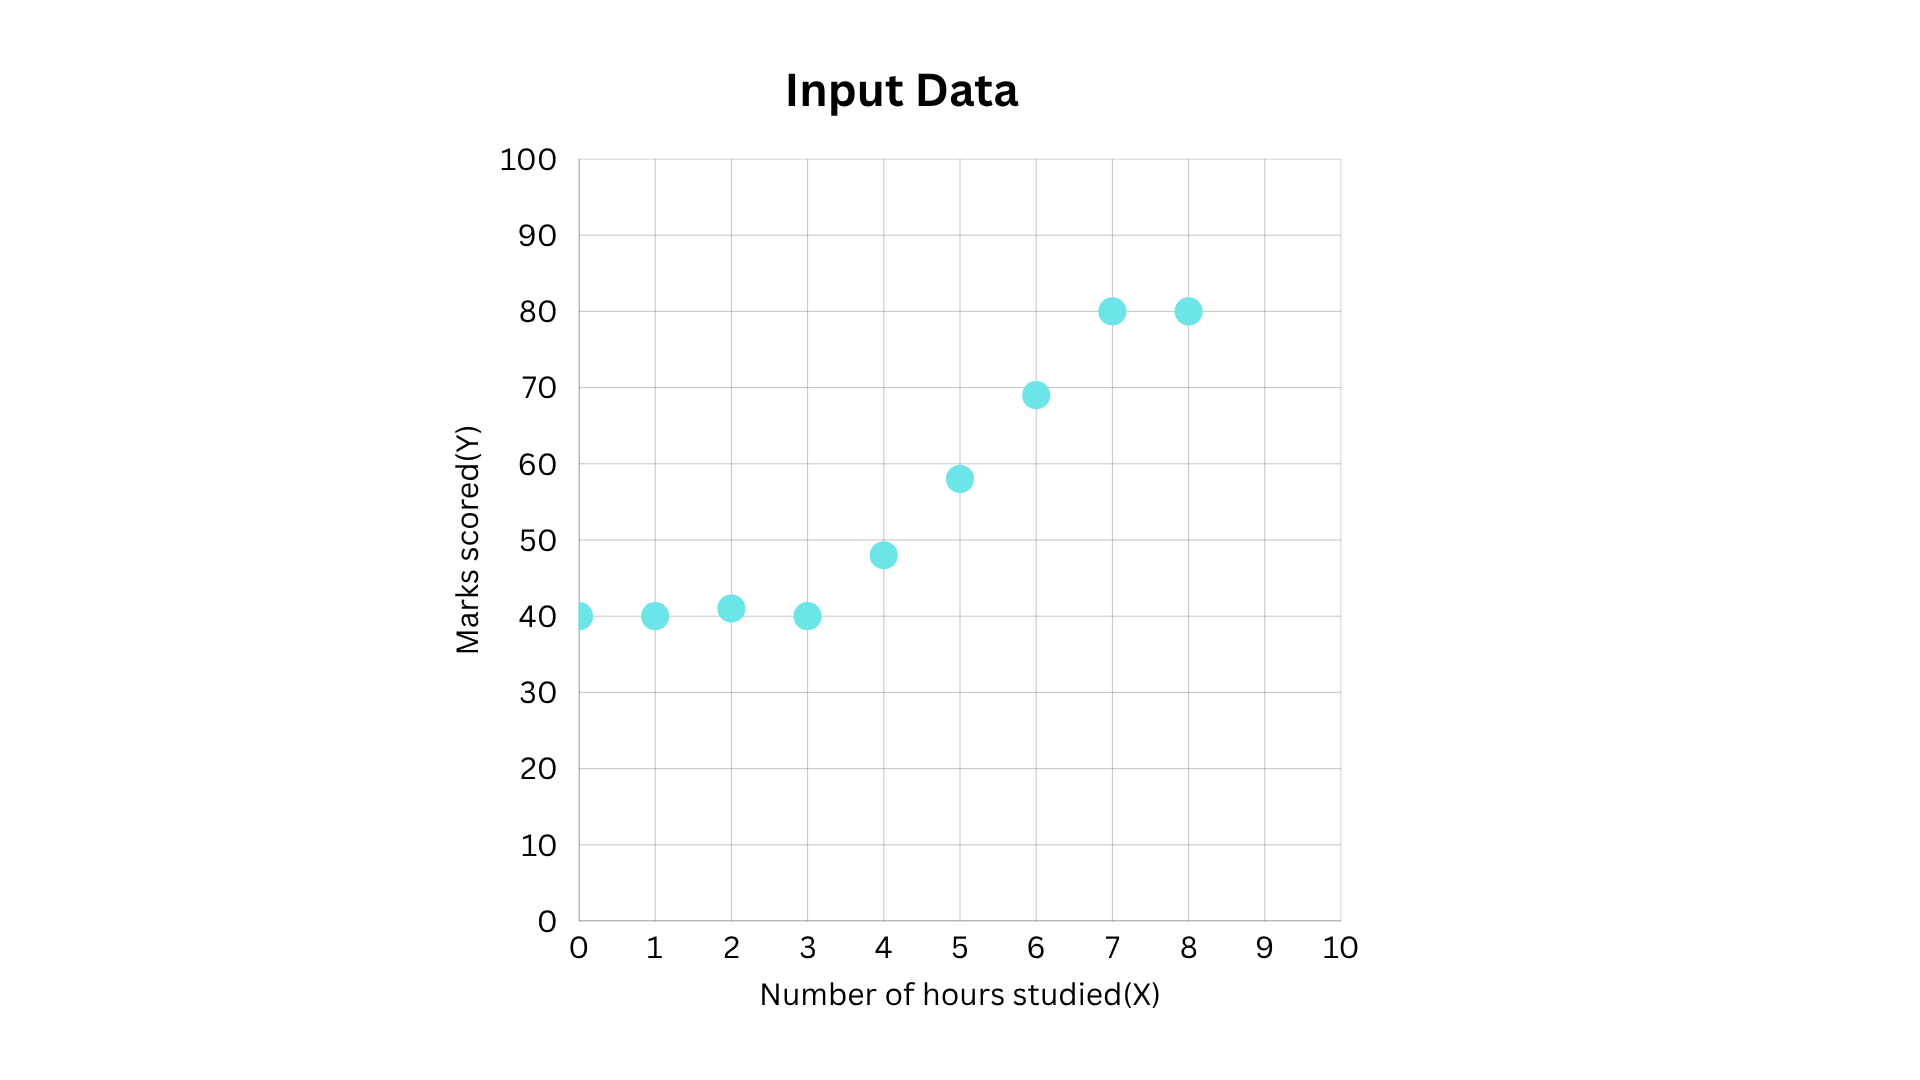
因此,波莉老师使用的那个简单的直线方程并不足以描述每周学习小时数(x)与获得的分数(y)之间的关系。
实际上,这种关系可以分为三个阶段:
学习时间少于 t1 小时时:分数保持不变
t1 到 t2 小时之间:分数随着学习时间的增加而上升
学习时间超过 t2 小时时:分数再次趋于稳定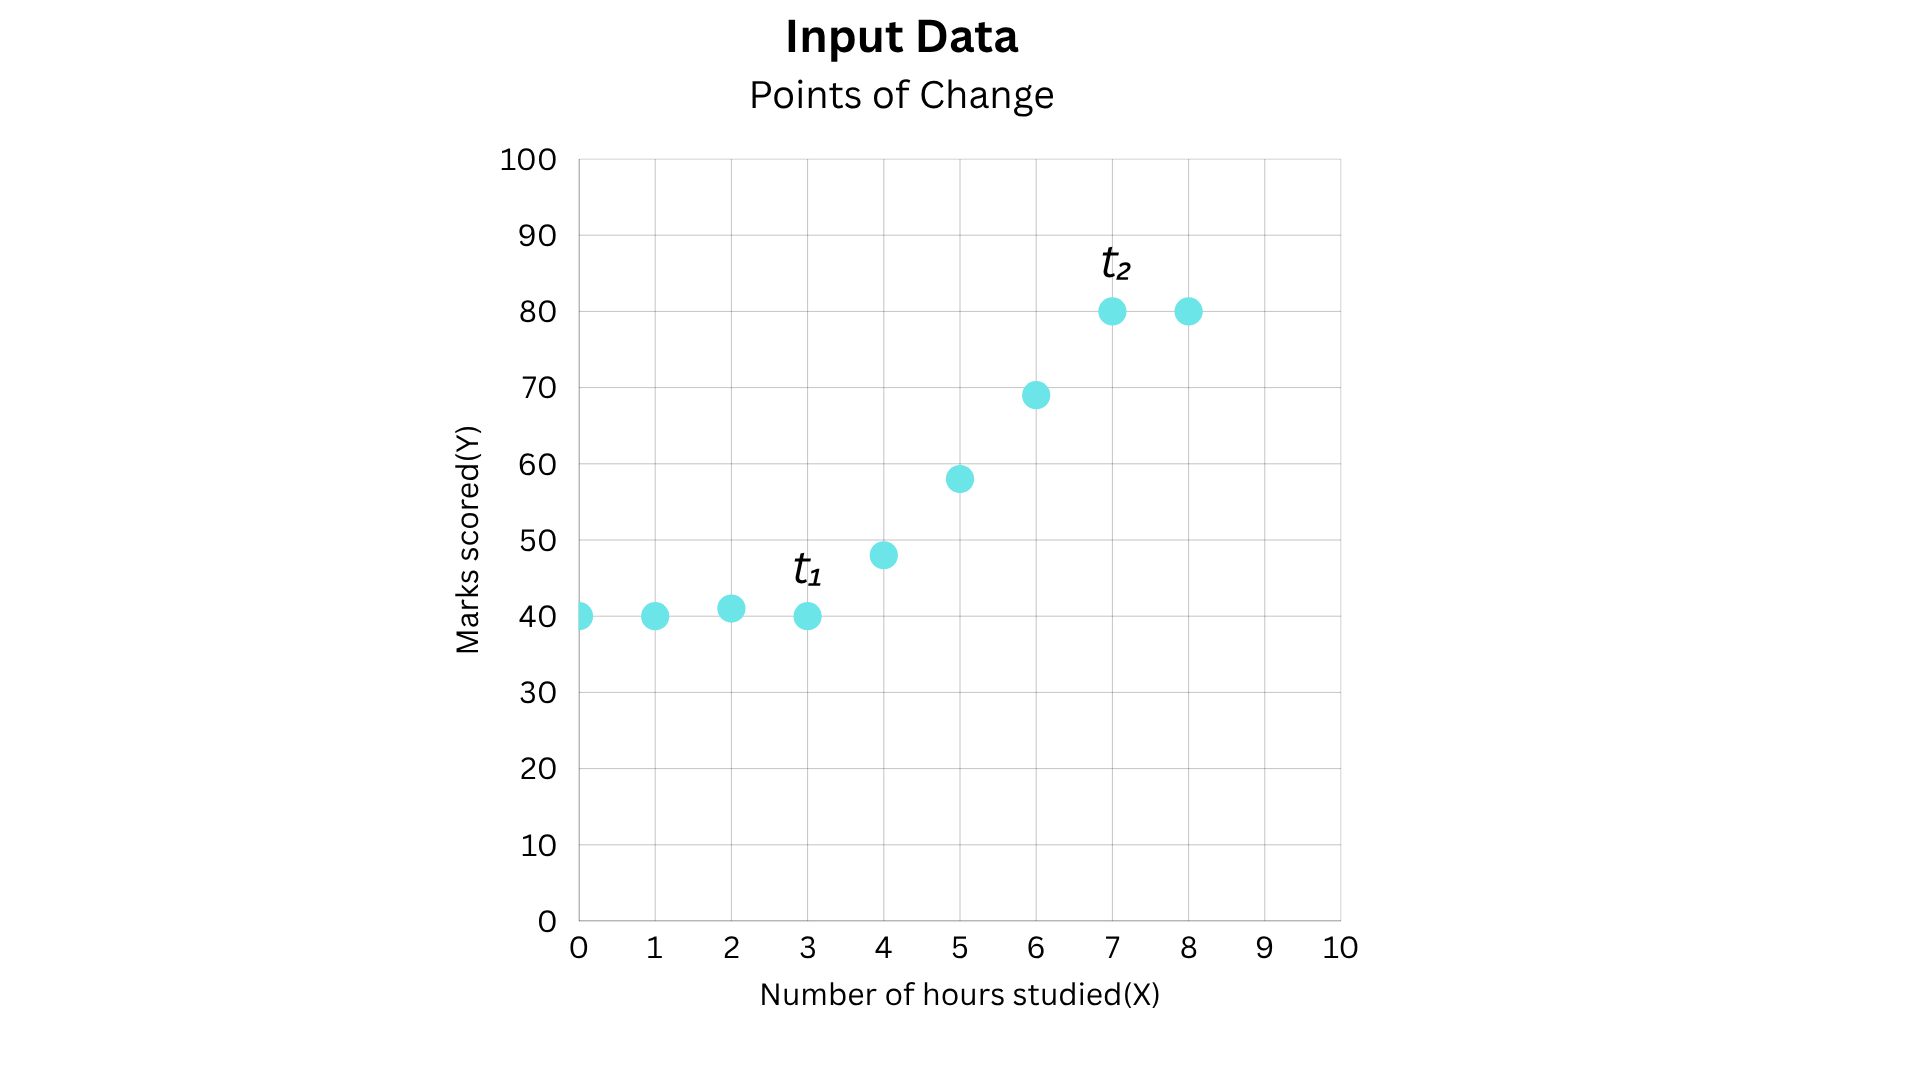
所以,对于每个不同的阶段,都应该使用不同的方程来表示这种关系,具体表达方式如下:
当 x < t1 时,y = 第一个方程
当 t1 ≤ x ≤ t2 时,y = 第二个方程
当 x > t2 时,y = 第三个方程
这个例子让我们首次看到了非线性的存在。在特定的时间点上,这种关系会发生变化,因此使用单一的直线方程是无法准确描述实际情况的。
处理这类问题的一种简单方法是使用分段线性函数。
分段线性曲线
为了简化分析,波莉老师决定先考虑两个阶段的情况。
区域1:学习时间小于t₁
区域2:学习时间大于或等于t₁
在第一区域内,各数据值大致围绕某个特定数值分布。虽然这些数据并不完全呈直线排列,但她可以进行近似处理,将这一区域表示为斜率为0的直线。这说明这些数据的变化幅度基本保持不变。
在第二区域内,数据呈现出明显的上升趋势,因此她选择了另一条直线方程来描述这条陡峭的上升曲线。
最终,Poly女士为上述图表制定了两条方程——因为单一条方程无法完整描述这一关系。随着数据分布范围的变化,所适用的规则也会相应改变。
所以,她可以将这些关系表示为如下形式:
当x小于t₁时,y = 第一条方程;
当x大于或等于t₁时,y = 第二条方程。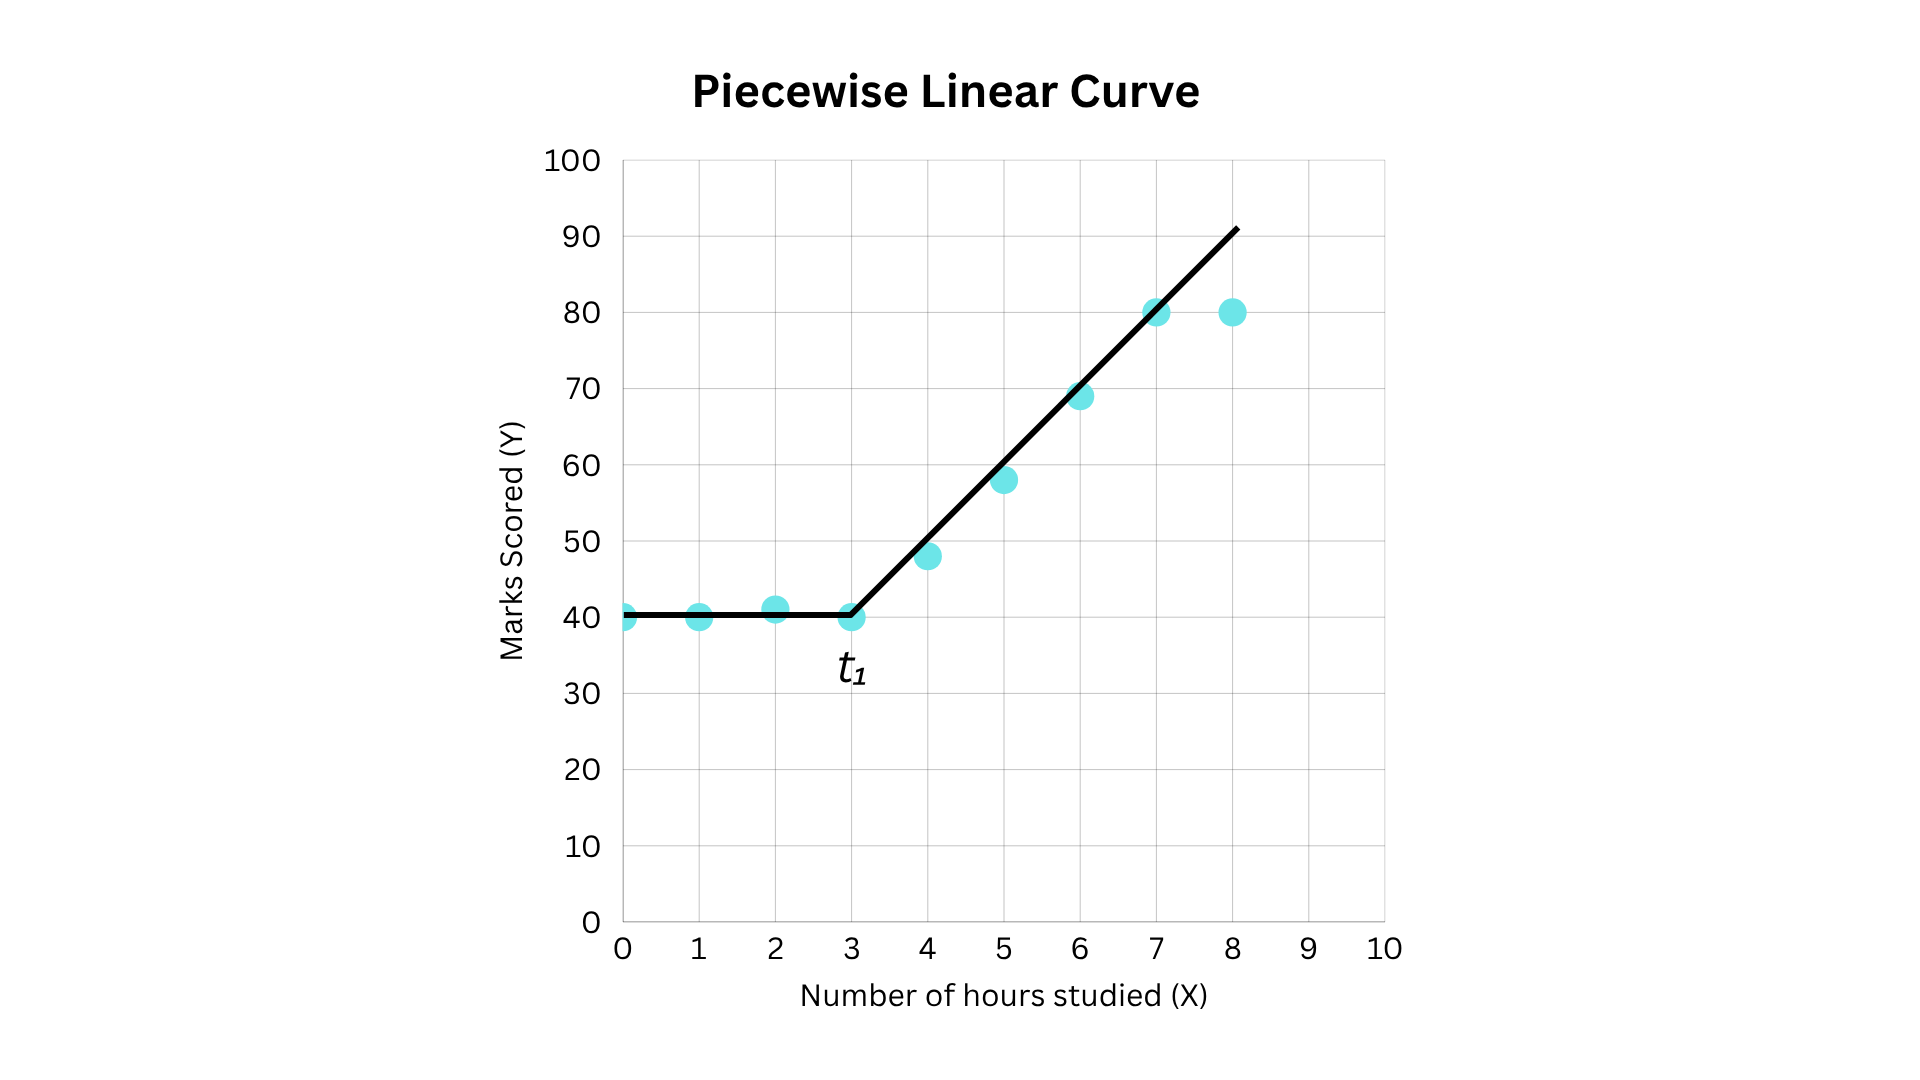
单独来看,这两条方程似乎都是表示直线的方程。但当把它们结合起来时,整体关系就不再是直线了。当x的值超过某个临界点时,所使用的方程就会发生变化。这种函数被称为分段线性函数——它针对不同的输入范围采用了不同的计算规则。
这个概念在神经网络中应用最为广泛的一种激活函数中得到了体现,那就是ReLU函数。
什么是ReLU函数?
ReLU的全称是“修正线性单元”。从数学上来说,它的表达式如下:
y = ReLU(x) = max(0, x)这个函数会保持正数的输入值不变,而将负数的输入值转换为0。
同样地,虽然每个单独的部分都是线性的,但整个函数是非线性的。因此,ReLU函数是一种能够引入非线性特性的分段线性函数。
下图展示了ReLU函数的图像:
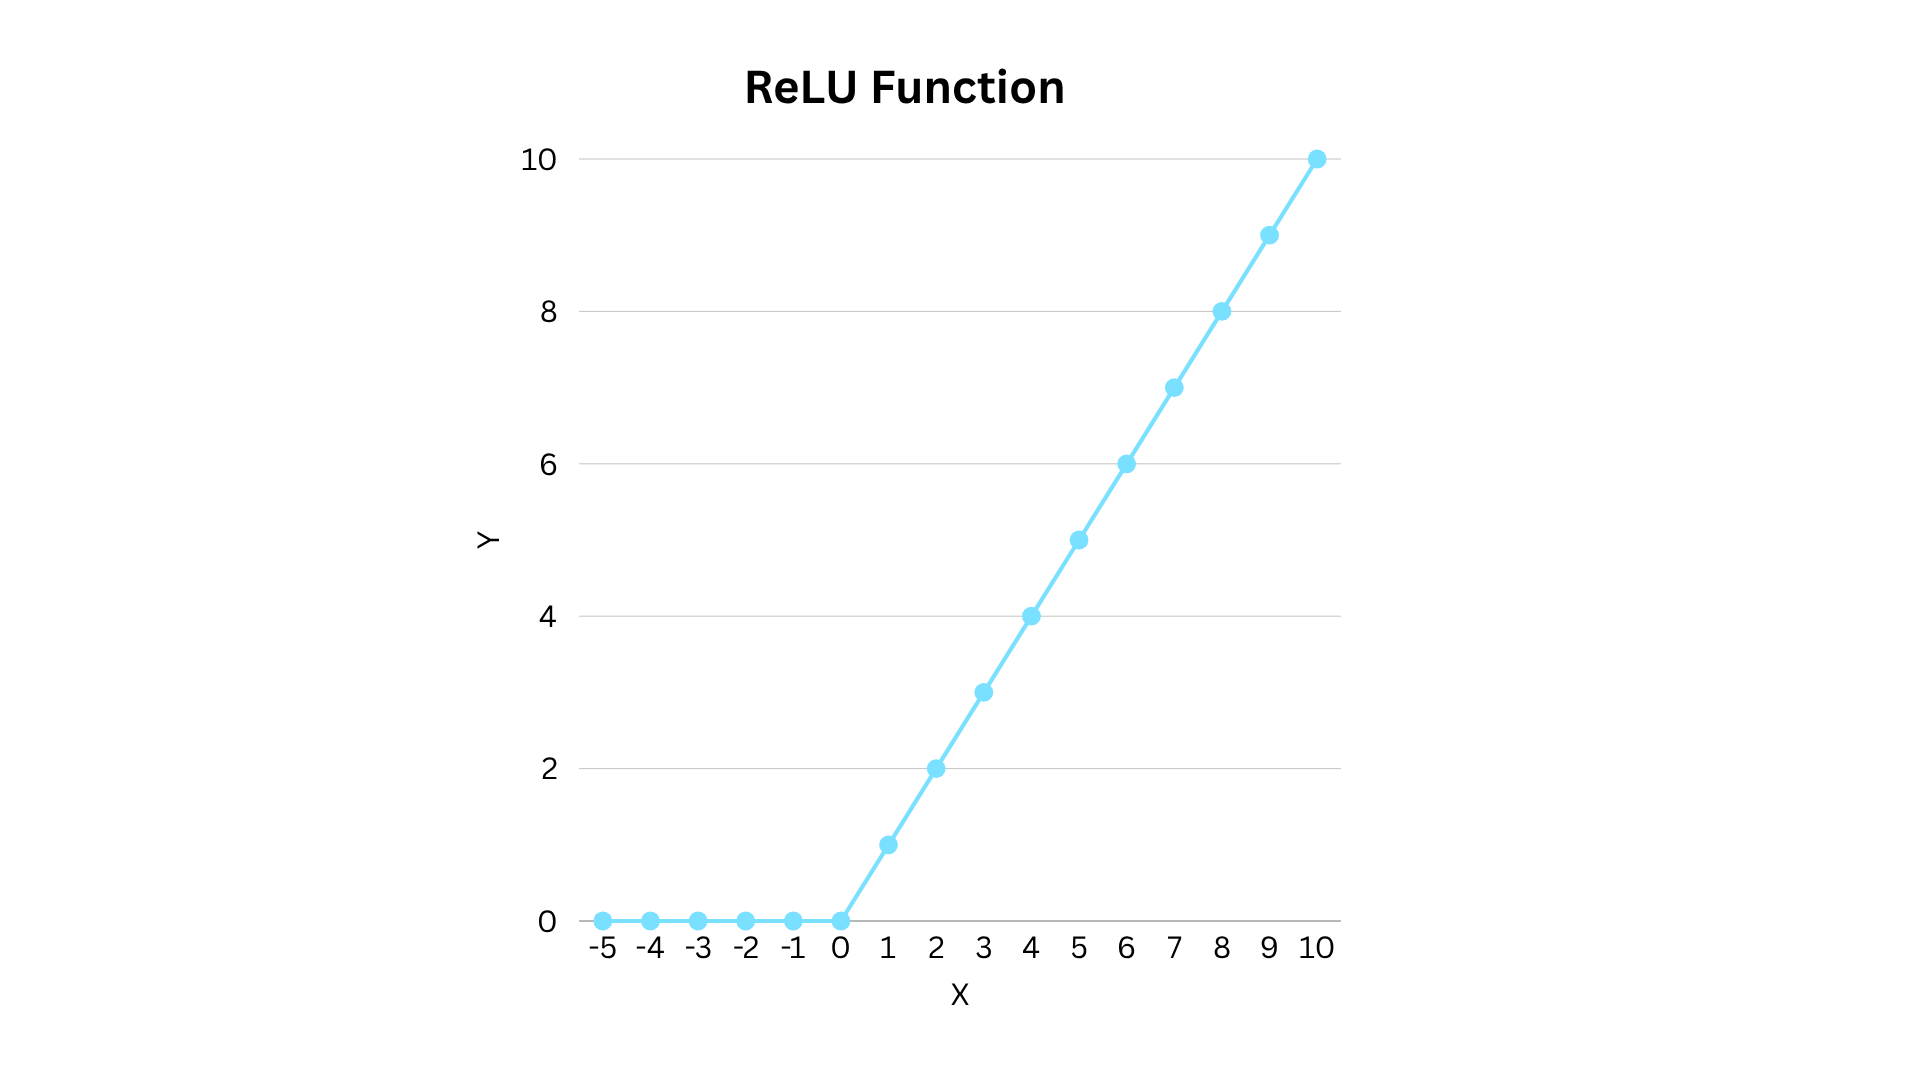
这种简单的行为变化使得神经元能够对不同范围的输入做出不同的响应,从而使神经网络能够超越单纯的线性关系。
S形曲线
分段线性曲线确实可以满足需求,但Poly女士发现,从一个区域到另一个区域的过渡过于突然。为了简化分析,她最初只划分了两个区域,但实际上这种数据分布可以分为三个区域。
因此,她绘制了一条大致穿过所有数据点的平滑曲线,如下图所示:
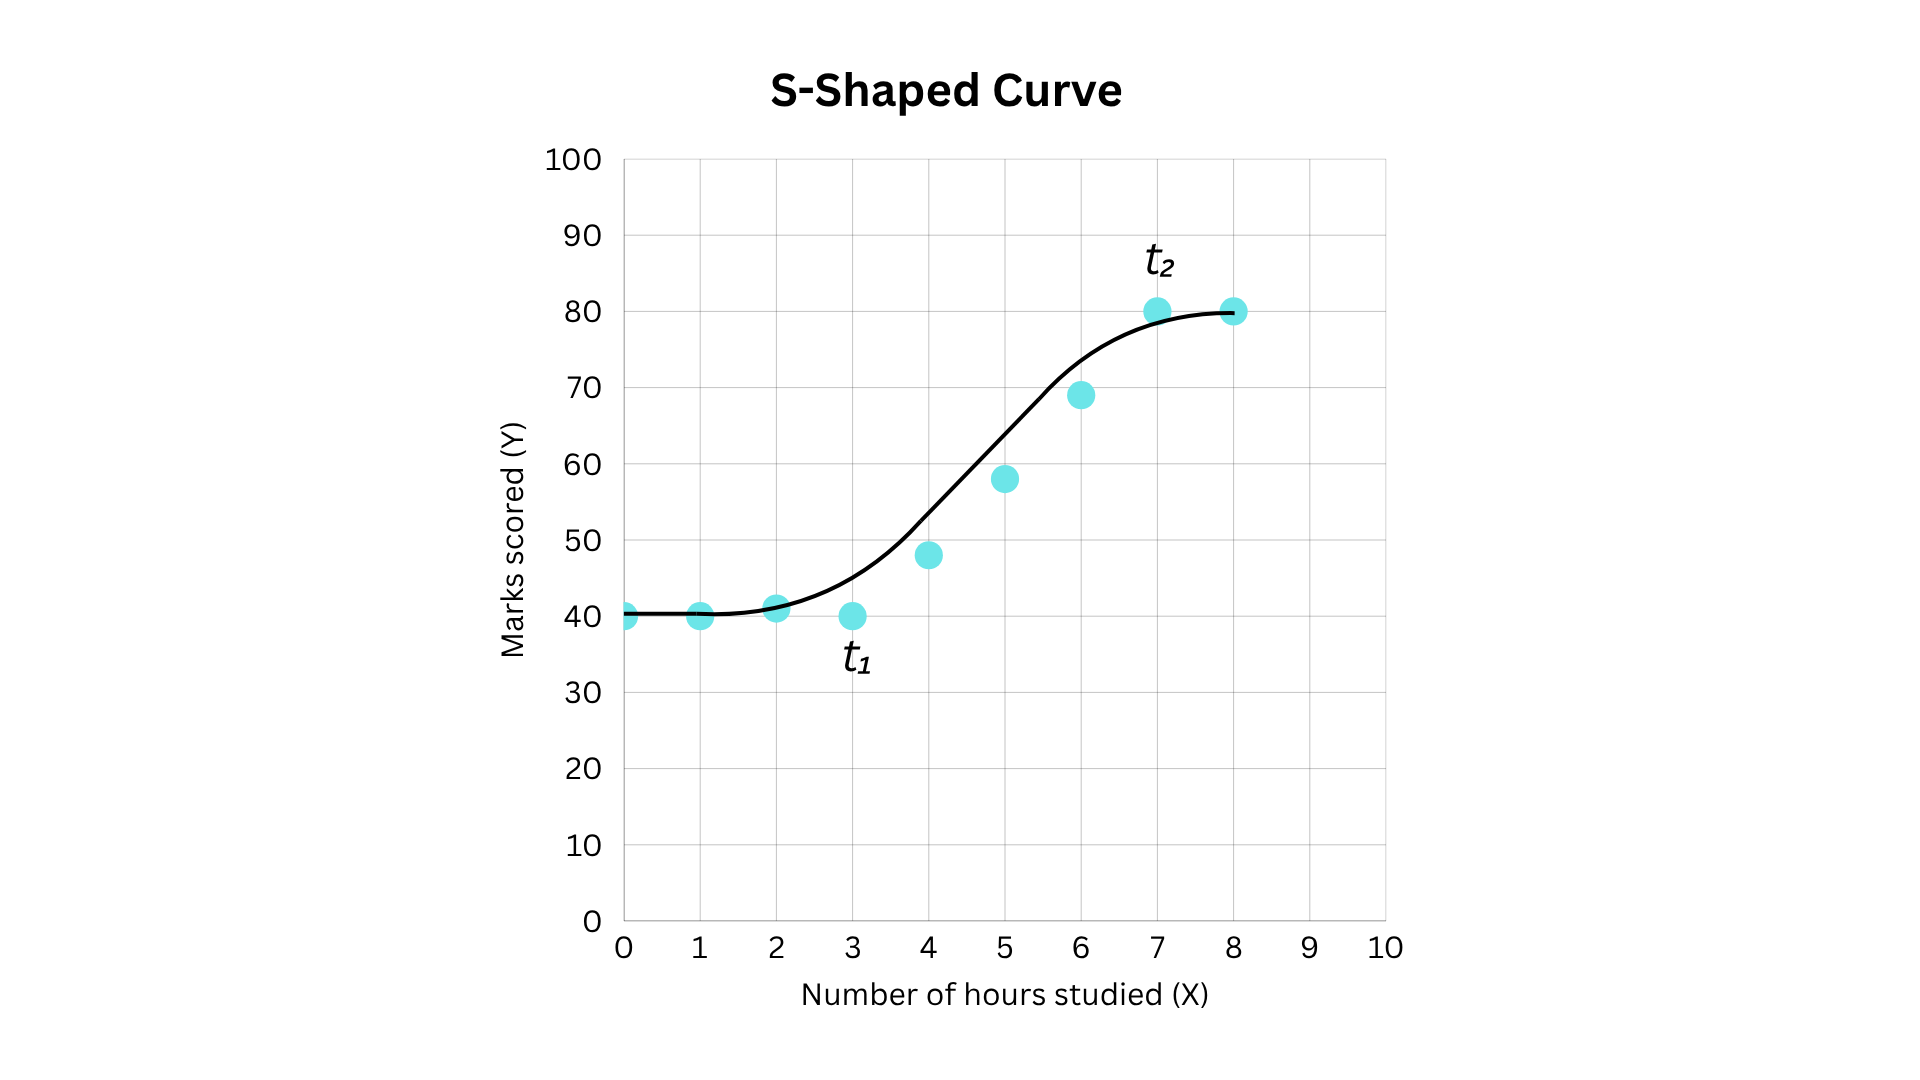 这种图表表明:当学生学习的时间不超过t1小时时,他们的成绩几乎不会有变化;而当学习时间从t1增加到t2时,他们的成绩会明显提高,因此这条曲线呈现出上升的趋势;到了t2时刻,这种增长趋势又会趋于平稳。这种变化过程是渐进且连续的,并不像那些由若干段直线组成的分段线性曲线那样会在某些点发生方向上的突变。
波莉女士所绘制的这条曲线并非某种随意生成的图案,它也可以用数学公式来表示。能够生成这种形状的函数之一就是Sigmoid函数。
什么是Sigmoid函数?
Sigmoid函数是一种数学公式,它可以将任何实数输入映射到0到1之间的值。这种函数的输出值会从接近0的值开始缓慢增加,在中间部分迅速上升,然后逐渐趋于平稳,最终接近1。
y = σ(x) = 1 / (1 + exp(-x))下图展示了Sigmoid函数的图像:
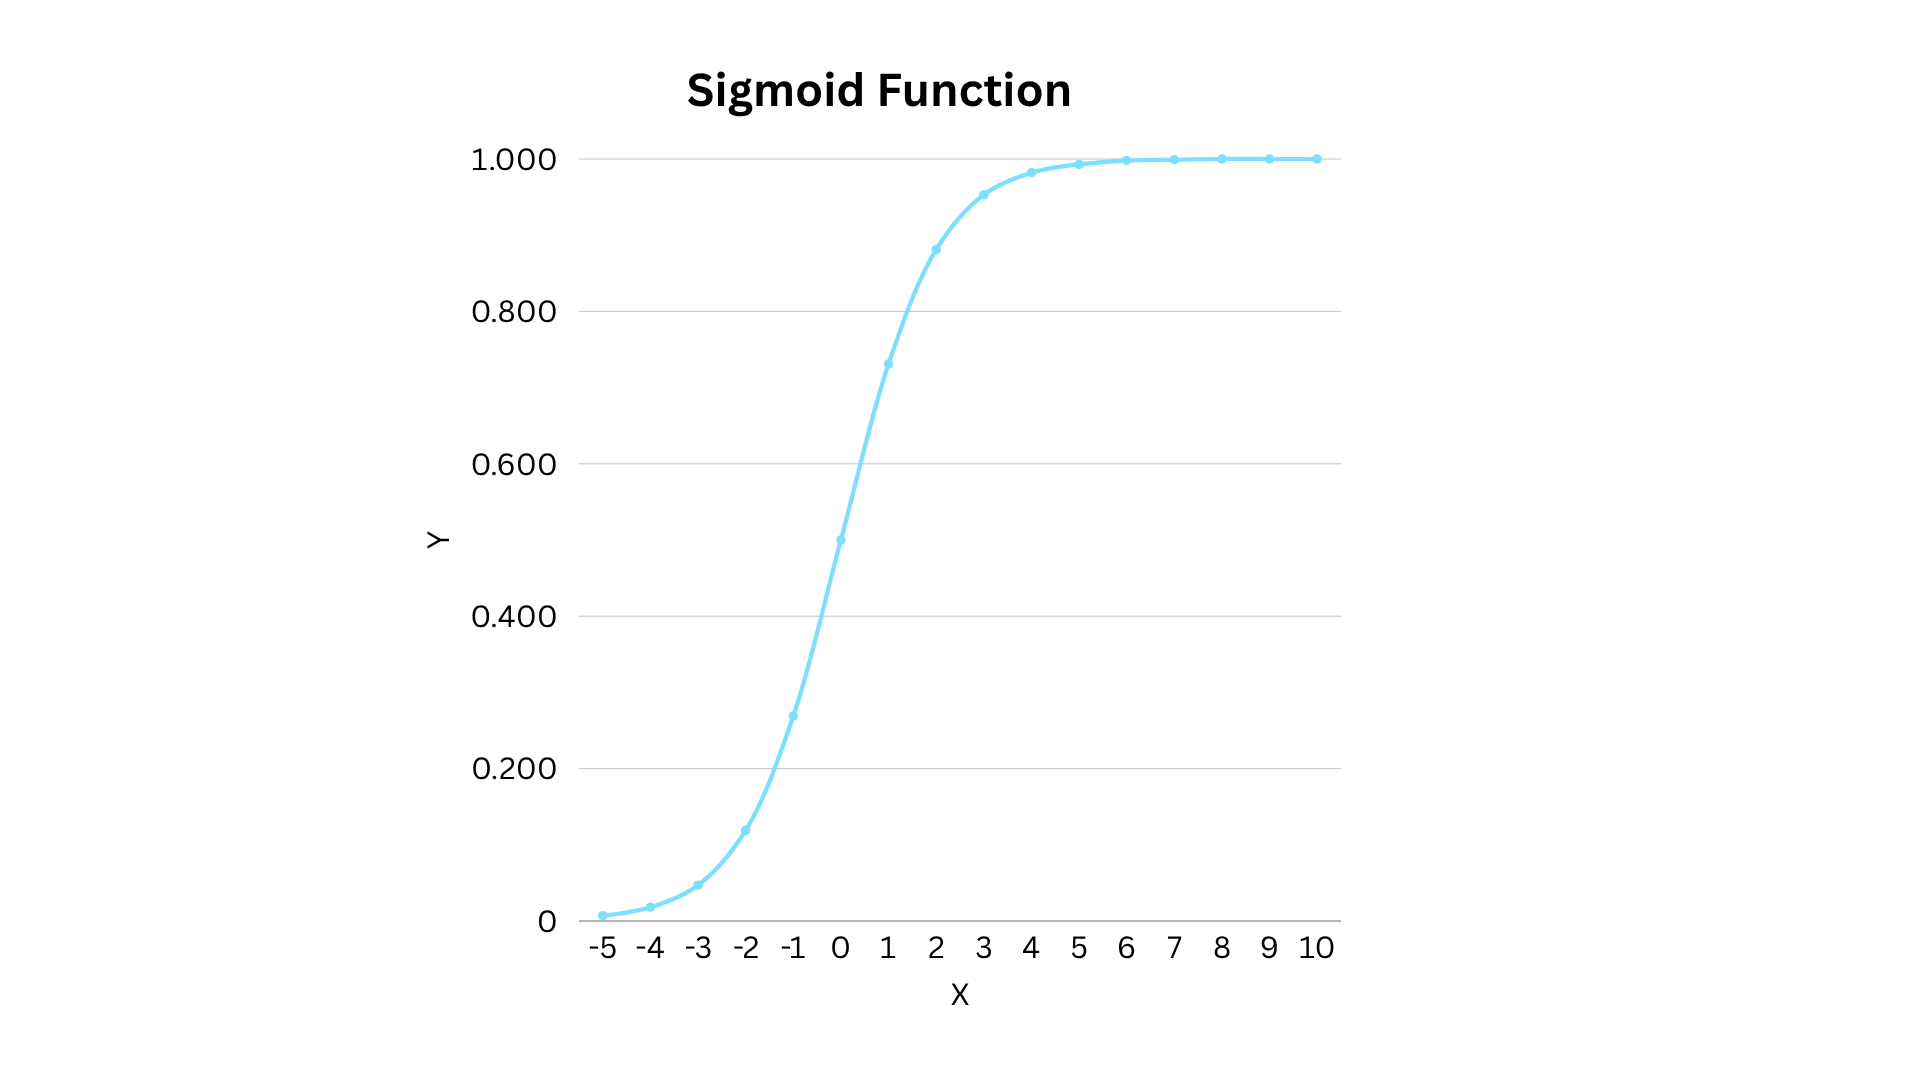
Sigmoid函数在神经网络中具有重要意义,因为它既能引入非线性特性,又能将输出值限制在0到1之间。因此,当需要用输出结果来表示概率时,这种函数非常有用——例如用来表示学生通过考试的概率。Sigmoid函数的输出值越高,说明学生通过考试的概率越大,反之亦然。
构建深度神经网络
现在,波莉女士应该将线性方程与非线性方程的概念结合起来,来构建一个深度神经网络。为此,她需要采取两种不同的方法:
预测学生考试的成绩
判断学生考试是否及格
她使用了两个非常简单的、未经训练的神经网络,分别为这两个任务设置了手动选择的权重和偏置值。她这样做只是为了演示计算过程而已;在实际情况中,她不会自己选择这些参数。她会让神经网络在训练过程中通过反复比较预测值与实际结果来自动调整权重和偏置值,从而最小化误差。
使用ReLU函数预测成绩
步骤1:构建神经网络
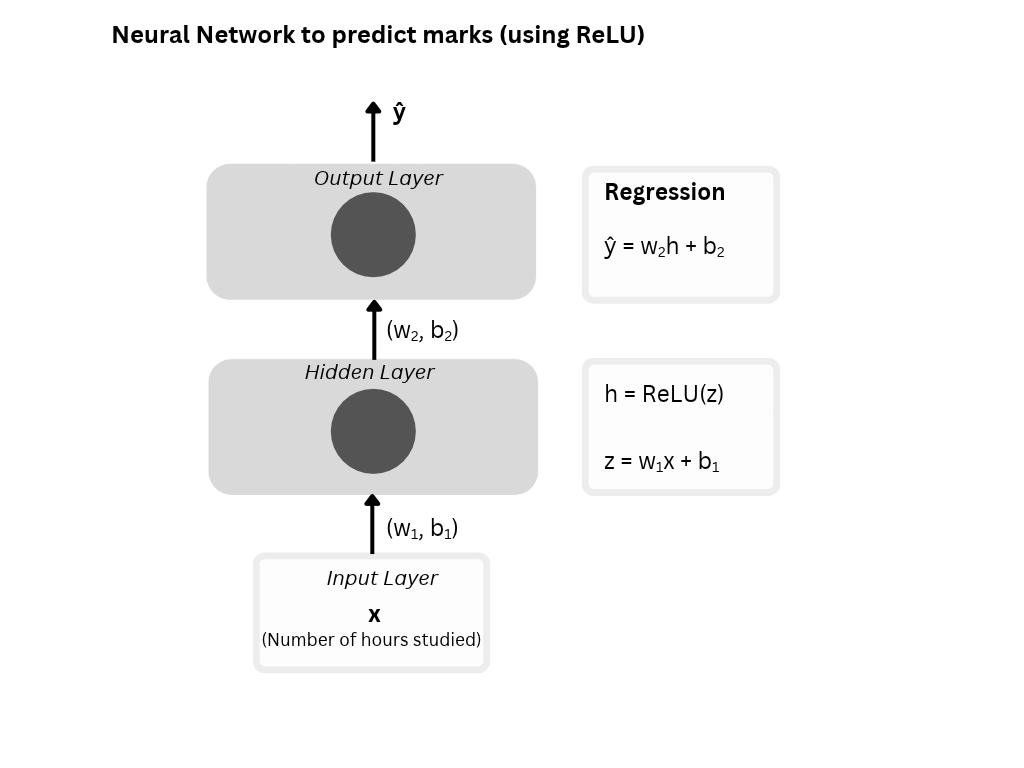
波莉女士按照以下方式使用简单的数学公式构建了这个深度神经网络:
输入层:这里接收学生学习的总时长(x)作为输入。
隐藏层:对输入数据进行线性变换,并应用ReLU函数进行处理。
z = w₁x + b₁; h = ReLU(z) = max(0, z)输出层:在对隐藏层的输出结果(h)进行线性变换后,就可以预测出学生的最终成绩。
ŷ = w₂h + b₂; ŷ = 10h + 40
步骤#2:计算预测分数
假设她想要计算一个学习了5小时的学生所获得的分数,具体的计算过程如下:
z = w₁x + b₁, = x - 3 = 5 - 3 = 2
h = ReLU(z) = max(0, z) = max(0, 2) = 2
最后计算出预测分数:
ŷ = w₂h + b₂ = 10h + 40 = 10(2) + 40 = 60
神经网络预测的分数是60分,而数据集中该学生的实际分数为58分。
步骤#3:将预测结果与实际分数进行比较
在获得了神经网络预测出的所有分数后,Poly女士将这些预测结果与下表中的实际数据进行了对比:
| 学习时间(小时) | 实际得分 | )预测分数 |
|---|---|---|
| 0 | 40 | 40 |
| 1 | 40 | 40 |
| 2 | 41 | 40 |
| 3 | 40 | 40 |
| 4 | 48 | 50 |
| 5 | 58 | 60 |
| 6 | 69 | 70 |
| 7 | 80 | 80 |
| 8 | 80 | 90 |
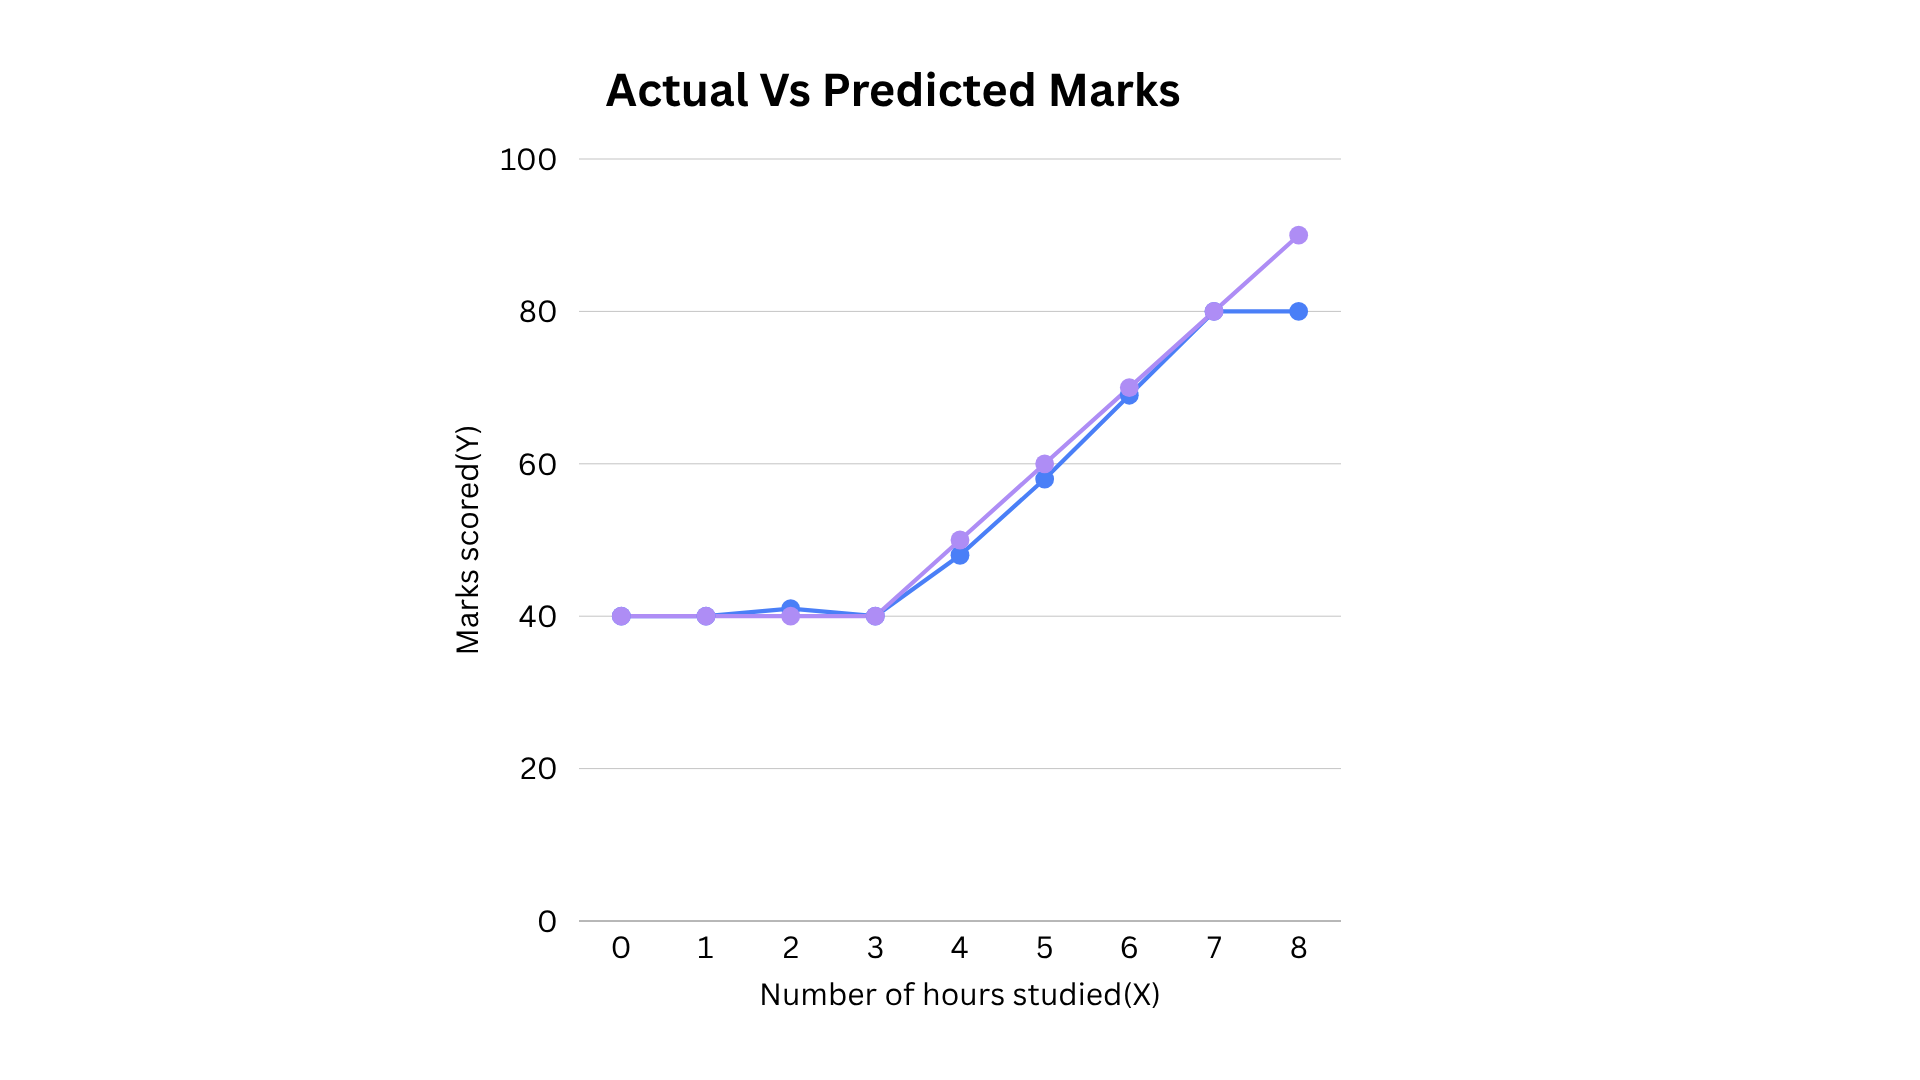
实际分数与预测分数并不完全一致,但相差不大。由于在应用ReLU函数后数值会持续增加,因此分数呈上升趋势,并没有在最后趋于平稳。
通过这个例子,Poly女士展示了ReLU函数如何在数据中模拟非线性关系。
使用ReLU和Sigmoid函数预测及格/不及格
接下来,Poly女士将利用神经网络来预测学生是否能在期末考试中及格。她假设学生需要至少获得50分才能及格,因此这个神经网络将被用来预测考生通过考试的概率。
步骤#1:构建神经网络模型
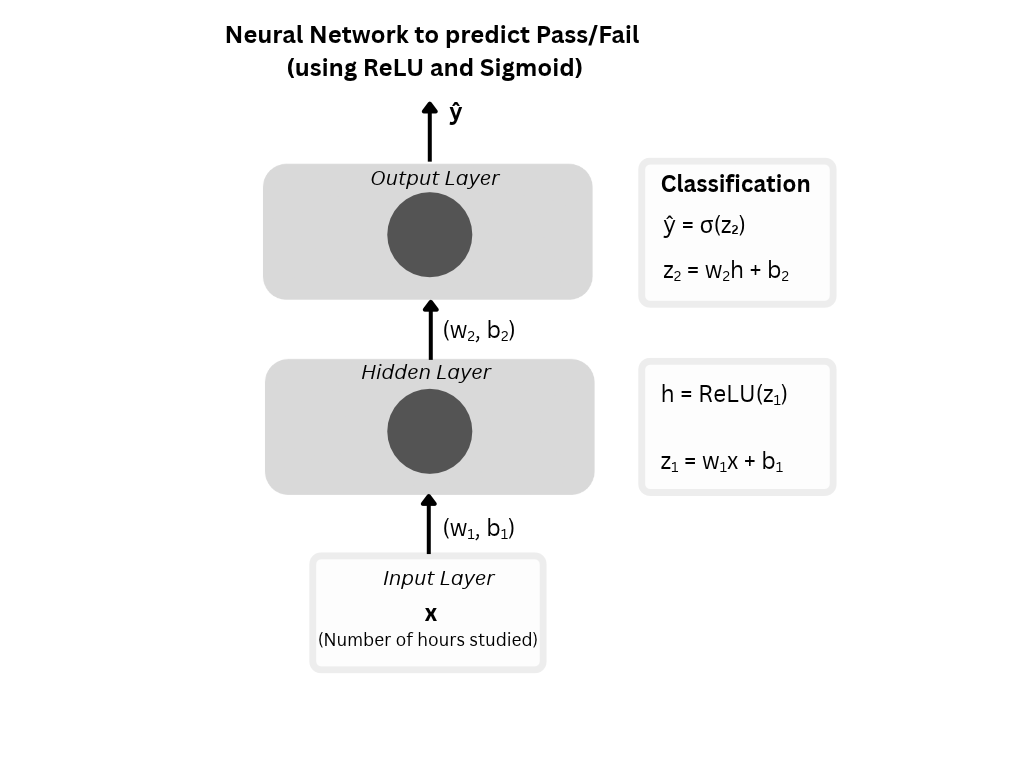
Poly女士按照以下方式使用简单的数学公式构建了深度神经网络:
输入层:这里接收学习时间(小时)这一参数。
隐藏层:对输入数据进行线性变换,然后应用ReLU函数。
z₁ = w₁x + b₁, = x - 4      (w₁=1, b₁=-4)
h = ReLU(z₁) = max(0, z₁)
输出层:对隐藏层输出的结果再次进行线性变换,然后应用Sigmoid激活函数来预测及格/不及格结果。
z₂ = w₂h + b₂ = 2h - 1      (w₂=2, b₂=-1)
p = σ(z₂) = 1 / (1 + exp(-z₂))
ŷ = Pass, if p ≥ 0.5
ŷ = Fail, if p < 0.5
 步骤#2:计算通过/未通过的预测结果
假设她想要预测一个学习了3小时的学生最终的成绩。具体的计算过程如下:
z₁ = w₁x + b₁, = x - 4 = 3 - 4 = -1
h = ReLU(z₁) = max(0, z₁) = max(0, -1) = 0
接下来判断该学生是否通过考试:
z₂ = w₂h + b₂ = 2h - 1 = 2(0) - 1 = -1
p = σ(z₂) = 1 / (1 + exp(-z₂)) = 1 / (1 + exp(-(-1))) ≈ 0.269
由于0.269小于0.5,因此该学生的成绩为未通过。
现在来看一个学习了5小时的学生的情况:
z₁ = w₁x + b₁, = x - 4 = 5 - 4 = 1
h = ReLU(z₁) = max(0, z₁) = max(0, 1) = 1
再次判断该学生是否通过考试:
z₂ = w₂h + b₂ = 2h - 1 = 2(1) - 1 = 1
p = σ(z₂) = 1 / (1 + exp(-z₂)) = 1 / (1 + exp(-1)) ≈ 0.731
由于0.731大于0.5,因此该学生的成绩为通过。
步骤#3:将预测结果与实际结果进行对比
| 学习时长 | 得分 | )实际结果 | 预测得分 | 预测结果 |
|---|---|---|---|---|
| 0 | 40 | 未通过 | 0.269 | 未通过 |
| 1 | 40 | 未通过 | 0.269 | 未通过 |
| 2 | 41 | 未通过 | 0.269 | 未通过 |
| 3 | 40 | 未通过 | 0.269 | 未通过 |
| 4 | 48 | 未通过 | 0.269 | 未通过 |
| 5 | 58 | 通过 | 0.731 | 通过 |
| 6 | 69 | 通过 | 0.953 | 通过 |
| 7 | 80 | 通过 | 0.993 | 通过 |
| 8 | 80 | 通过 | 0.999 | 通过 |
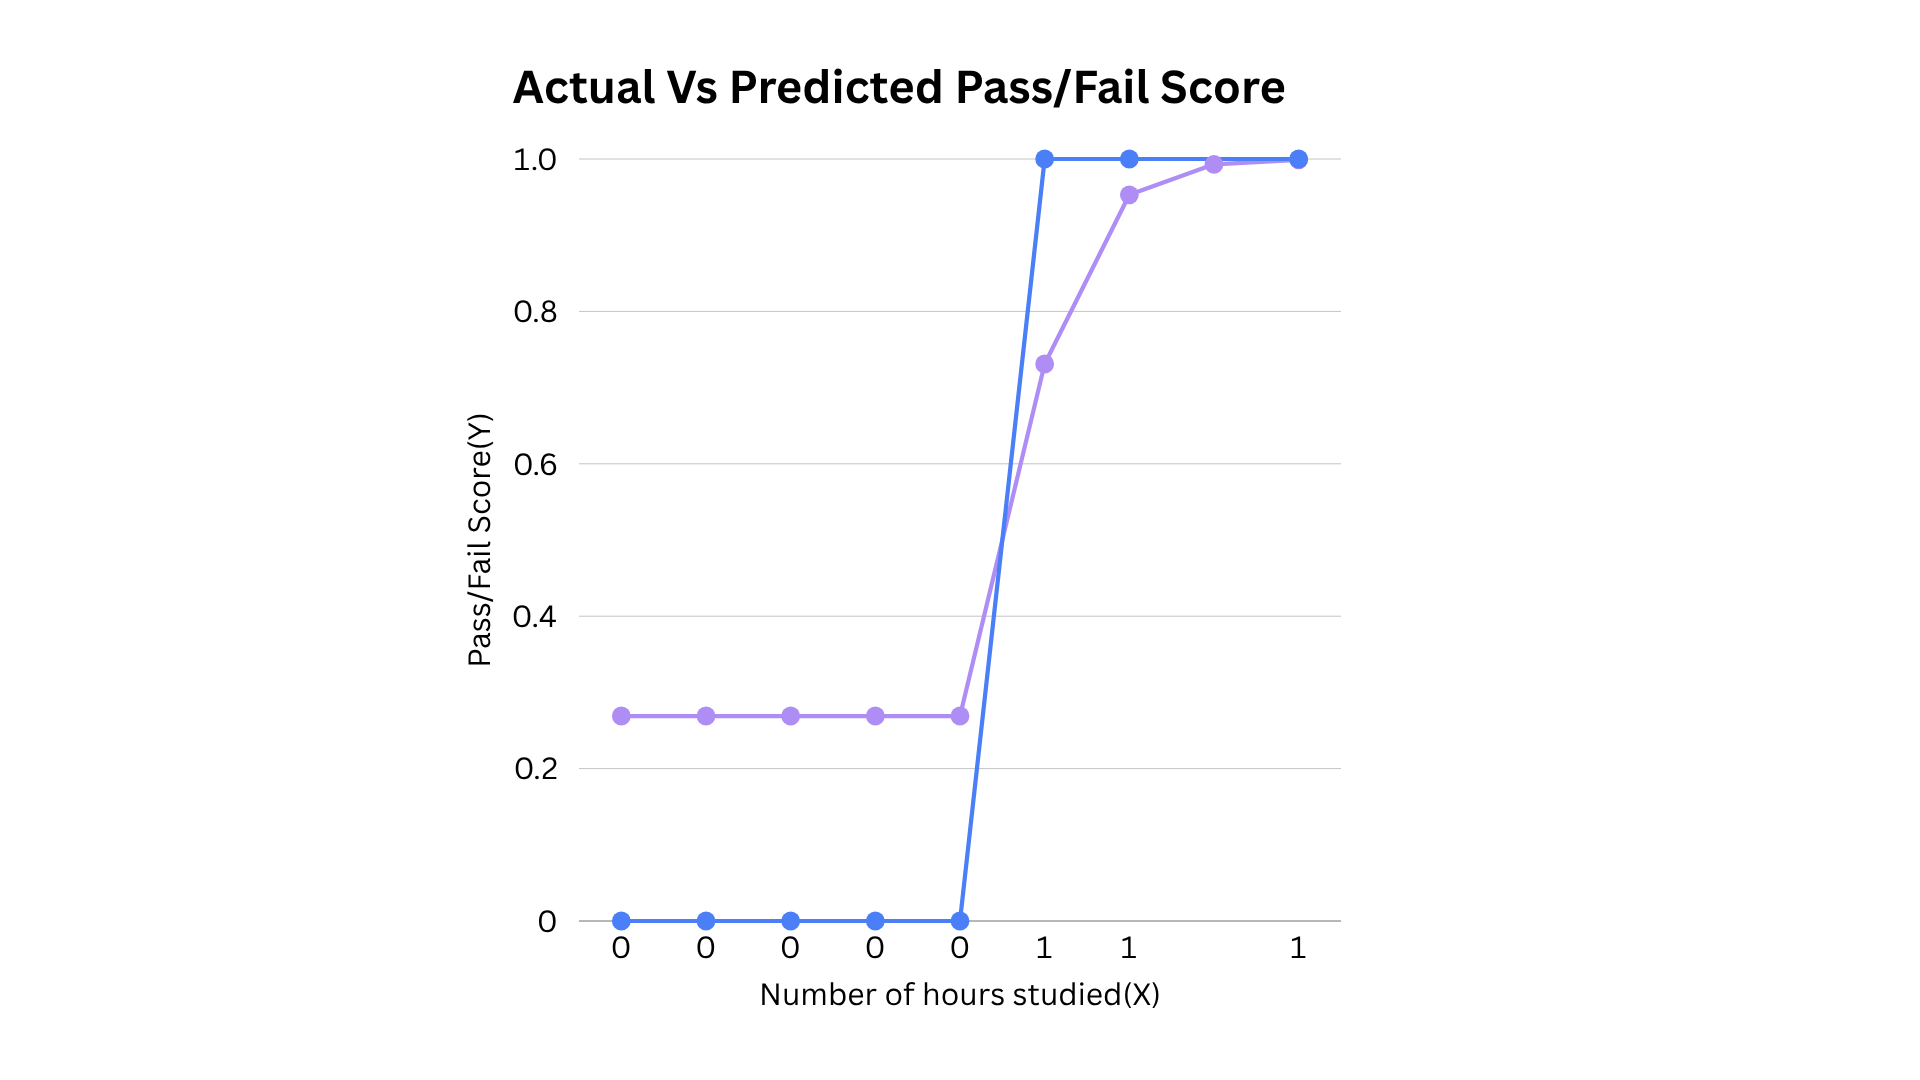
在这个例子中,该模型正确地预测了所有学生的最终成绩。当学习时长超过4小时时,预测得分会升高,从而增加学生通过考试的概率。
通过这个例子,Poly女士展示了ReLU函数与Sigmoid函数是如何协同工作的:ReLU函数用于处理隐藏层中的输入数据,而Sigmoid函数则将输出结果转换为可以用来判断是否通过考试的分数。
最后的思考
上面这些简单的例子帮助我们理解了关于神经网络的一个重要原理:不同输入部分对应的输出结果之间可能存在差异,因此必须捕捉到这些差异,才能从实际数据中得到有意义的结果。
当数据之间的关联关系简单且具有规律性时,使用直线方程即可满足需求。但现实世界中的数据往往并非如此直观明了。通过引入非线性因素,神经网络便能够突破直线关系的限制,从而识别出数据中隐藏的复杂规律。相关文章
当怀孕改变了用户的正常生理状态时,可穿戴设备该如何做出相应的调整?
你的智能手环或手表具备许多实用功能,比如能够记录你平时的生理数据,并在这些数据发生变化时及时提醒你。 静息心率、心率变异性、体温以及呼吸频率等因素都能帮助形成这些生理数据的画像,不过不同的设备会对这些测量结果进行不同的解读。 在怀孕之前,这些指标通常会保持稳定的状态,但怀孕会改变其中一些指标的正常范围。 我每天早上第一个打开的应用程序就是Oura,因此我很清楚一个评估结果的准确性会对我的一天产生多大的影响。如果“准备程度得分”过低,我会觉得自己做错了什么,但实际上并没有。现在想象一下,在你的身体正在经历一系列正常的生理变化期间,连续几周都看到这样的评估结果会是什么感觉…… 这就是我想在这里讨论
阅读全文
如何在问题真正发生之前发现运营中的异常变化?
在 我之前的文章中 ,我探讨了“操作符合性”这一概念:即如何判断观察到的实际情况是否满足既定的操作规范。 这就引出了一个很有意义的问题: 当前这个系统是否仍然符合这些规范? 然而,生产环境中的系统是不会一成不变的。 流量会发生变化,依赖关系可能会恶化,证书也会过期,配置设置会被修改,功能开关的状态也会改变,数据量会不断增加,人们还会进行手动操作,各种代理程序也会执行相应的动作,基础设施也会被替换等等。 一个系统在部署后可能最初是符合规范的,但几小时或几天后就可能不再符合这些规范了。 这就是我想在这里探讨的问题。 “操作漂移”指的是系统的实际运行状态与既定操作规范之间的差异会随着时间逐渐增大。
阅读全文
Pinterest利用事件时间戳来确定那些规模高达拍字节级别的数据分区的划分方式。
Pinterest为其数据库数据摄入框架引入了基于事件时间的划分机制。该机制利用Apache Flink来跟踪事件发生的时间,并通过Apache Iceberg元数据来生成一种不会随时间变化而改变的水印信息,从而帮助后续处理任务判断:持续摄入的CDC数据是否已经达到可以开始处理的完整程度。 作者:Leela Kumili
阅读全文
智能代理的可靠性:为工具的使用、安全机制、循环流程以及工作流程的输出结果构建相应的测试框架 [完整书籍]
一个完美的最终结果并不能证明某个具有自主行为能力的人工智能系统的工作流程是正确的。 本书提出了一种基于代码的方法,用于验证系统执行过程及所产生的业务成果,并利用这些证据来决定是否允许该系统正式投入使用。 书中还提供了一个可运行的离线测试工具,用以演示各种核心技术。第19章专门区分了那些已经实现的功能与那些仍处于开发阶段、尚未投入实际应用的扩展功能。 目录 引言 第一部分:可靠性差距 第二部分:基础原理 第三部分:核心结论 第四部分:行为特征 第五部分:跨领域问题 第六部分:决策过程 第七部分:诚实性与普及度 结论 术语表 参考文献 生产就绪性检查清单 引言 那个“虚假的演示” 许多具有自主行为
阅读全文