
如何使用Python和依赖关系图来检测公共数据集中隐藏的目标泄露现象
不久前,我给一个机器学习模型提供了来自公共CDC数据集的五列数据,让它尝试预测同一文件中的第六列数据。该模型的R²值为0.998,这个数值已经非常接近完美了。 虽然这个结果看起来很成功,但实际上该模型对现实世界的认知几乎没有任何提升——因为CDC本身就是根据其他五列数据计算出了第六列数据的,所以该模型实际上只是机械地应用了CDC的计算方法而已。 数据科学家将这种问题称为 目标信息泄露 ,当输入给模型的数据本身就已经包含了答案的某些信息时,就会发生这种情况。 在公共数据中,这类问题很容易被隐藏起来,因为大量的公共数据都是通过其他公共数据计算得出的。例如,一个政府指数可能是根据调查数据构建的,而另
不久前,我给一个机器学习模型提供了来自公共CDC数据集的五列数据,让它尝试预测同一文件中的第六列数据。该模型的R²值为0.998,这个数值已经非常接近完美了。
虽然这个结果看起来很成功,但实际上该模型对现实世界的认知几乎没有任何提升——因为CDC本身就是根据其他五列数据计算出了第六列数据的,所以该模型实际上只是机械地应用了CDC的计算方法而已。
数据科学家将这种问题称为目标信息泄露,当输入给模型的数据本身就已经包含了答案的某些信息时,就会发生这种情况。
在公共数据中,这类问题很容易被隐藏起来,因为大量的公共数据都是通过其他公共数据计算得出的。例如,一个政府指数可能是根据调查数据构建的,而另一个指数则可能是基于前一个指数计算而来的。各机构会在他们的方法说明文档中解释这些计算流程,但数据目录却很少以计算机能够识别的形式来存储这些信息。
在本教程中,你将亲自编写这样的数据记录文件,然后制作一个简单的Python工具来读取这些文件。这个工具的工作原理类似于包管理器中的依赖关系检查功能:你需要告诉它你想预测什么结果,以及打算使用哪些数据列,而该工具会自动拒绝那些位于通往目标结果的计算路径上的数据列。
通过本教程的学习,你将能够:
使用真实的CDC数据和scikit-learn库来重现这种“目标信息泄露”现象
通过一个名为“manifest”的YAML文件来了解某个数据集是由哪些数据构建而成的
使用广度优先搜索和深度优先搜索这两种方法来分析这些数据之间的关系
制作一个检查工具,当输入数据中存在拼写错误、文件损坏或为空等情况时,该工具会发出明显的警告信号
通过GitHub Actions自动在每次代码提交时执行这个检查流程
目录
先决条件
要跟随本教程进行学习,您需要具备以下条件:
Python 3.10或更高版本
对pandas DataFrame的基本概念有所了解
一个可以运行命令的终端环境
约7MB的空闲磁盘空间,用于存储CDC数据文件
请创建一个新的项目文件夹,并在其中设置虚拟环境,这样这些库就不会与您的系统其他部分混在一起。接下来,请安装本教程中会用到的三个库:
mkdir leak-tutorial
cd leak-tutorial
python3 -m venv .venv
source .venv/bin/activate
pip install pandas scikit-learn pyyaml
在Windows系统中,请运行.venv\Scripts\activate代替source命令,并且当文章中提到python3时,请使用python。本教程中的所有命令都应在leak-tutorial文件夹内执行。
本教程中创建的所有文件也都存储在配套的代码仓库derives-from-tutorial中,因此如果您遇到困难,可以参考这些文件来核对自己的工作结果。
该工具的完整版本托管在公开的GitHub仓库中,文章结尾我会提供相应的链接。
通俗易懂的关键术语
在本教程中,有五个术语会反复出现,下面对这些术语进行解释:
目标变量:您希望模型用来进行预测的列。
协变量:您输入到模型中的数据列,这些数据有助于模型预测目标变量(很多人将这类数据称为“特征”)。
R²值:这个数值用来衡量模型的预测结果与实际数据的吻合程度。R²值为1.0表示预测结果完全准确,而接近0则表示模型解释能力很弱。
人口普查区域:美国境内的一种小型行政区划,通常容纳约4,000人,其规模大致相当于一个社区。
交叉验证:一种公平的模型测试方法。将数据分成五部分,用其中四部分进行训练,用第五部分进行测试,重复这个过程直到每个部分都曾被用作测试集。
步骤1:亲自观察这一现象
美国疾病控制与预防中心会发布社会脆弱性指数,紧急情况规划人员可以利用这个指数来识别在洪水、热浪或疾病爆发期间可能需要额外援助的社区。
CDC是分层次构建这个指数的。它首先使用了美国人口普查局进行的大规模调查——美国社区调查中的16个数据列。这些数据列都是百分比形式,例如贫困人口的占比或没有车辆的家庭的占比。
CDC将这16个数据列分为四个主题,并对每个主题下的人口普查区域进行排名。最后,它将这四个主题的排名合并成一个综合评分,称为RPL_THEMES。
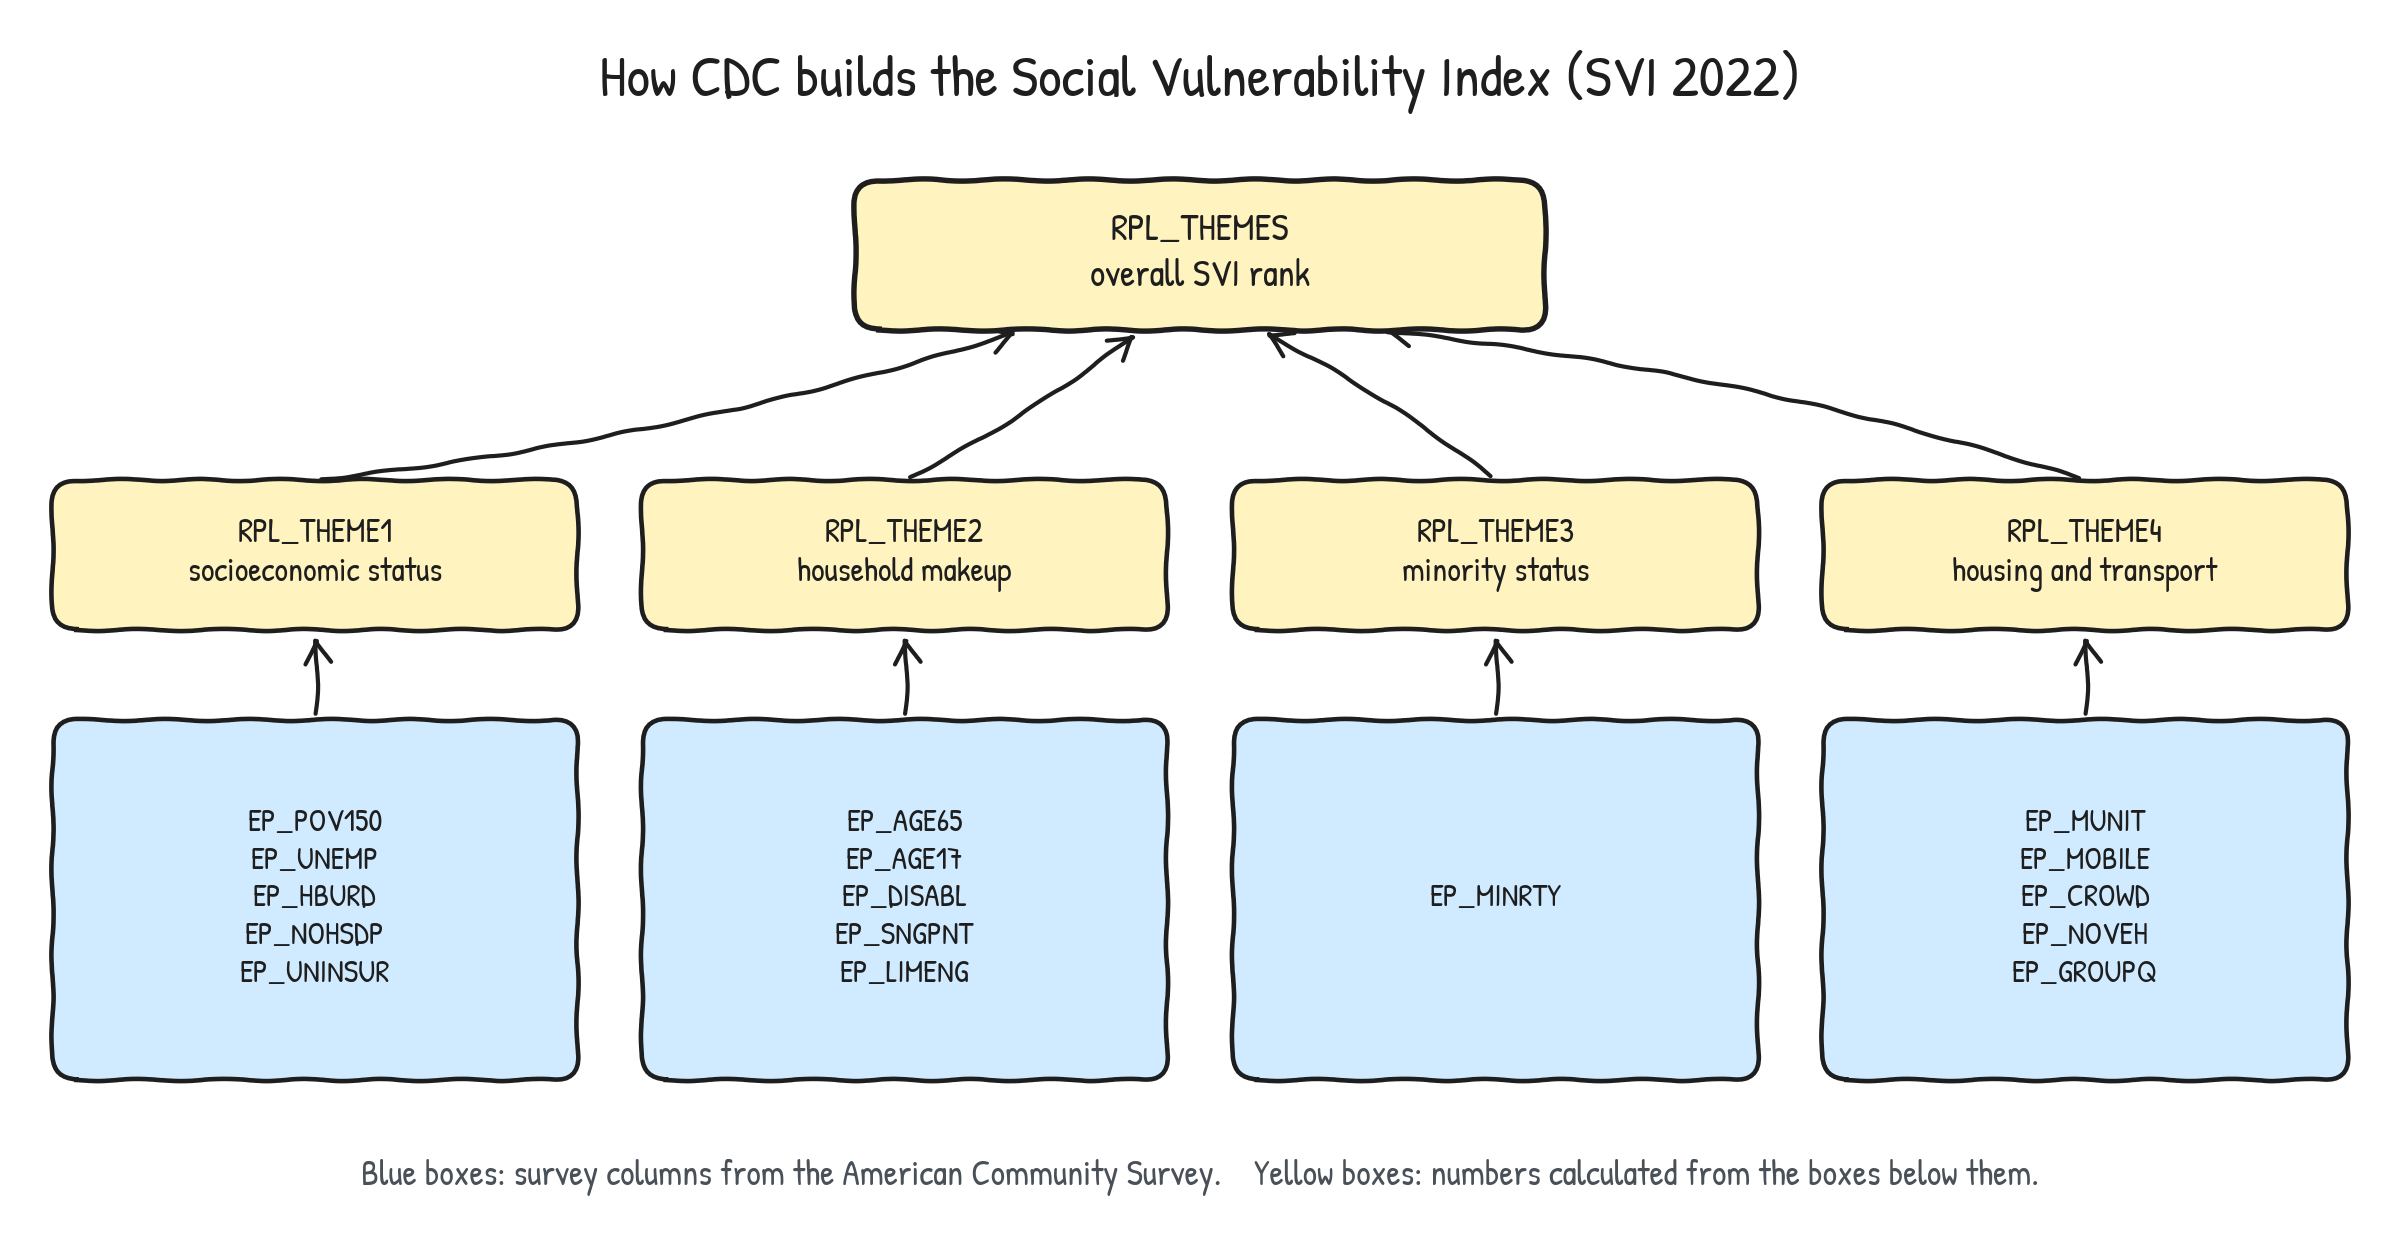
CDC是如何计算SVI排名的:16个ACS调查指标决定了4个主题排名,而这4个主题排名又共同构成了最终的总体排名。每一个黄色方框的值都是根据其下方的数据计算得出的。
对于本教程来说,需要了解的是:CDC会将原始的ACS调查数据以及最终计算得到的排名结果一起保存在同一个CSV文件中。这样一来,我们就可以非常方便地将这两部分数据合并到同一个模型中进行分析了。
下载加利福尼亚州的数据文件:
curl -L -o California.csv https://svi.cdc.gov/Documents/Data/2022/csv/states/California.csv
我在这里使用`curl`命令,是因为在macOS系统中,某些Python版本在直接下载文件时无法验证网站的安全证书。
现在创建一个名为`leak_demo.py`的文件:
"""leak_demo.py: 根据构建指数的具体数据列来预测最终的指数值。」
import pandas as pd
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.model_selection import KFold, cross_val_score

# CDC使用-999来标记缺失值,因此我们需要将这些值替换为真正的空字符串。
df = pd.read_csv("California.csv", low_memory=False).replace(-999, float("nan"))

def score(inputs, target):
    data = df[inputs + [target]].dropna()
    model = HistGradientBoostingRegressor(random_state=0)
    folds = KFold(n_splits=5, shuffle=True, random_state=0)
    r2 = cross_val_score(model, data[inputs], data[target],
                         cv=folds, scoring="r2").mean()
    print(f"{target:<11} 是由 {len(inputs)} 个数据列计算得出的,
          数据总量为 {len(data)} 条记录,R²值为 {r2:.3f}")

# 主题1正是由这5个数据列构建而成的。
score(["EP_POV150", "EP_UNEMP", "EP_HBURD", "EP_NOHSDP", "EP_UNINSUR"], "RPL_THEME1")

# EP_NOINT这个数据列也在同一个文件中,但CDC并没有将其纳入指数计算中。
score(["EP_NOINT"], "RPLnTheMES")
这个脚本的功能如下:
它首先加载CSV文件,并将CDC使用的-999标记替换为空字符串,因为CDC确实是用-999来表示缺失值的。
`score`函数会训练一个梯度提升模型,这种模型非常适合用于处理数值数据,而且它会通过五折交叉验证来计算R²值。
第一次调用该函数时,会使用CDC用来构建主题1的那5个数据列来预测主题1的排名。
第二次调用该函数时,会使用`EP_NOINT`这个数据列来预测整体的排名。这个数据列代表的是没有宽带互联网订阅的家庭所占的比例,而CDC在同一个文件中提供了这个数据列,但却没有将其纳入指数计算中。
运行脚本:
python3 leak_demo.py
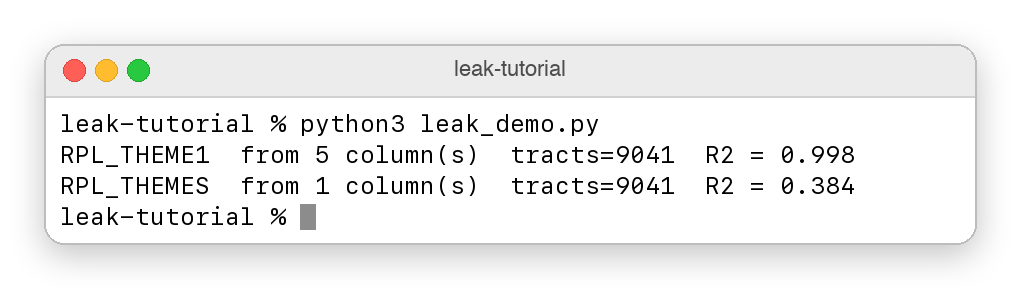
leak_demo.py程序的输出结果显示:通过CDC使用的五列数据预测得出的“主题1”的模型,其R²值为0.998;而通过忽略CDC索引中某一列数据进行预测时,该模型的R²值为0.384。
第一个数值为0.998,这意味着该模型几乎完美地复现了CDC制定的“主题1”预测模型。由于CDC的预测公式是固定不变的,因此该模型确实包含了所有必要的数据要素。
第二个数值为0.384。EP_NOINT这一列在文件中与索引相邻,其数值反映了两个相关指标之间的关联程度。
想象一下,如果有一篇论文报告称某个模型在预测社会脆弱性方面的R²值为0.998,这个数字看起来似乎是一项重大突破,但实际上它仅仅说明该模型掌握了CDC的预测公式而已。
本文中使用的各项数值都是基于scikit-learn 1.8.0版本得出的。从scikit-learn 1.3.2到1.9.0版本,这些数值的小数点后三位数字都保持不变,因此你的实验结果应该也是相同的。
步骤2:了解公共数据泄露的原因
SVI这个例子比较容易理解,因为输入数据和索引信息都保存在同一个文件中。然而大多数实际情况要复杂得多,因为数据流通往往涉及多个机构。 以下是一个涉及三个机构的真实案例:FEMA的国家风险指数包含了社会脆弱性评估指标。根据FEMA的技术文档(1.20版本,2025年12月),这一评估指标的数据来源于美国人口普查局的社区韧性估算结果,而美国人口普查局则是根据ACS调查数据来编制这些估算结果的。 因此,即使FEMA的风险评估指标和ACS调查数据分别来自不同的机构和网站,它们仍然可以成为同一个数据流通链中的组成部分。 要理解为什么计算机会忽略这种数据关联关系,就需要了解数字可能具有的两种“历史信息”:来源指的是这个数字是从哪里得来的。例如,某个数值来源于
California.csv文件,而该文件又来自svi.cdc.gov网站。计算过程指的是这个数字是如何计算出来的。例如,“主题1”这一评估指标就是根据五个ACS调查列数据计算得出的。
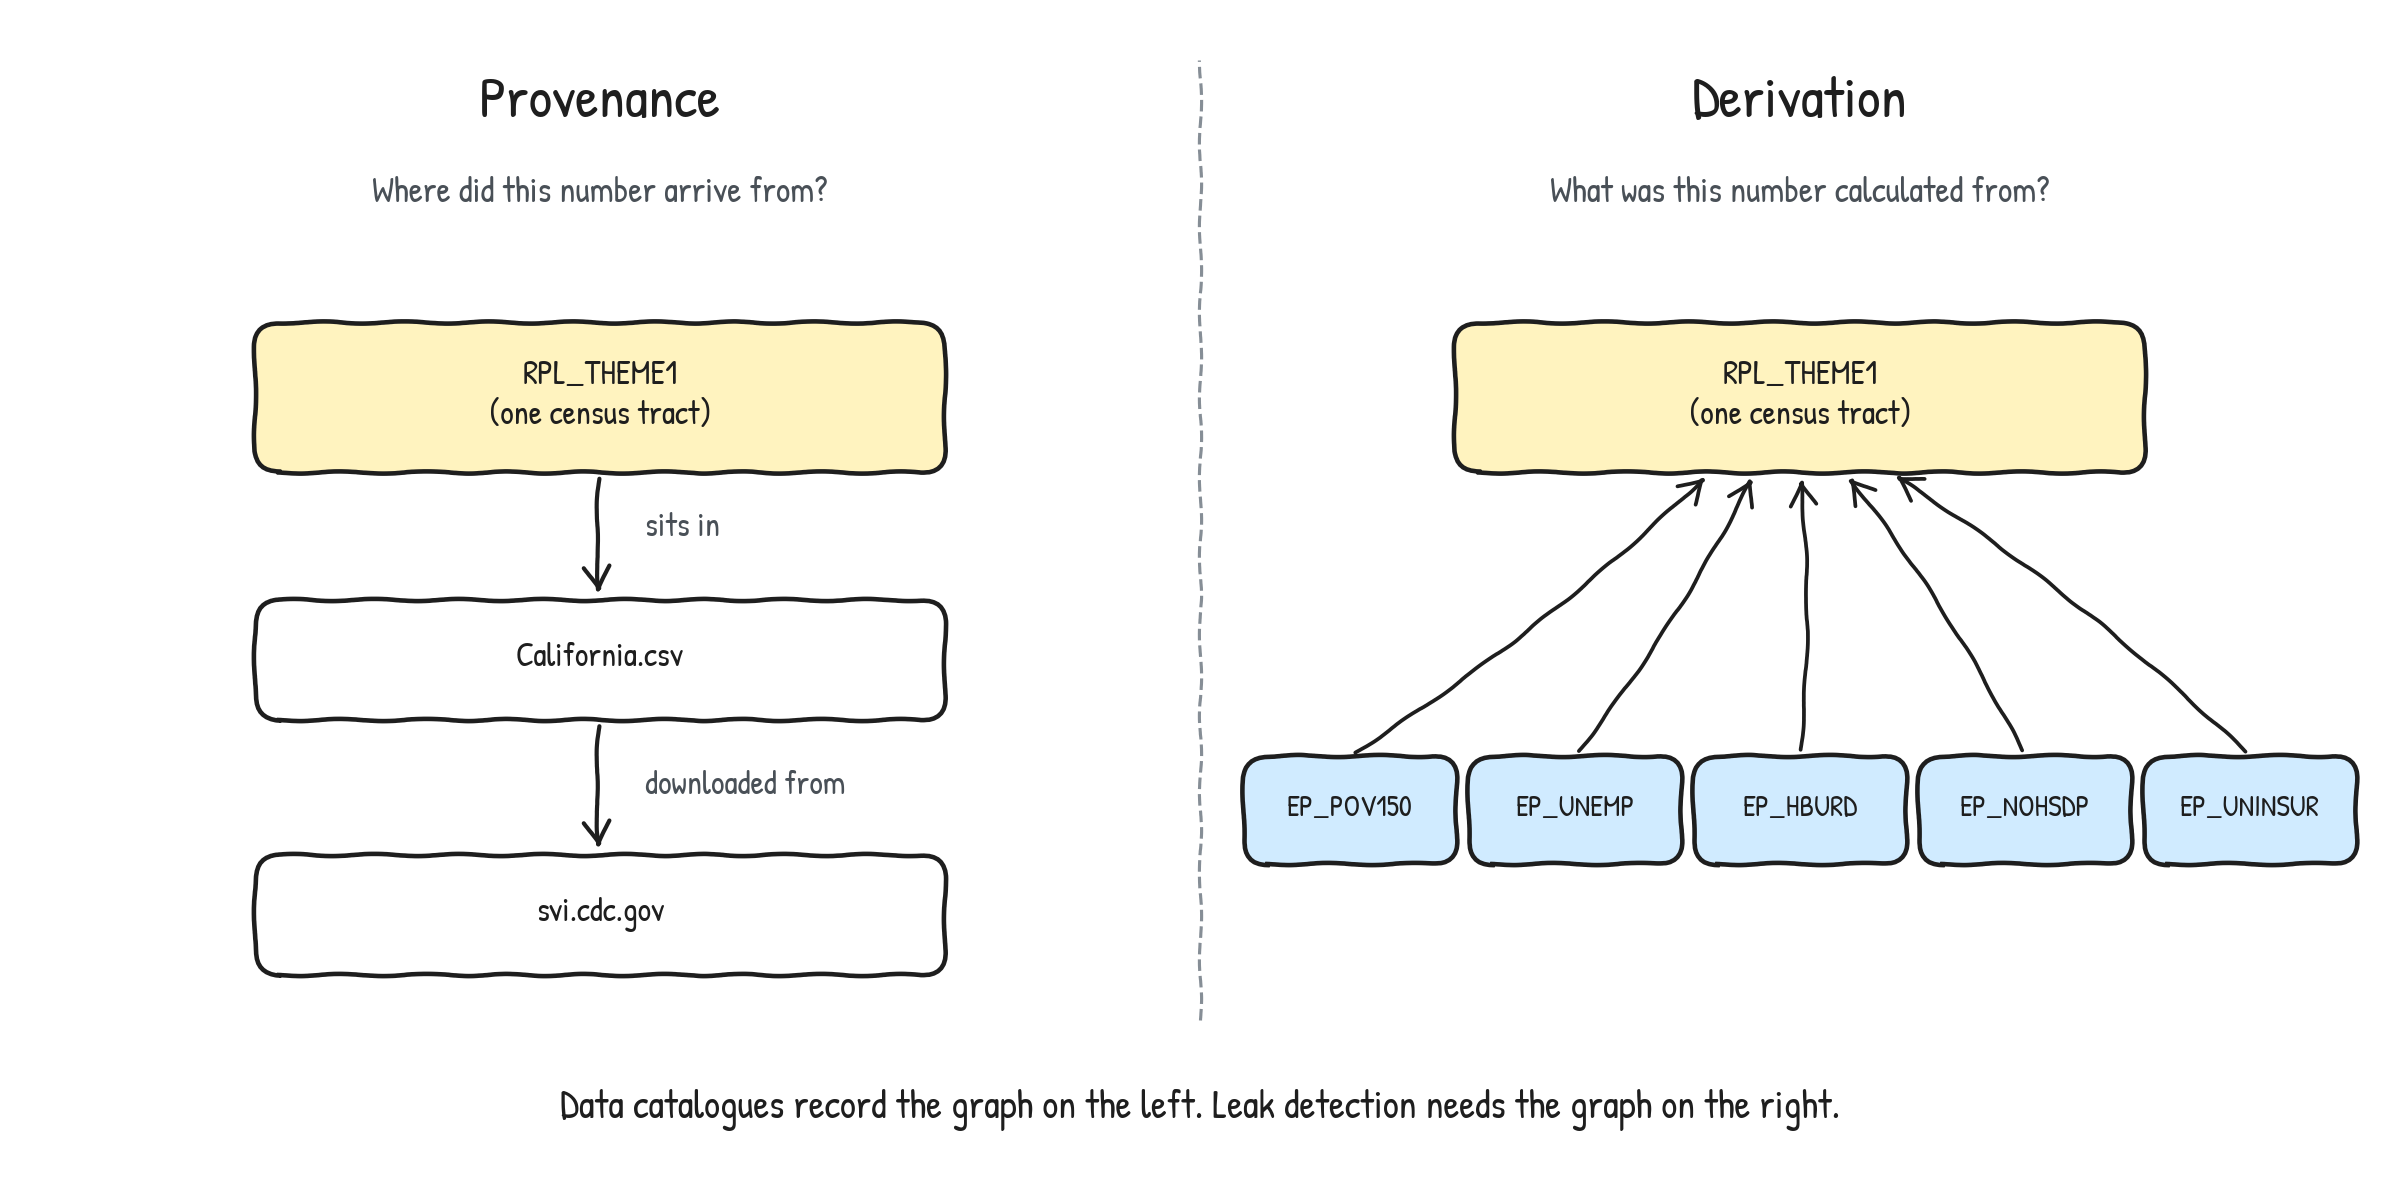 数字可能具有两种“历史信息”:左侧显示来源,即该数值来自哪个文件或网站;右侧显示计算过程,即该数值是根据哪些数据计算得出的。
大多数数据目录都能很好地记录数据的来源信息,谷歌的Data Commons就是一个很好的例子——它将数据来源定义为“数据的导入来源”,这样就能明确知道某个数值是从哪个文件中获取的。而关于数据的计算过程,通常只会记录在为人类阅读而编写的PDF方法说明文档中。
因此,当自动化流程在寻找有用的协变量时,它就可以轻松地收集构成目标变量的那些列。该流程会识别出得分较高的列,并保留这些列。
步骤3:从包管理器中获取灵感
很久以前,软件开发者就已经解决了非常类似的问题。
当你运行 `pip install requests` 时,pip会读取 `requests` 所依赖的包列表,然后继续追踪这些依赖包又依赖于哪些其他包,以此类推。由于所有的依赖关系都被明确记录了下来,因此pip能够在安装任何软件之前就发现其中可能存在的问题。
下图将这种依赖关系结构与实际数据中的对应关系进行了对比展示。
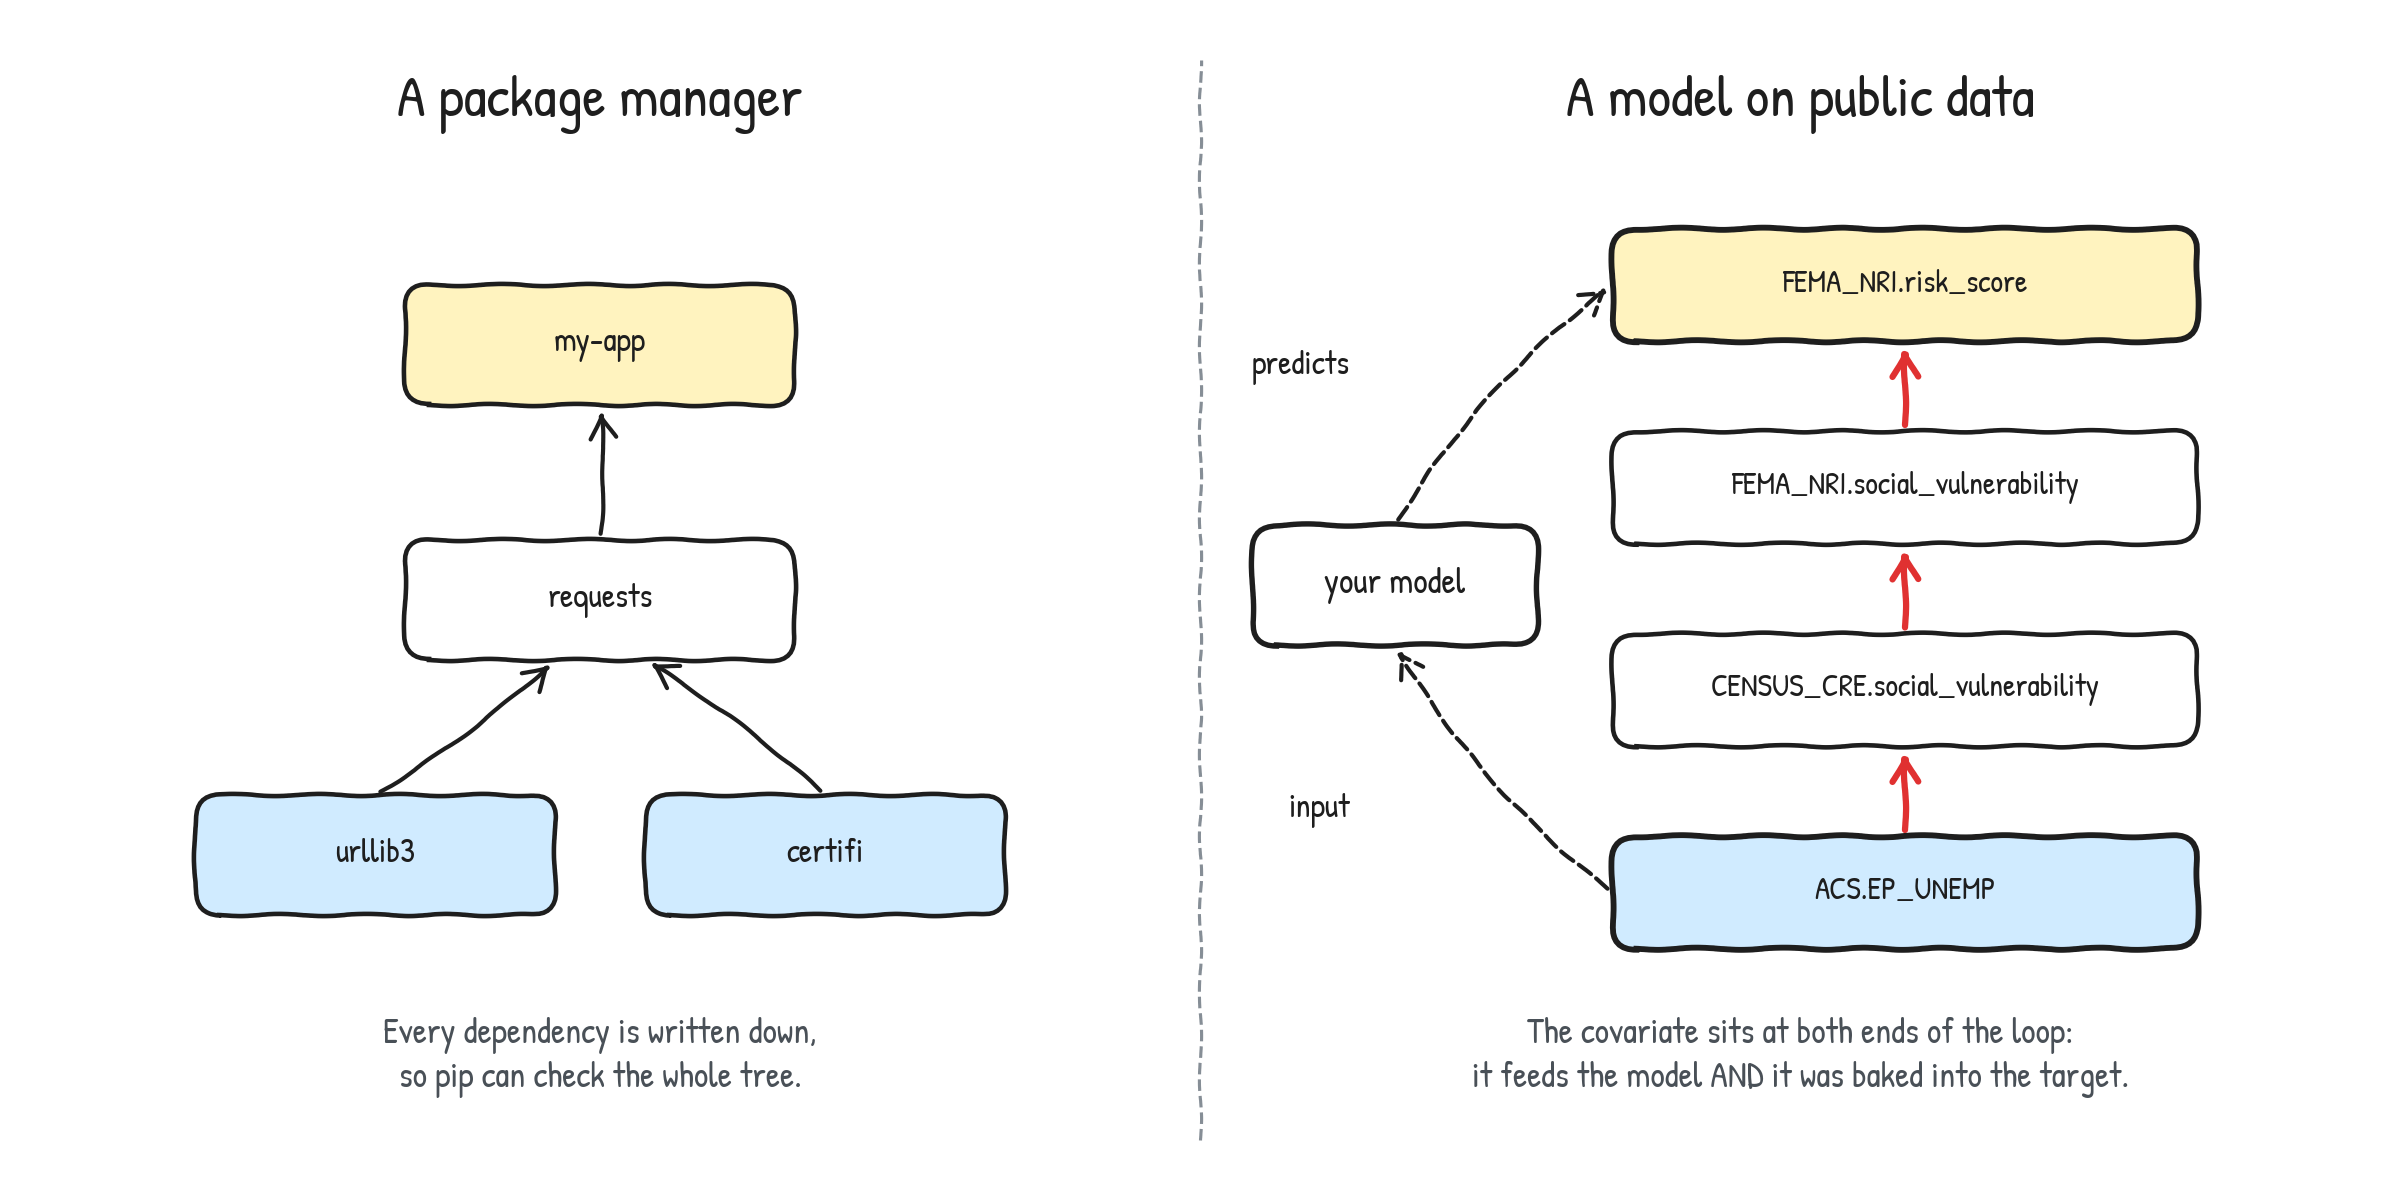
同样的结构,出现在两个不同的场景中。左图是pip的依赖关系树:`urllib3` 和 `certifi` 为 `requests` 提供数据,而 `requests` 又为 `my-app` 提供数据;右图则是实际数据中的处理流程:`ACS.EP_UNEMP` 被用于构建模型,以预测 `FEMA_NRI.risk_score`,而且同一列数据还会通过另外两个产品最终影响到这个风险评分结果。
公共数据也需要类似的记录结构。在上面的图中,右半部分显示了 `ACS.EP.UNEMP`(失业率)作为协变量被用于模型中;同时,同一列数据还会通过另外两个产品最终影响到目标变量 `FEMA_NRI.risk_score`。这条数据链贯穿了整个处理流程。
在计算机科学中,这种图表被称为有向无环图,简称DAG。“有向”意味着箭头表示方向,“无环”则表示这些箭头不会形成循环结构。
在本文中,所有的箭头都表示从某种“成分”到由它构成的“产品”的对应关系。
有两个术语可以帮助我们理解图中的各种关系:
一个节点的祖先是指通过反向追踪该节点所能够到达的所有节点。在图中,ACS相关的列就是SVI这个节点的祖先。
一个节点的后代是指通过正向追踪该节点所能够到达的所有节点。SVI这个节点就是ACS相关列的后代。
因此,进行泄漏检测时,只需要遵循一条简单的规则:任何协变量都不应该与目标变量的祖先或后代产生关联。
步骤4:编写依赖关系清单
清单文件是一种用于列出所有产品以及这些产品是由哪些其他产品构成的文件。在这里,我们会使用 YAML 格式,因为这种格式便于人们阅读和编辑。
下面是一个示例产品的结构:
ACS.EP_UNEMP:
  label: 失业率
  measurementBasis: 实测数据
  derivesFrom: []
derivesFrom: []中的空列表表示该产品没有父产品,因为它直接来源于调查数据。
而下面这个例子则展示了一个由其他产品构成的产品:
FEMA_NRI.social_vulnerability:
  label: FEMA国家风险指数中的社会脆弱性指标
  measurementBasis: 综合计算结果
  derivesFrom:
    - {variable: CENSUS_CRE.social_vulnerability, relation: identity, confidence: documented}
derivesFrom列表中的每一条记录都代表了图结构中的一条边,而每条边都会包含以下三个信息:
variable字段用于表示父产品的名称,该名称必须与文件中其他地方定义的产品名称相匹配。relation字段描述了父产品是如何被用来构成当前产品的。confidence字段反映了人们对这条边所代表关系的确定程度。
以下是五种常见的关系类型:
| 关系类型 | 含义 |
|---|---|
component |
父产品是一种数学上的构成要素,比如总和中的某个数值。 |
modelled_from |
父产品是统计模型的输入数据。 |
identity |
当前产品其实就是父产品,只是使用了不同的名称重新发布而已。 |
poststratified_on |
父产品提供了用于分层分析的人口权重数据。 |
denominator |
父产品是分数的分母,比如“每人的病例数”这个指标中的分母部分。 |
以下是三种不同的置信度等级:
| 置信度等级 | 含义 |
|---|---|
certain |
计算公式已经公开发布,或者输入数据和输出结果被保存在同一个文件中。 |
documented |
相关机构在其方法论文档中明确提到了这种关联关系。 |
inferred |
相关文献强烈暗示了这种关联关系,但暂时仍被视为推测性结论。 |
置信度字段的重要性远超表面上看起来的程度。如果一份谱系图里充满了猜测性的信息,那么它反而会重新引发原本想要解决的问题;因此,每条边都应该清楚地说明其背后有哪些证据支持。
每个产品还会包含一个measurementBasis字段:
| measurementBasis | 含义 |
|---|---|
measured |
通过直接计数或调查获得的数据,比如人口普查的结果。 |
modelled |
通过统计模型或机器学习算法计算得出的结果。 |
composite |
通过固定的算术运算从其他产品中计算得出的数值。 |
这个字段记录了一些公共目录通常会忽略的信息:某个数值是通过实际统计得出的,还是通过预测计算得到的。在电子表格中,人口普查的数据和随机森林模型的预测结果看起来可能完全一样,但实际上它们属于截然不同的证据类型。
现在请创建一个名为`mini-manifest.yaml`的文件,并填写以下内容。这个文件只是完整数据清单中的其中一部分,包含了11种来自美国实际数据基础设施的产品信息;由于每个产品只保留了部分必要的数据,因此文件的体积保持得很小。
# 这是一个用于教程的小型数据清单示例。
schema: derives-from/0.2

products:

  # ---- 通过实际测量得出的数据
  ACS.EP_POV150:
    label: 生活在贫困线以下150%人口的比例
    measurementBasis: 实际测量
    derivesFrom: []

  ACS.EP_UNEMP:
    label> 失业率
    measurementBasis: 实际测量
    derivesFrom: []

  ACS.EP_NOVEH:
    label: 家庭中没有任何车辆的家庭比例
    measurementBasis: 实际测量
    derivesFrom: []

  SAT.chirps_rainfall:
    label> CHIRPS卫星测量的降雨量数据
    measurementBasis: 实际测量
    derivesFrom: []

  NVSS.mortality:
    label> 死亡证明记录
    measurementBasis: 实际测量
    derivesFrom: []

  # ---- 通过其他数据计算得出的结果
  CENSUS_CRE.social_vulnerability:
    label> 人口普查得出的社区抗灾能力评估结果,社会脆弱性指标
    measurementBasis: 建模计算
    derivesFrom:
      - {variable: ACS.EP_POV150, relation: modelled_from, confidence: documented}
      - {variable: ACS.EP_UNEMP, relation: modelled_from, confidence: documented}
      - {variable: ACS.EP_NOVEH, relation: modelled_from, confidence: documented}

  FEMA_NRI.social_vulnerability:
    label> FEMA国家风险指数得出的社会脆弱性指标
    measurementBasis: 综合计算
    derivesFrom:
      - {variable: CENSUS_CRE.social_vulnerability, relation: identity, confidence: documented}

  HVRI.bric:
    label> 社区的基础抗灾能力指标
    measurementBasis: 综合计算
    derivesFrom:
      - {variable: ACS.EP_UNEMP, relation: component, confidence: documented}
      - {variable: ACS.EP_NOVEH, relation: component, confidence: documented}

  FEMA_NRI.community_resilience:
    label> FEMA国家风险指数得出的社区抗灾能力指标
    measurementBasis: 综合计算
    derivesFrom:
      - {variable: HVRI.bric, relation: identity, confidence: documented}

  FEMA_NRI.expected_annual_loss:
    label> FEMA国家风险指数预测的年度损失金额
    measurementBasis: 建模计算
    derivesFrom: []

  FEMA_NRI.risk_score:
    label> FEMA国家风险指数的整体风险评分
    measurementBasis: 综合计算
    derivesFrom:
      - {variable: FEMA_NRI.expected_annual_loss, relation: component, confidence: certain}
      - {variable: FEMA_NRI.social_vulnerability, relation: component, confidence: certain}
      - {variable: FEMA_NRI.community_resilience, relation: component, confidence: certain}
步骤5:构建代码检查工具
代码检查工具是一种能够读取代码并在问题造成实际危害之前发出警告的工具。像Flake8这样的代码检查工具会解析源代码,而这种工具则会读取你的配置文件以及相关的变量列表。
创建一个名为mini_lint.py的文件。这个程序将由六个部分组成,最终生成的文件行数不会超过200行。
第1部分:读取YAML配置文件并拒绝重复的键值对
"""mini_lint.py: 避免使用那些位于通往目标变量的路径上且存在重复的键值对。"""
import argparse
import sys
from collections import deque
from itertools import combinations

import yaml

RANK = {"certain": 3, "documented": 2, "inferred": 1}
DETERMINISTIC = {"component", "identity", "denominator"}


def fail(message):
    """退出代码2表示配置文件或命令本身存在问题。"""
    print(message, file=sys.stderr)
    sys.exit(2)


# ---------------------------------------------------------------- 第1步
class StrictLoader(yaml.SafeLoader):
    """一个会在遇到重复键值对时停止处理的YAML加载器。"""


def refuse_duplicates(loader, node, deep=False):
    seen = {}
    for key_node, _ in node.value:
        key = loader.construct_object(key_node, deep=deep)
        line = key_node.start_mark.line + 1
        if key in seen:
            fail(f"配置文件错误:键 {key!r} 出现了两次 "
                 f"(位于行{seen[key]}和行{line}中)。")
        seen[key] = line
    return loaderconstruct_mapping(node, deep=deep)


StrictLoader.addconstructor(
    yaml.resolver.BaseResolver.DEFAULT_MAPPING_TAG, refuse_duplicates)
RANK将表示置信度的字符串转换为数字,这样该工具就能找出路径中最薄弱的环节。DETERMINISTIC列出了那些属于纯算术关系的变量对。
fail函数会打印错误信息并使程序以退出代码2结束运行。在后续的内容中,你会了解到为什么必须将退出代码2与代码1分开使用。
该工具能够处理YAML文件中的一种特殊行为:如果某个键在同一块数据中出现了两次,PyYAML会默默地保留最后一次出现的值,而忽略第一次出现的值。但在配置文件中,这种行为可能会导致某些路径被完全忽略,从而使工具认为不存在任何有效的路径,进而错误地删除某些变量。
refuse_duplicates函数会在PyYAML生成字典结构时被调用。它会遍历所有的键值对,记录下每个键对应的行号,一旦发现重复的键,就会立即停止程序的执行。
第2部分:读取产品信息及路径关系
# ---------------------------------------------------------------- 第2步
def load(path):
    try:
        with open(path) as fh:
            products = yaml.load(fh, StrictLoader)["products"]
    except (OSError, yaml.YAMLError, KeyError, TypeError) as e:
        fail(f"配置文件错误:无法读取文件 {path}:{e}")

    edges = {}
    for name, product in products.items():
        edges[name] = []
        for e in product.get("derivesFrom") or []:
            if RANK.get(e.get("confidence")) is None:
                fail(f"配置文件错误:{name}包含的路径关系的置信度为"
                     f"{e.get('confidence')!r},这是不合法的。")
            edges[name].append((e["variable"], e["relation"], e["confidence"]))
    return products, edges
load函数会使用严格的加载方式来打开文件。如果在读取过程中出现任何错误,比如路径错误或YAML格式有误,该函数就会调用fail。
随后,它会构建一个名为edges的字典。对于每个产品名称,它都会存储一个由(parent, relation, confidence)元组组成的列表。例如:
edges["FEMA_NRI.social_vulnerability"]
# [("CENSUS_CRE.social_vulnerability", "identity", "documented")]
它还会检查每一个置信度值是否属于那三个被允许的值之一。如果出现像documneted这样的拼写错误,那么这个错误很可能会被忽略,从而导致后续的排序结果出错。
第3部分:在信任数据之前先检查其内容
# ---------------------------------------------------------------- 第3步
def undefined_names(products, edges):
    mentioned = {parent for rows in edges.values() for parent, _, _ in rows}
    return sorted(mentioned - set(products))


def find_cycle(edges):
    state = {}

    def visit(node, stack):
        state[node] = "open"
        stack.append(node)
        for parent, _, _ in edges.get(node, []):
            if state.get(parent) == "open":
                return stack[stack.index(parent):] + [parent]
            if parent in state:
                continue
            cycle = visit(parent, stack)
            if cycle:
                return cycle
        stack.pop()
        state[node] = "closed"
        return None

    for node in edges:
        if node in state:
            continue
        cycle = visit(node, [])
        if cycle:
            return cycle
    return None
如果父产品名称中出现了拼写错误,比如将HVRI.brick写成HVRI.bric,那么就会生成一条指向文件中并不存在的产品的边。在这种情况下,遍历过程会在这条“死路”上停止,而之后的所有变量看起来都会是安全的。
undefined_names函数会收集所有在某条边中被提及的父产品名称,然后从这些父产品名称中减去那些已经被明确定义的产品名称。剩下的那些名称要么是拼写错误,要么就是你忘记添加的产品。
find_cycle函数用于确认这个数据结构确实是一个有向无环图。在真实数据中,一个产品不可能由自身构成;而如果存在循环结构,那么遍历程序就会永远陷入循环之中。
该函数使用了带有两个标签的深度优先搜索算法。当搜索进入某个节点时,会将该节点标记为“开放状态”;当搜索完成了对该节点上方所有节点的遍历后,会将其标记为“关闭状态”。如果搜索过程中遇到了仍然处于“开放状态”的节点,那就说明程序陷入了循环,此时函数就会返回这个循环结构,以便你能看到它。
第4部分:遍历数据图
# ---------------------------------------------------------------- 第4步
def ancestors(edges, node):
    """`node`是由哪些产品构建而成的?无论这些产品的距离有多远。”
    found = set()
    queue = deque([node])
    while queue:
        current = queue.popleft()
        for parent, relation, confidence in edges.get(current, []):
            if parent in found:
                continue
            found.add(parent)
            queue.append(parent)
    return found


def routes(edges, start, goal):
    """从`start`到`goal`的所有路径。由于第3步已经排除了循环结构,因此这些路径都是安全的。”
    found = []
    for parent, relation, confidence in edges.get(start, []):
        step = (parent, relation, confidence)
        if parent == goal:
            found.append([step])
        else:
            for rest in routes(edges, parent, goal):
                found.append([step] + rest)
    return found


def describe(start, route):
    chain = " -> ".join([start] + [parent for parent, _, _ in route])
    weakest = min(route, key=lambda step: RANK[step[2]])[2]
    arithmetic = all(rel in DETERMINISTIC for _, rel, _ in route)
    kind = "deterministic" if arithmetic else "statistical"
    return [chain, f"{kind}, 最弱环节:{weakest}"]
ancestors函数采用广度优先搜索算法,可以将其想象成售票窗口前的队列:首先将起始节点放入队列中,每次循环时,取出队列 front 的节点,查找它的父节点,并将这些尚未被访问的父节点添加到队列的后面。当队列为空时,found集合中就会包含所有距离为 0 的祖先节点。
found集合还能防止搜索过程重复访问同一个节点,这一点非常重要,因为许多节点具有相同的父节点。
ancestors能告诉你某个协变量是否属于“上游节点”,而routes则能说明它是如何形成这种关系的。
routes函数使用递归的深度优先搜索算法。对于start的每一个父节点,该函数会检查这个父节点是否就是目标节点;如果是,那么这一路径就构成了完整的路线;否则,函数会继续递归地寻找从该父节点到目标节点的所有路径,并将当前步骤添加到这些路径中。
该函数会返回所有可能的路径,这种设计是经过深思熟虑的。在我早期开发的完整工具版本中,只报告最短的路径,因此无论哪条路径的实际长度更长,只要它的证据更充分,就会被选为结果。
之所以能够安全地使用递归算法,是因为第三部分已经确认过该图结构是一个有向无环图。
describe函数会将一条路径转换成两行易于阅读的文本。第一行列出路径中所有节点的名称;第二行会说明这条路径是确定性路径(每一步都遵循算术规则)还是统计性路径(路径中至少包含一个基于统计模型的步骤),同时还会指出路径中最弱的置信度水平——因为整个路径的可靠性取决于其中最薄弱的环节。
第五部分:审计流程
审计过程会检查图结构中的三种特定模式:
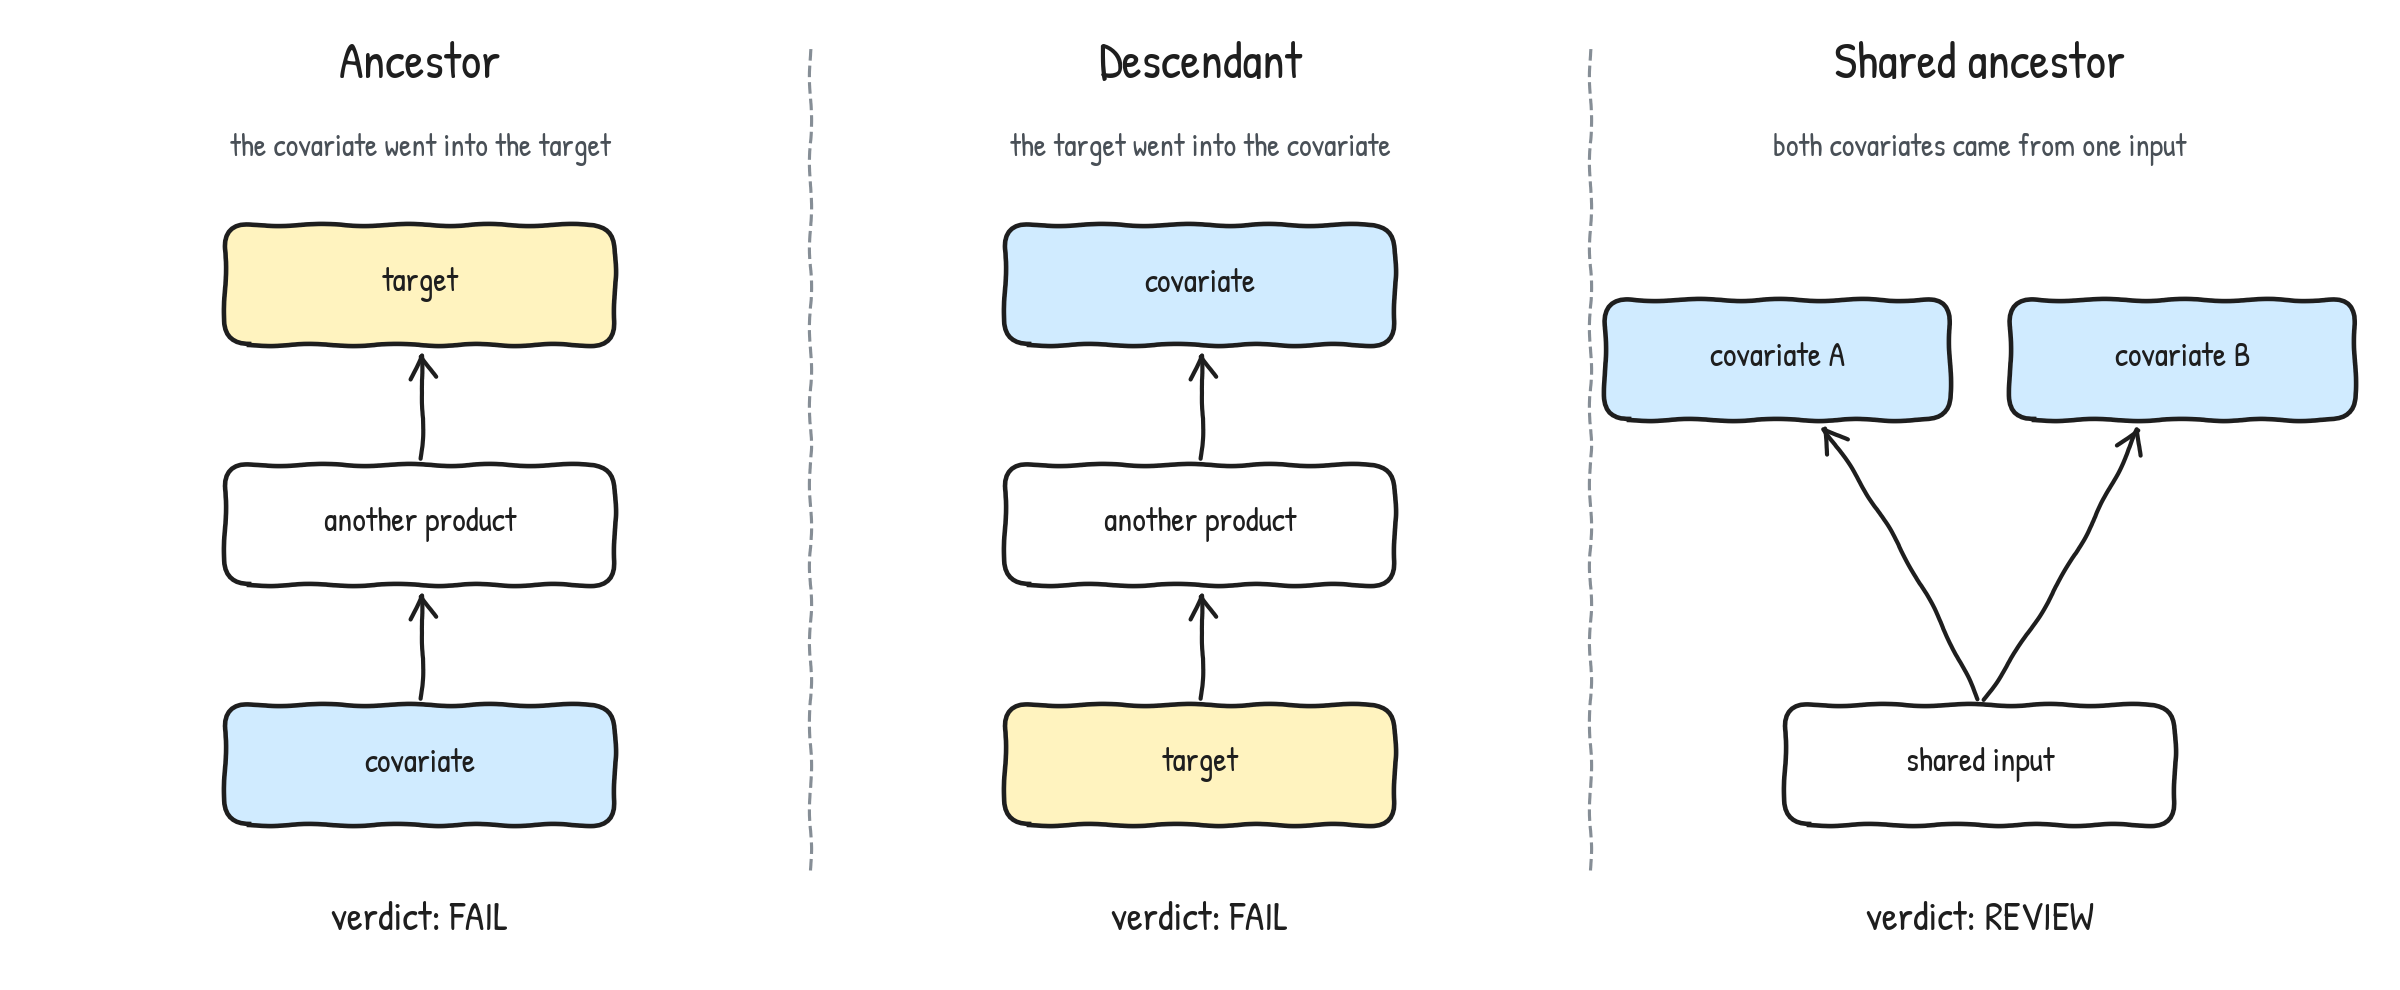
每个图表都展示了一种模式及其对应的审计结果:箭头指向目标节点表示“失败”,箭头从目标节点出发表示“失败”;而两个协变量共享同一个输入源则表示“需要进一步审核”。
‘祖先’模式:协变量直接或通过其他中间节点影响了目标变量。这是一种典型的数据泄露现象,因此工具会将其视为错误并予以报告。
‘后代’模式:目标变量影响了协变量。从子节点预测父节点同样属于数据泄露行为,因此这也被视为一种错误。
‘共同祖先’模式:两个协变量来自同一个输入源。这种情况虽然不那么严重,但因为这两个协变量会包含重复的信息,所以工具会发出警告,建议相关人员进行进一步审核。
# ---------------------------------------------------------------- 第五步
def audit(products, edges, target, covariates):
    findings = []

    unknown = [n for n in [target, *covariates] if products.get(n) is None]
    if unknown:
        return [("ERROR", f"未知名称:{n}", ["检查拼写"]])
                for n in unknown]

    target_ancestors = ancestors(edges, target)
    for cov in covariates:
        if cov in target_ancestors:
            found = routesedges, target, cov)
            details = [line for r in found for line in describe(target, r)]
            findings.append(("ERROR", f"{cov}是目标的祖先"
                                      f"(共有{len(found)}条路径)", details))

        if target in ancestors(edges, cov):
            found = routesedges, cov, target)
            details = [line for r in found for line in describe(cov, r)]
            findings.append(("ERROR", f"{cov}是目标的后代"
                                      f"(共有{len(found)}条路径)", details))

    for a, b in combinations(covariates, 2):
        if a in ancestors(edges, b) or b in ancestors(edges, a):
            findings.append(("ERROR", f"{a}和{b}:其中一个是由另一个衍生而来的", []))
        elif ancestorsedges, a) & ancestors(edges, b):
            shared = sorted(ancestors(edges, a) & ancestors(edges, b))
            findings.append(("WARN", f"{a}和{b}有共同的祖先", shared))

    return findings
审计过程首先会检查名称是否正确:如果某个协变量的名称拼写错误,工具会立即报告错误,因为对于清单之外不存在的名称,该工具根本没有任何信息,将其视为安全名称纯粹是一种猜测。
接下来,该工具会计算目标的祖先列表,并检测每个协变量是否属于这个列表;同时,它还会计算每个协变量的自身祖先列表,以确定目标是否出现在这些祖先列表中,从而发现那些是目标的后代协变量。
最后,itertools模块中的combinations函数会生成所有可能的协变量组合。如果其中一个协变量是由另一个协变量衍生而来的,那么就会报告错误;如果这两者有共同的祖先,则会发出警告。
第六部分:结论与退出代码
# ---------------------------------------------------------------- 第六步
def main():
parser = argparse.ArgumentParser()
parser.add_argument("--manifest", default="mini-manifest.yaml")
parser.add_argument("--target", required=True)
parser.add_argument("--covariates", nargs="+", required=True)
args = parser.parse_args()
products, edges = load(args.manifest)
missing = undefined_names(products, edges)
if missing:
fail(f"清单错误:存在未定义的名称:{', '.join(missing)}")
cycle = find_cycle(edges)
if cycle:
fail(f"清单错误:存在循环关系:{' -> '.join(cycle)}")
findings = audit(products, edges, args.target, args.covariates)
severities = {severity for severity, _, _ in findings}
if "ERROR" in severities:
verdict = "FAIL"
elif "WARN" in severities:
verdict = "REVIEW"
elif ancestors(edges, args.target):
verdict = "PASS"
else:
verdict = "UNTRACED"
basis = products.get(args.target, "").get("measurementBasis", "unknown")
print(f"目标 {args.target} [{basis}]")
print(f>协变量 {', '.join(args.covariates)}")
print(f>结论 {verdict}\n")
for severity, message, details in findings:
print(f> {severity:<5} {message}")
for line in details:
print(f> {line})
sys.exit(1 if verdict == "FAIL" else 0)
if __name__ == "__main__":
main()
main函数会读取命令行参数,加载配置文件,执行自我检查,然后进行审计。审计结果会被归纳为以下四种之一:
结果
出现情况
退出码
FAIL至少存在一个错误
1
REVIEW仅出现警告
0
PASS未发现任何问题,且目标对象记录了其祖先信息
0
UNTRACED未发现任何问题,且目标对象没有记录任何祖先信息
0
如果配置文件有错误或命令格式不正确,程序会以退出码2结束运行。
PASS和UNTRACED这两种结果需要进一步分析。PASS表示工具成功遍历了完整的家族树结构,并找出了所有相关的变量;而UNTRACED则表示配置文件中为该目标对象提供了空的家族树结构,因此工具根本不需要执行任何操作。将这种情况也视为“通过”结果其实是对工具的夸奖,因此才专门为它划分了这一类别。
退出码同样非常重要:退出码1表示检查过程中发现了漏洞,而退出码2则表示检查工具本身存在问题。持续集成管道必须能够区分这两种情况,因为漏洞意味着需要修改相关变量,而工具故障则意味着需要修复配置文件本身。
步骤6:在真实案例上运行代码审查工具
案例1:FEMA的风险评分系统
FEMA的综合风险评分是将“预期年度损失”乘以一个社区风险系数得出的。这个系数由社会脆弱性得分和社区韧性得分共同构成,而这两个数据都是通过不同的机构从ACS调查中获取的。
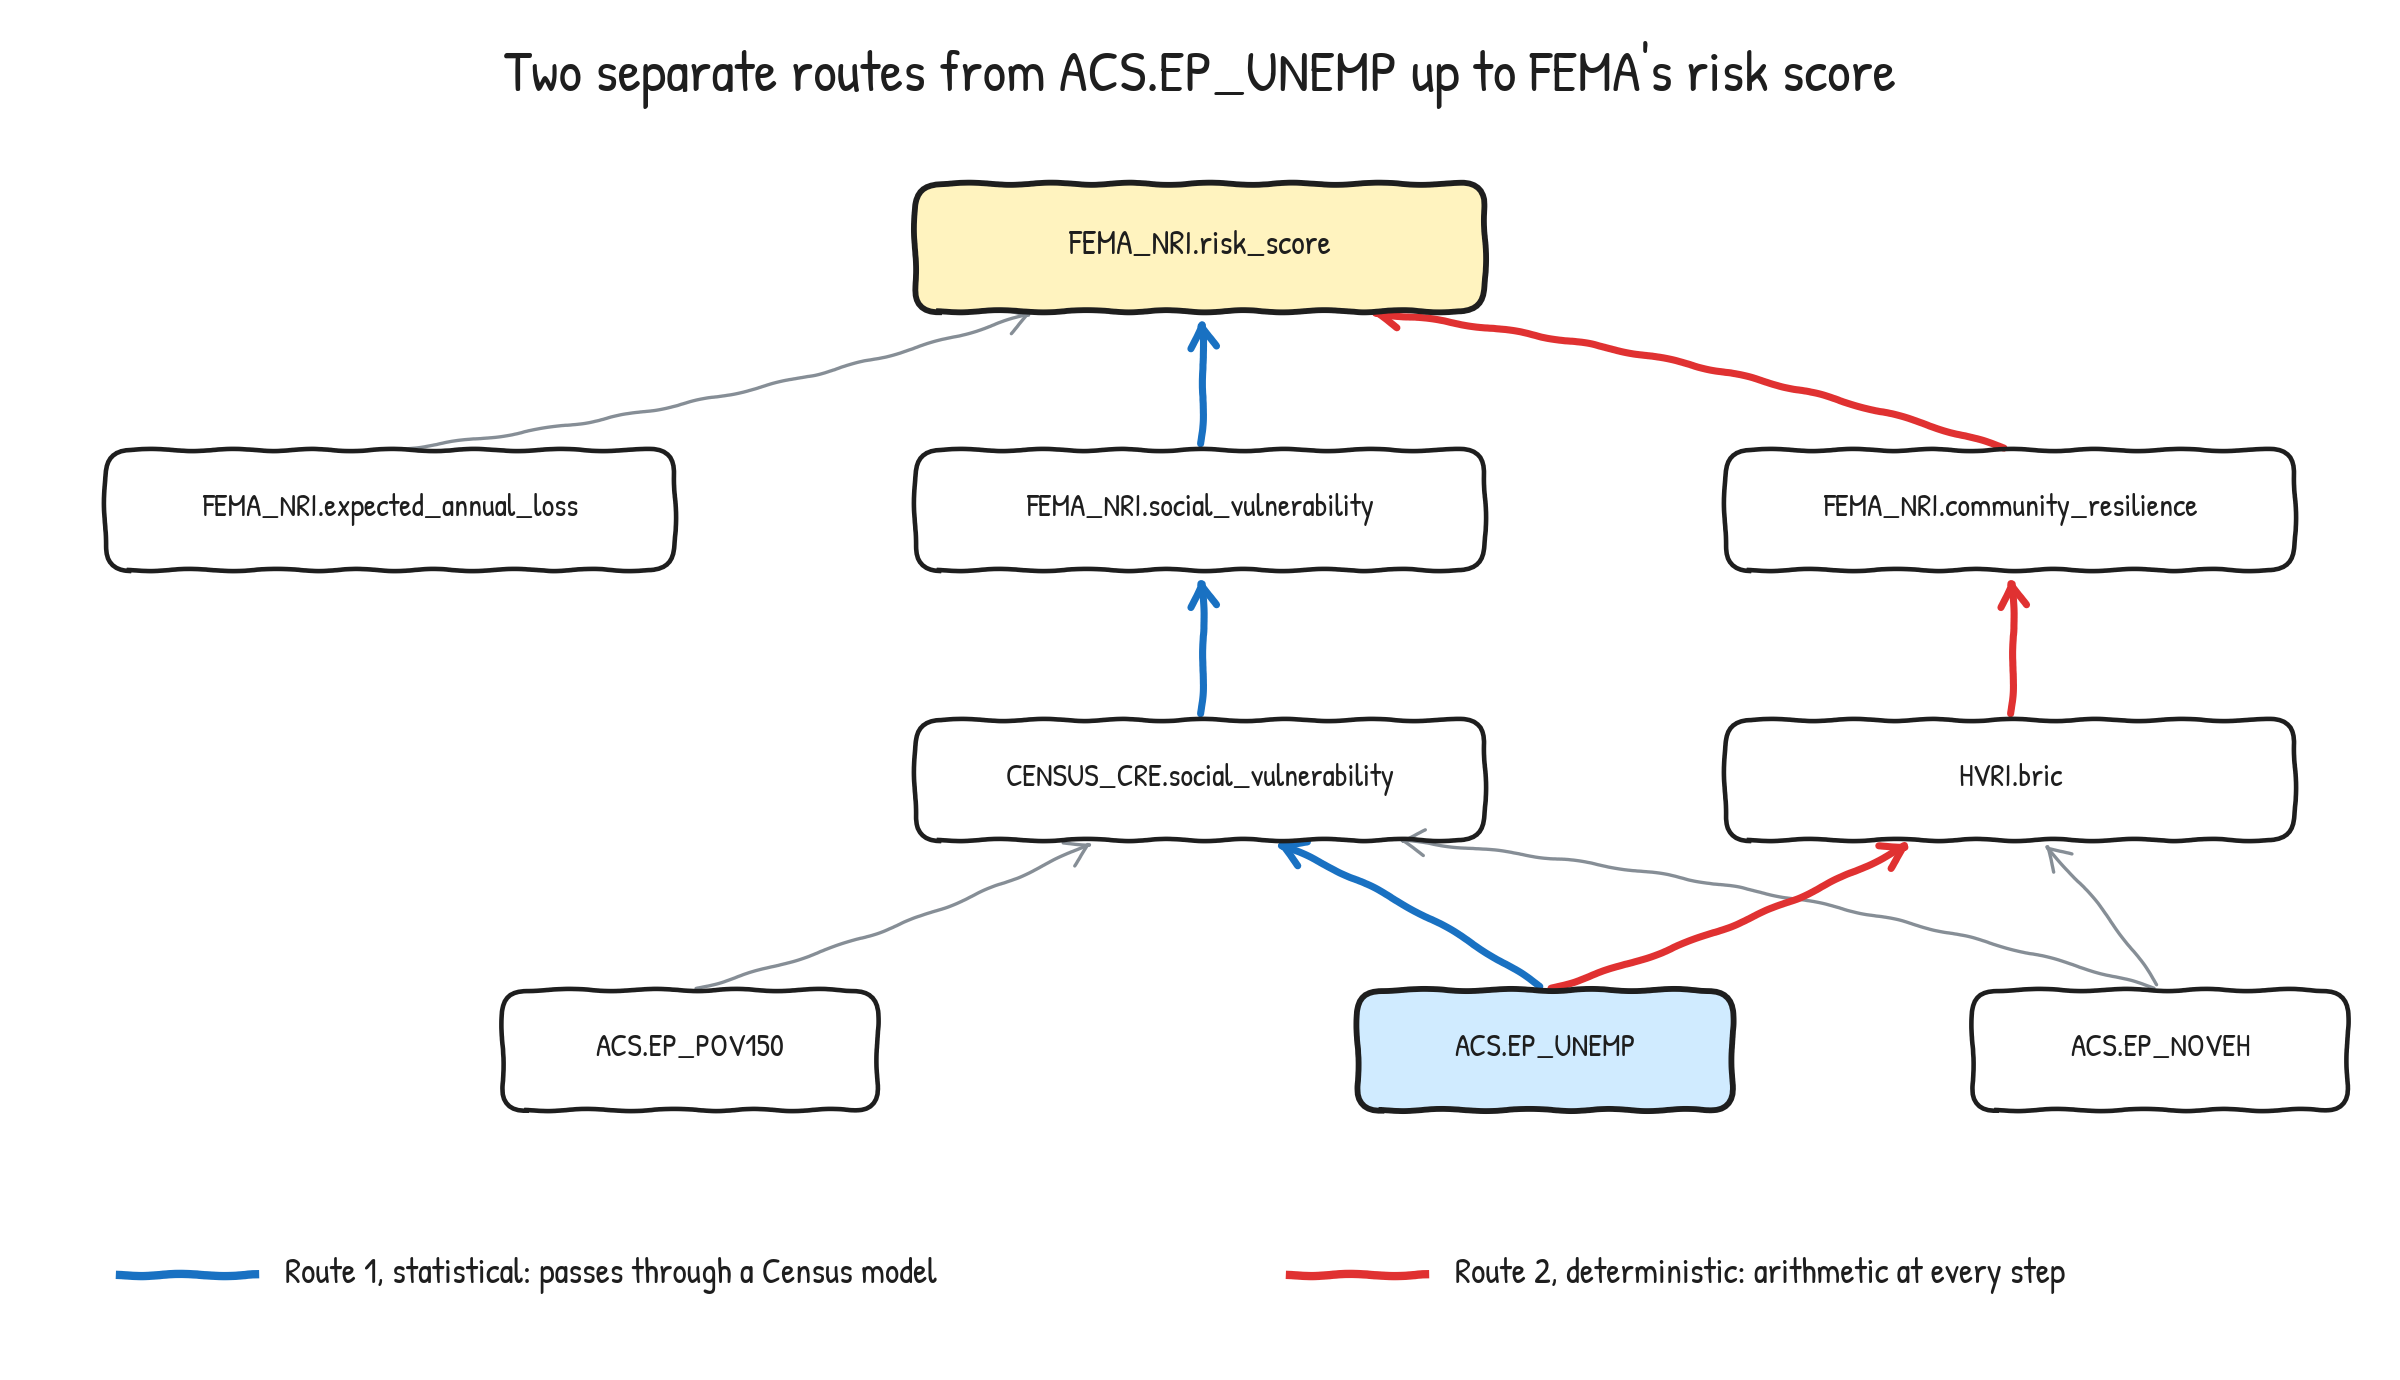
FEMA_NRI.risk_score以及构成它的所有数据。图中用蓝色和红色两条路径分别展示了这一评分的计算过程:一条路径通过人口普查局提供的韧性评估数据得出结果,另一条路径则通过HVRI的BRIC指数得出结果。
假设你想使用贫困率和失业率来预测风险评分,可以执行以下命令:
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates ACS.EP_POV150 ACS.EP_UNEMP
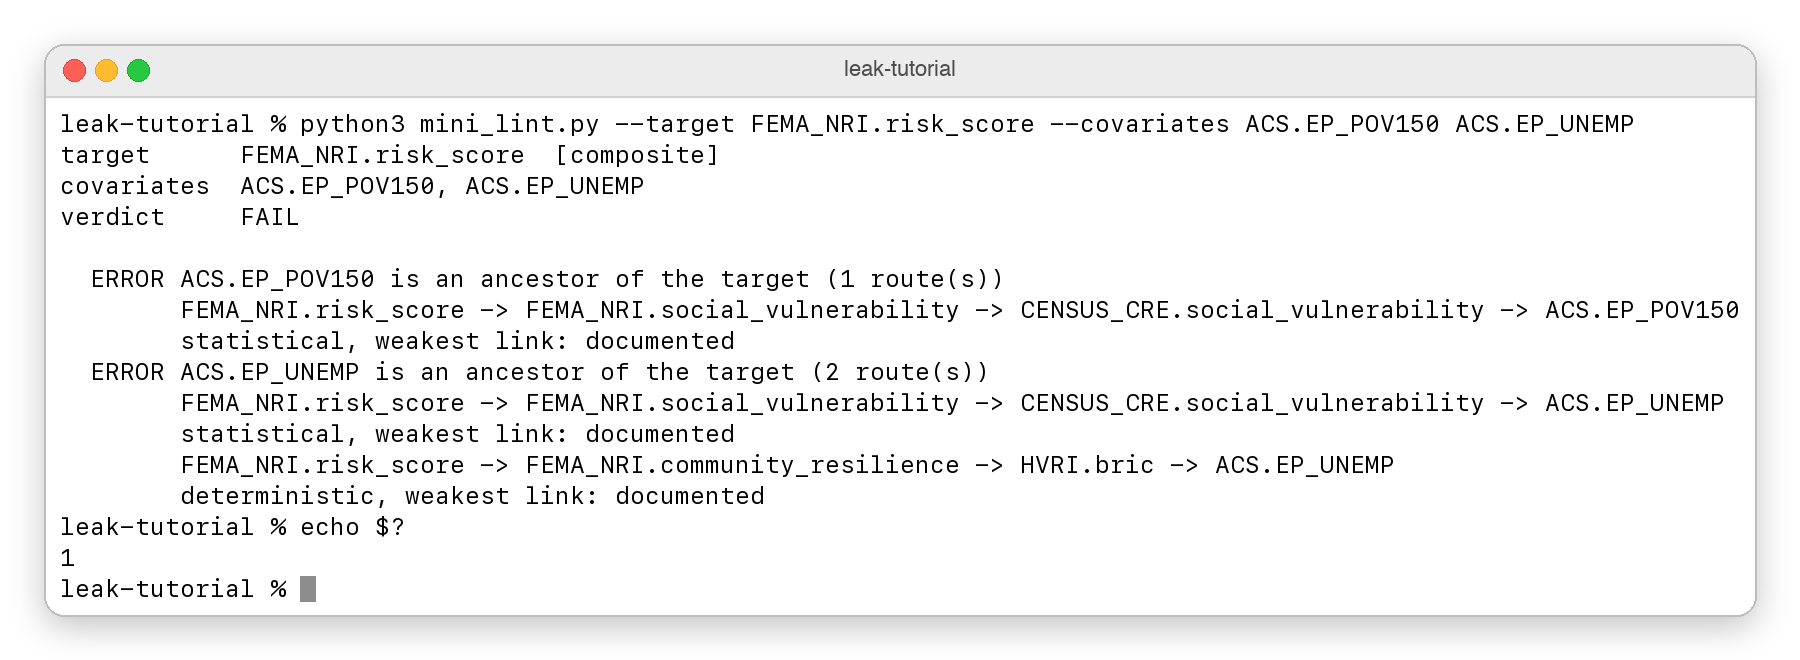
测试结果为失败。贫困率通过一种途径达到了目标值,而失业率则通过两种途径达到目标值:一种是统计分析得出的结果,另一种则是确定性分析的结果。
测试结果为失败,退出代码为1。
ACS.EP_POV150通过一种途径达到了目标值,ACS.EP_UNEMP则通过两种途径达到目标值。
第一种判断失业率的途径是通过人口普查模型进行的,因此该工具将其归类为统计分析结果;第二种途径则是通过HVRI的BRIC指数进行的,在这种指数中失业率是一个直接被考虑的因素,因此该工具将其归类为确定性分析结果。
如果你在包含列名的电子表格中手动追踪这两条路径,就会很快明白为什么使用图表会更有帮助——通过图表,可以在短短几秒钟内就找到答案。
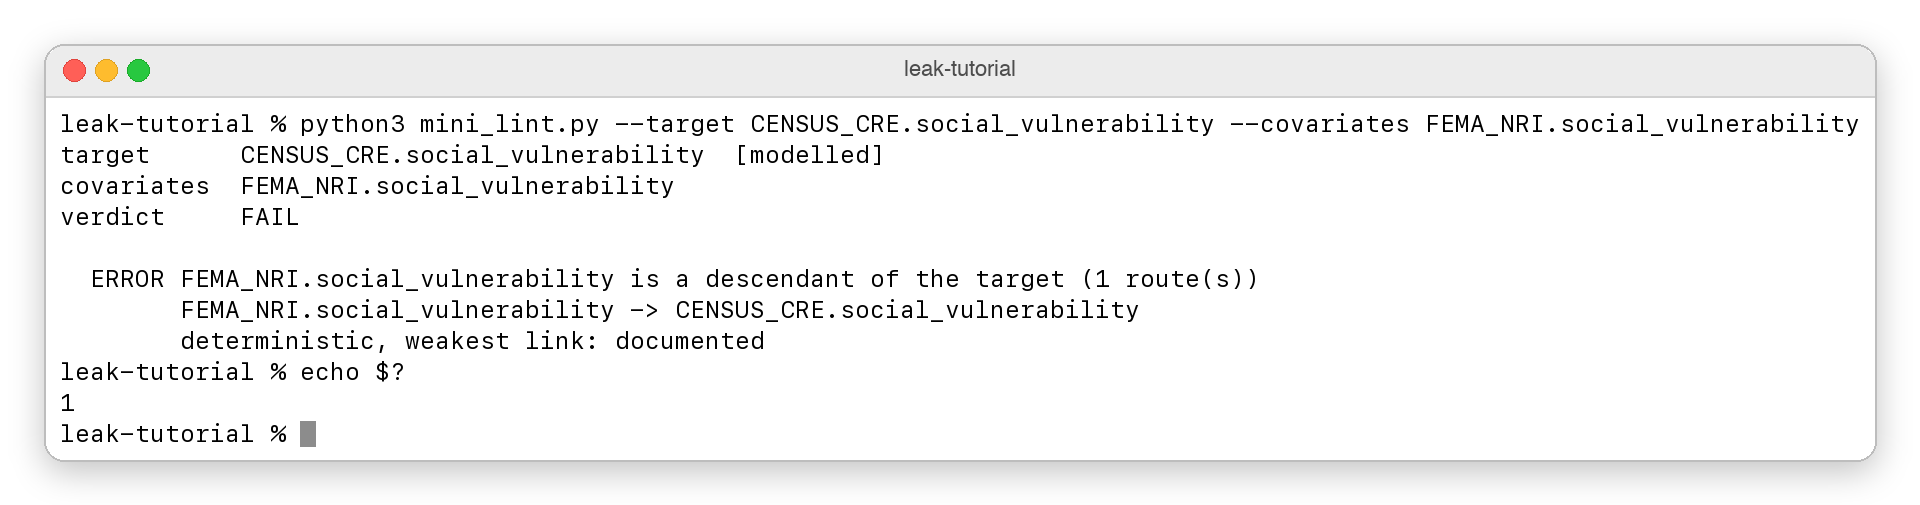
案例2:一个派生变量
现在反过来考虑,假设你想利用FEMA重新发布的人口普查数据作为协变量来预测人口普查得分:
python3 mini_lint.py --target CENSUS_CRE.social_vulnerability --covariates FEMA_NRI.social_vulnerability
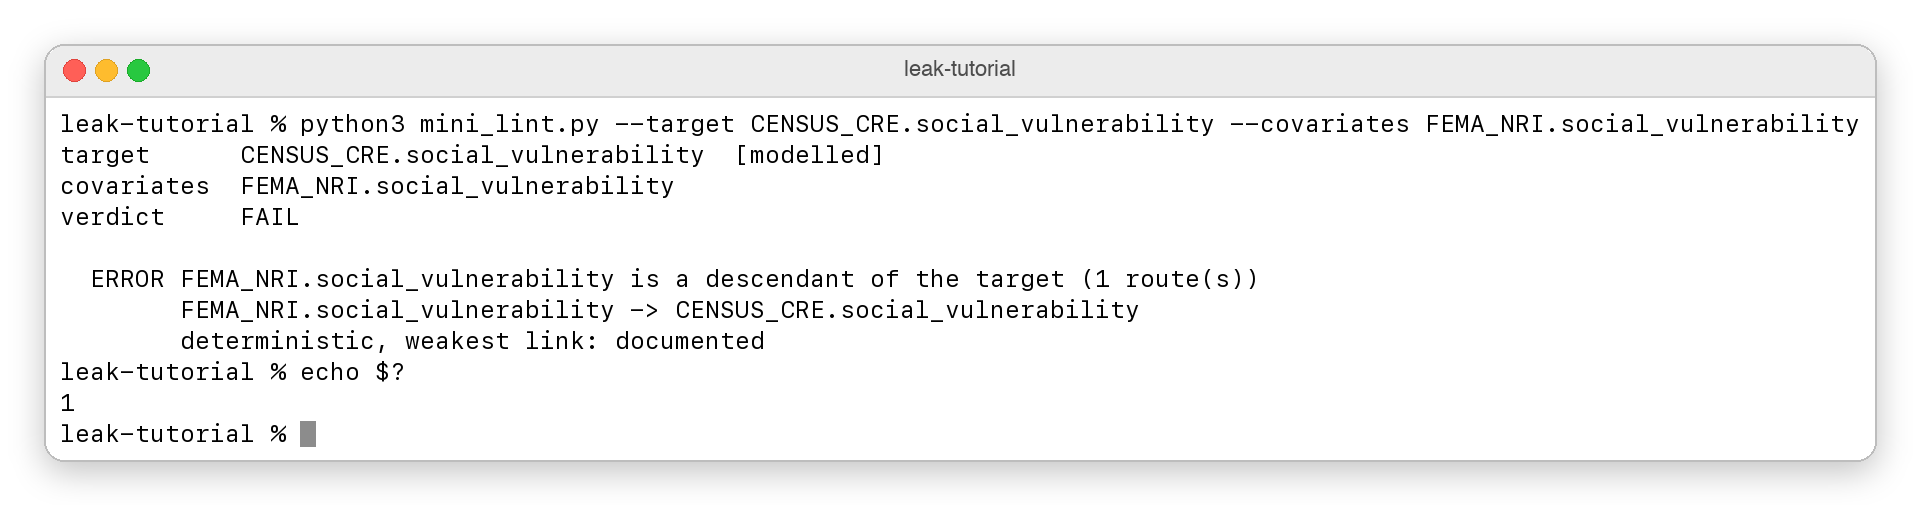
反过来测试,结果仍然是失败。FEMA重新发布的人口普查数据是通过一种确定性途径与目标变量相关联的派生变量。
FEMA提供的得分是直接根据人口普查数据计算得出的,因此将其作为输入数据会导致模型直接得到正确答案。该工具会将这种情况识别为“派生变量”的存在。
案例3:审查通过、部分路径无法追踪
以下是三次测试结果,它们应该都会显示“审查通过”或“几乎通过”:
python3 mini_lint.py --target NVSS.mortality --covariates FEMA_NRI.social_vulnerability HVRI.bric
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates SAT.chirps_rainfall
python3 mini_lint.py --target NVSS.mortality --covariates SAT.chirps_rainfall
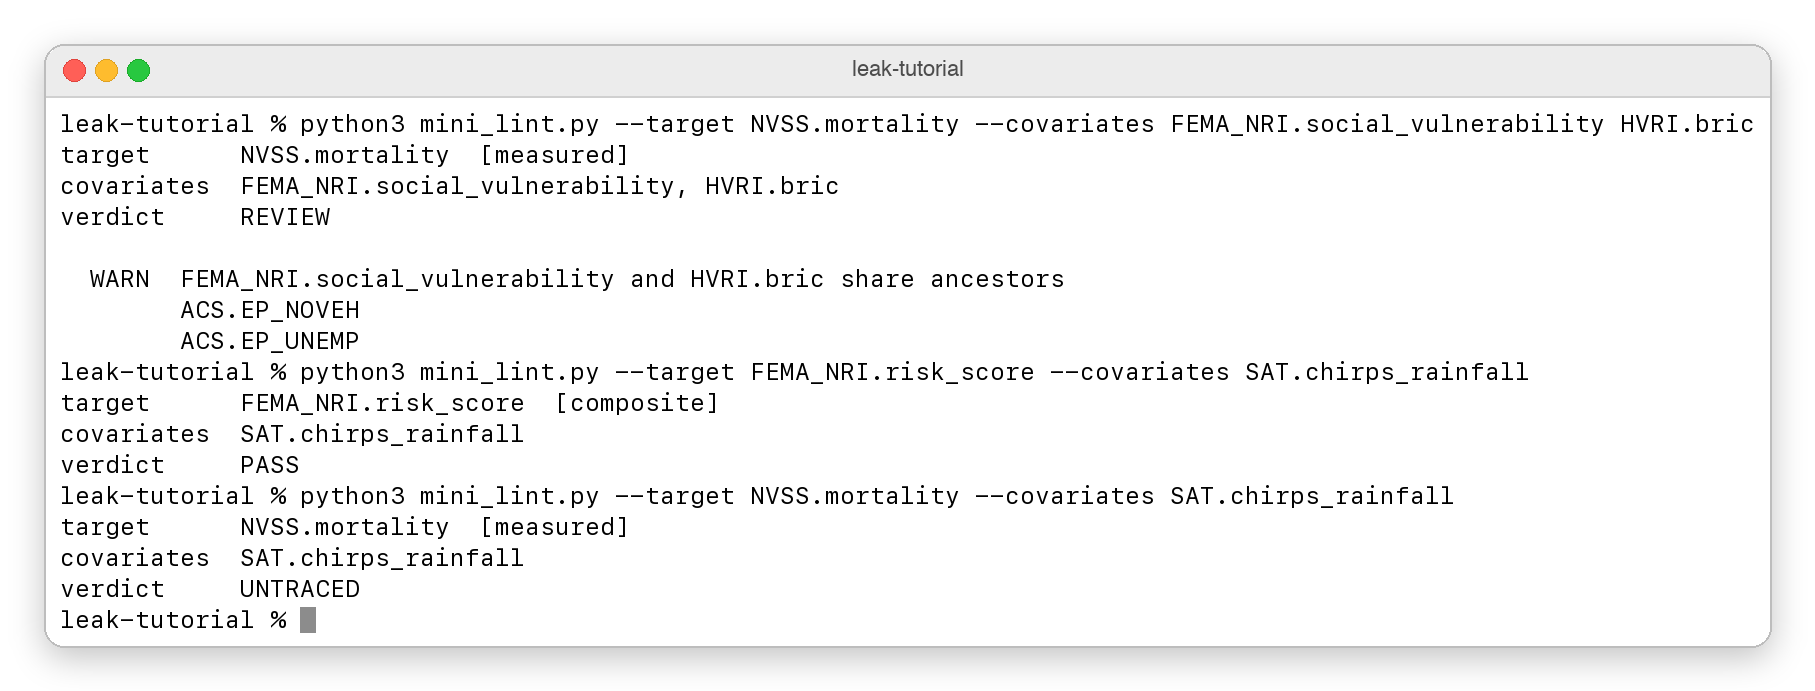
三次测试结果都很理想:对于那些有两个共同父变量的协变量对,测试结果显示“审查通过”;对于将卫星降雨数据与风险评分进行对比的情况,测试结果显示“通过”;而对于那些没有任何列出的父变量的目标变量,测试结果显示“部分路径无法追踪”。
第一次测试显示“审查通过”,因为这两个协变量有相同的两个父变量,并且它们向模型提供的信息也是重复的。
第二次测试显示“通过”,因为风险评分有一个可追踪的家族树结构,而卫星降雨数据并不属于这个结构。
第三次测试显示“部分路径无法追踪”,因为死亡证明上的数据是直接统计得出的结果,因此它没有任何列出的父变量。
这些看似微不足道的错误其实与那些明显的失败同样重要。如果一个检查工具在遇到任何输入时都会发出警报,那么它就毫无用处了;因此,一个优质的测试集必然会包含那些应该通过检测的案例。
步骤7:让检查工具在遇到错误输入时发出明显的警告
一种安全工具只有通过清晰地显示错误才能赢得人们的信任。对于漏洞检测工具来说,最糟糕的情况就是:当它悄悄地跳过了应该执行的检测步骤时,却仍然显示出“通过”的结果;而这种情况有三种常见的发生方式。
陷阱1:名称中的拼写错误
为了验证这一点,请将mini-manifest.yaml文件复制为typo-manifest.yaml,并在FEMA_NRI.community_resilience条目中将HVRI.bric修改为HVRI.brick。然后运行以下两个命令:
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates ACS.EP_POV15
python3 mini_lint.py --manifest typo-manifest.yaml --target FEMA_NRI.risk_score --covariates ACS.EP_UNEMP
两个拼写错误,导致了两种不同的退出代码:拼写错误的协变量使得检测结果为“失败”,退出代码为1;而格式错误则出现在包含该协变量的父级字段中,退出代码为2。
当协变量ACS.EP_POV15的拼写有误时,检测结果会显示为“失败”,退出代码为1;而当该协变量所在的父级字段HVRI.brick的拼写有误时,则会导致格式错误,退出代码为2。这两种情况都会在程序开始执行之前就导致整个检测过程终止。
陷阱2:YAML键重复
再创建一个名为sneaky-manifest.yaml的文件副本,在文件的末尾FEMA_NRI.risk_score块中添加一行代码:
derivesFrom: []
现在,这个风险评分字段就拥有了两个derivesFrom键。我们可以创建一个名为peek.py的脚本,来看看Python的PyYAML模块会如何处理这种情况:
import yaml
with open("sneaky-manifest.yaml") as fh:
doc = yaml.safe_load(fh)
print(doc["products"]["FEMA_NRI.risk_score"]["derivesFrom"])
先运行peek.py,然后再用同样的文件运行检查工具:
python3 peek.py
python3 mini_lint.py --manifest sneaky-manifest.yaml --target FEMA_NRI.risk_score --covariates ACS.EP_UNEMP
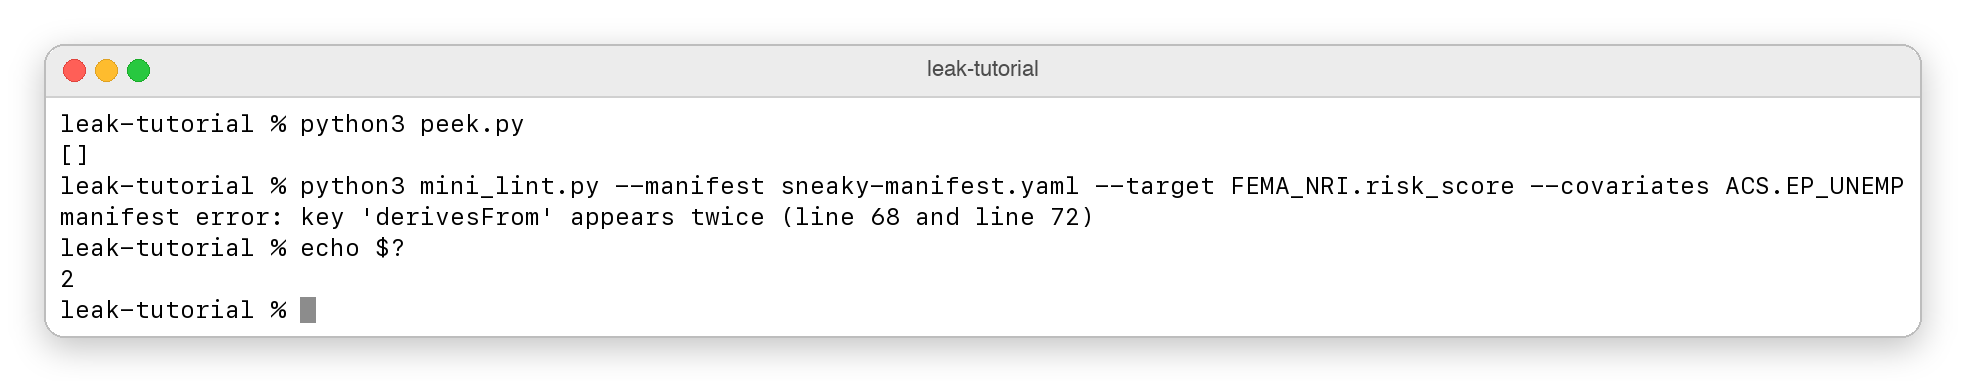
重复的键会以两种方式被处理。普通的yaml.safe_load方法会返回一个空列表且不会报错,而严格版本的加载器则会指出重复的键以及对应的行号,并以代码2退出。
普通的yaml.safe_load方法会返回一个空列表,因为PyYAML只会保留第二个键,而忽略其他两个键,因此不会发出任何警告。如果使用基于这种加载器的代码检查工具,那么它将检测不到任何问题,从而让所有存在问题的变量都被忽略掉。
严格版本的加载器会在遇到重复的键时以代码2退出,并同时指出对应的行号。
陷阱3:空白的协变量列表
这个陷阱很容易被忽视。在持续集成环境中,你可能会从某个文件或shell变量中获取协变量列表。如果该文件为空,或者变量名存在拼写错误,那么最终得到的协变量列表就会是空的。
我之前开发的工具的早期版本会接受这种情况,并输出“PASS”作为检查结果,但实际上这种检查根本没有执行任何操作。
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates
如果--covariates参数的列表为空,argparse会在执行任何操作之前就以代码2退出。
mini_lint.py nargs="+"表示--covariates参数至少需要提供一个值,而required=True则使得这个参数成为必填项。因此,如果--covariates参数的列表为空,整个脚本就会以代码2退出。
步骤8:在持续集成环境中自动执行检查
持续集成系统会在你每次推送代码时自动运行检查。这个GitHub Actions工作流会在每次推送代码或收到拉取请求时都会运行代码检查工具。请将以下配置保存为.github/workflows/lineage.yml文件,放在包含mini_lint.py和mini-manifest.yaml的仓库中:
name: lineage-check

on: [push, pull_request]

jobs:
  lint-lineage:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v5
      - uses: actions/setup-python@v6
        with:
          python-version: "3.12"
      - run: pip install pyyaml
      - name: 检查协变量是否与目标数据的结构匹配
        run: |
          python3 mini_lint.py \
            --target FEMA_NRI.risk_score \
            --covariates $(cat features.txt)
请将所有的协变量名称保存在一个名为features.txt的文件中,文件应放在仓库的根目录下,每行一个名称:
SAT.chirps_rainfall$(cat features.txt)这一部分会将那些变量名称添加到命令中;有了这个文件,作业就能顺利执行完毕,状态也会显示为绿色。但如果后来有人添加了像ACS.EP_UNEMP这样的变量,作业就会以代码1终止运行,状态也会变为红色。另外,如果有人不小心清空了features.txt文件,argparse会以代码2退出,此时作业的状态也会变成红色。| 退出代码 | 含义 | CI检测结果 |
|---|---|---|
| 0 | 检查已执行完毕,返回结果为“PASS”、“REVIEW”或“UNTRACED” | 绿色 |
| 1 | 检查发现存在漏洞 | 红色 |
| 2 | 清单文件有错误,或者命令格式不正确 | 红色 |
“REVIEW”和“UNTRACED”也会以代码0结束检测。如果你希望管道在这些情况下也停止运行,请修改main函数的最后一行代码,使得除了“PASS”之外的所有结果都使用代码1来终止检测。
配套仓库中使用了完全相同的处理流程,你可以在该仓库的“Actions”页面上查看测试结果。
步骤9:从自己的错误中学习
在构建完整的清单文件的过程中,我意识到:一个代码检查工具的效果好坏,其实取决于它所分析的数据结构。我有两次犯错了,两次的错误方向相反,而原因都是因为过于依赖文件中的数据列内容,而忽视了这些数据背后的逻辑。
错误1:SVI California文件中包含24列数据,这些数据的名称都以EP_开头,但CDC只将其中16列纳入索引统计范围。我最初编写的清单文件将这24列全部计算在内,并将EP_NOINT这一列也记录进了索引中。然而由于CDC并不将这一列计入排名范围,所以我最终删除了与该列相关的数据。
错误2:后来我又犯了另一个错误:我将那8列未被纳入排名的数据都视为“安全无关项”,直接将其包含在最终的索引文件中。其中7列实际上是关于种族和民族的信息。当我核对原始数据时,发现这7列的数据之和正好等于EP_MINRTY;而在全部9,109个数据样本中,这些数据的差异值也都是零。
EP_MINRTY是生成主题3数据所需的唯一输入参数,而主题3又会进一步影响整个索引的结果。
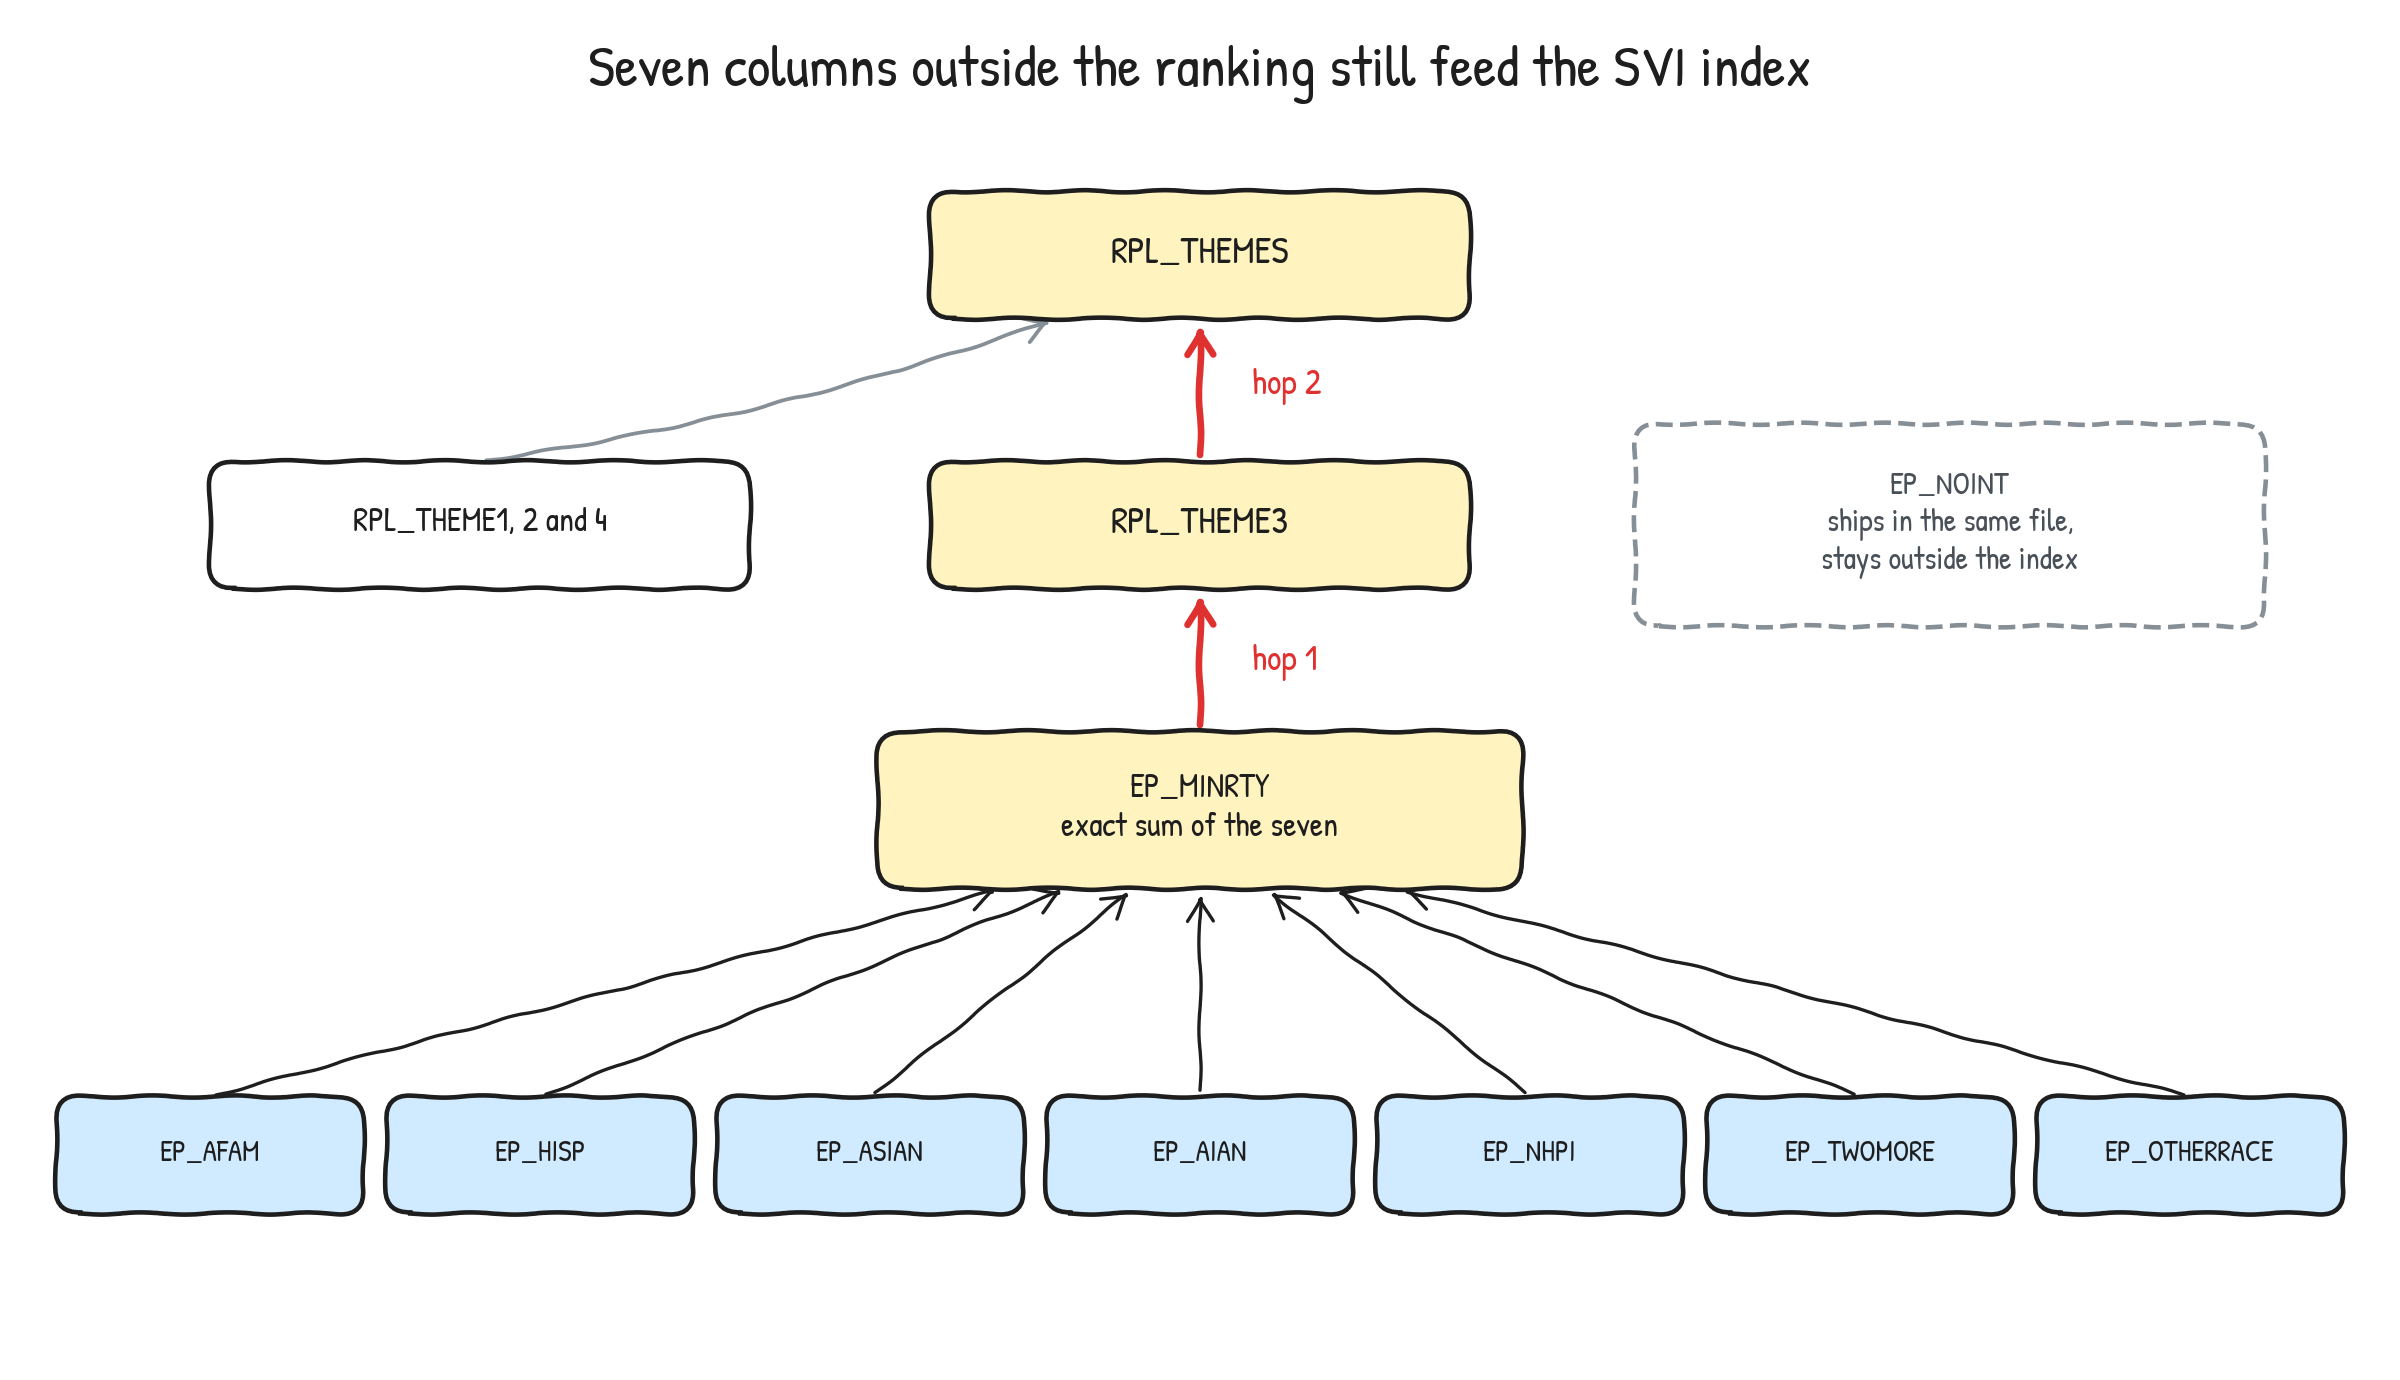
为什么这7列数据不能被视作“安全无关项”呢?因为它们的数值之和正好等于EP_MINRTY,而这个数值又是生成主题3的数据来源,进而影响整个索引的结果。而EP_NOINT这一列虽然也在文件中,但它的数值被直接忽略了。
因此,这7列数据实际上属于索引数据的组成部分,它们在数据处理流程中处于更靠前的位置。我之前使用的代码检查工具竟然将这些数据错误地认定为“安全无关项”,而这正是这种工具所要避免的情况。
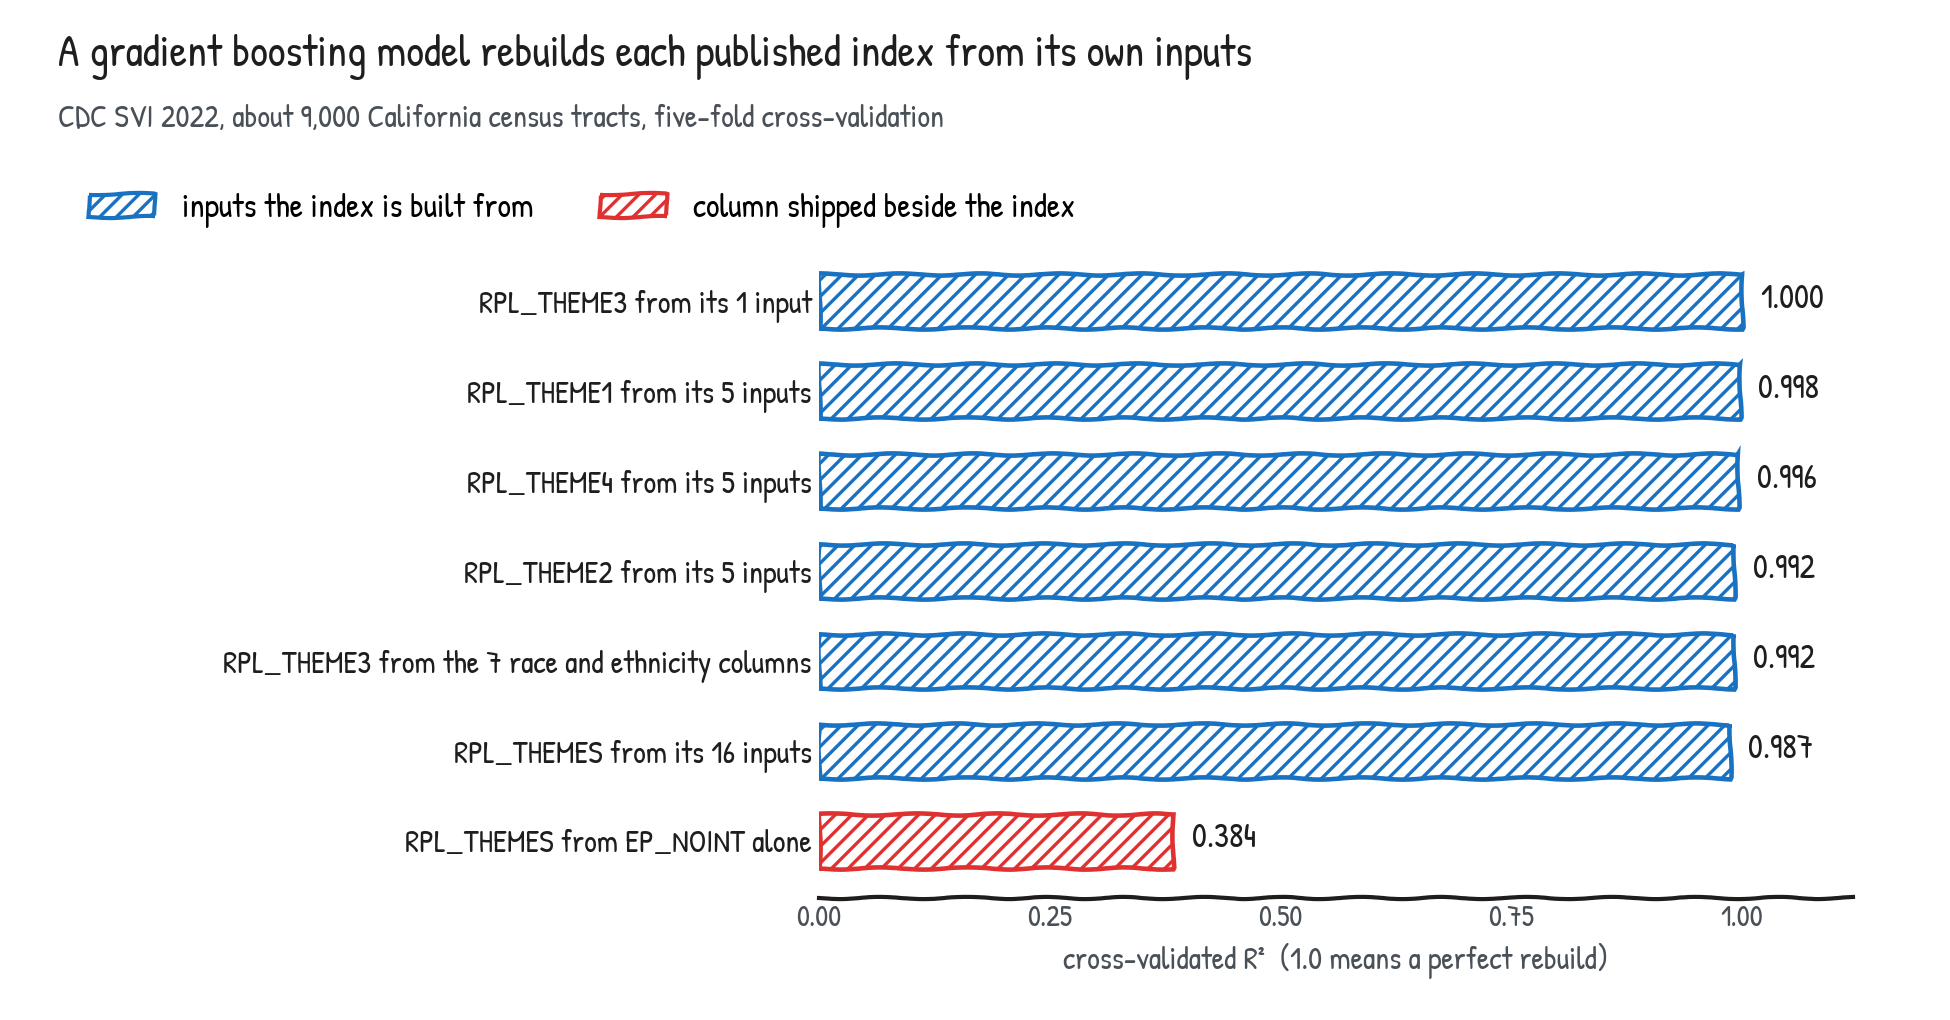
对于每种产品而言,其预测值是依据旁边列出的信息计算得出的。所有通过自身数据预测得到的产品的R²值都达到了0.987或更高,而 EP_NOINT这种仅作为索引的一部分被包含在数据文件中的字段,其R²值为0.384。
图表清晰地展示了这一差异:那七个与种族及民族相关的字段组合在一起时,能够使Theme 3的R²值达到0.992,而单独使用EP_NOINT时,其R²值仅为0.384。
现在,在将任何字段标记为“安全”之前,我会遵循更严格的规则。首先会阅读相关的方法说明,然后会在实际数据中测试这些字段之间的关系。
完整的清单中有一个名为coPublishedNonInputs的字段,用于记录那些与索引一起被保存在同一个文件中、但在计算指数时并未被使用的字段。对于SVI而言,EP_NOINT就是这个字段中唯一的条目。
使用完整工具进行更深入的分析
本教程中提到的小型检查工具已经涵盖了核心功能,而完整的项目还包括以下内容:
一个包含60种产品以及75条衍生关系的清单,这些数据涵盖了美国及全球范围内的各种信息源,包括CDC的地理数据、FEMA的国家风险指数、WorldPop数据库、AlphaEarth卫星数据,以及WFP的饥饿地图实时数据
对于每一个包含衍生关系的数据项,都会提供书面说明;如果之前的分析结果有误,还会添加
correction字段进行更正一种
--graph模式,可以打印出整个衍生关系图谱一套包含八个真实审计案例的内置工具
一个名为
reproduce_svi.py的脚本,用于将本文中提到的所有R²值与CDC的实时数据文件进行比对一个固定的Dockerfile文件,确保分析结果能够完全复现
若想尝试使用这些工具,请执行以下命令:
git clone https://github.com/Adeniyikayodee/dependency_manifest.git
cd dependency_manifest
python3 lint_lineage.py
python3 lint_lineage.py --graph
python3 reproduce_svi.py
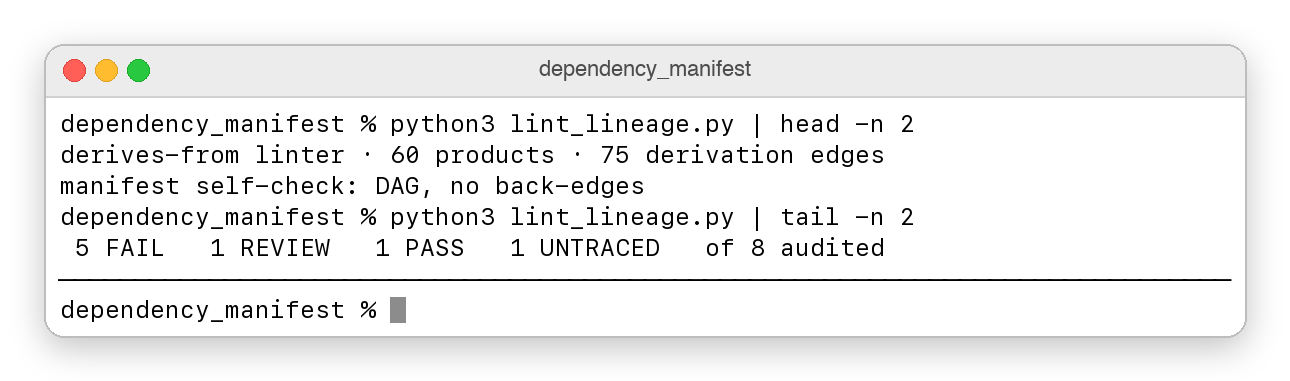
使用完整工具对这份清单进行分析后,得到了以下结果:60种产品、75条衍生关系,以及8项审计任务,其中5项失败、1项需要进一步审核、1项通过、1项无法追踪。
这份清单也清楚地说明了它的局限性。它仅涵盖了全球范围内大约400个官方综合指数中的60种产品,而且其中有4条衍生关系仍被标记为inferred(推导出的)。在对这份清单的首次审计中,发现了6处错误,其中4处出现在那些我早已标记为certain或documented的衍生关系中。
最适合编写这类记录的应该是这些数据背后的机构本身,因为它们已经以PDF格式详细描述了自己的计算方法。在公共数据架构中新增两个字段derivesFrom和measurementBasis》,可以让各个数据提供者将自己已掌握的信息记录下来。
如果你从事与公共数据相关的工作,你可以通过添加自己熟悉的产品来提供帮助,或者检查那些被标记为inferred的边及其对应的原始文档,以验证这些信息的准确性。
结论
在公共数据中,目标变量的信息往往隐藏在各机构用于构建索引的数据处理流程之中。某个模型如果能够重新发现其中的一种数据处理方式,那么它的评分可能会接近满分,但这样的评分其实并不能真实反映现实世界的情况。
通过本教程,你将:
利用CDC提供的5个输入字段,重新构建了一个R²值为0.998的主题分析模型
区分了数据的来源信息与其计算过程
编写了一份YAML格式的文档,用于记录各种数据推导关系及其置信度
开发了一个代码检查工具,该工具使用广度优先搜索来查找数据的来源节点,同时使用深度优先搜索来列出所有数据推导路径
让这个检查工具在遇到拼写错误、重复的YAML键值对、循环结构或空协变量列表等情况时能够及时发出警告
将这个检查脚本集成到了GitHub Actions中,并确保它能够返回清晰的退出代码
在相信公共数据上的高评分之前,先问问自己:这个评分是基于什么数据计算得出的。一旦你得到了答案,那么只需编写几行Python代码,就可以在每次训练模型时验证这一答案是否正确。
本教程中的所有代码都存储在derives-from-tutorial这个仓库中。而完整的工具、文档以及复现脚本则可以在主仓库dependency_manifest中找到。该项目还被存档在Zenodo平台上,其DOI编号为10.5281/zenodo.22274757,你可以根据CC0许可协议自由使用这些资源。
参考资料
CDC/ATSDR社会脆弱性指数:https://svi.cdc.gov/
FEMA国家风险指数技术文档v1.20版,2025年12月发布:https://www.fema.gov/sites/default/files/documents/fema_national-risk-index_technical-documentation.pdf
美国人口普查局发布的社区韧性评估数据:https://www.census.gov/programs-surveys/community-resilience-estimates.html
CDC制定的PLACES方法论,用于预防慢性疾病,2022年发布:https://www.cdc.gov/pcd/issues/2022/21_0459.htm
Data Commons的数据模型:https://docs.datacommons.org/data_model.html
相关文章
如何编写能够真正被编译成功的Linux内核模块
Linux中的 内核模块 是一段较小的代码,可以在不重新构建整个内核的情况下被加载到正在运行的内核中。 这听起来很简单,但实际上,即使是最简单的模块也会产生大量相关的文件和数据:对象文件、元数据、导出的符号以及未解析的符号,最后还会生成一个与普通可执行文件截然不同的 .ko 文件。 下面是一个完整的、可以正常工作的Linux内核模块。它的代码仅有22行,其中7行是包含头文件和元数据: #include #include #include MODULE LICENSE("GPL"); MODULE AUTHOR("Chris Roy"); MODULE DESCRIPTION("一个最小的可加载
阅读全文
什么是代理框架?Claude Code、DeepSeek Harness以及Hermes Agent背后的架构原理是什么
2026年8月13日,DeepSeek在GitHub上发布了一个名为 deepseek-harness 的仓库。仅仅两天后,这个仓库就获得了95,386个星标和8,826次分支请求——这一数字本身虽然算不上什么具有实际意义的指标,但如此迅速的增长速度显然说明其成功并非偶然。在2026年,这款开发工具在GitHub上的增长速度堪称最快的之一(例如 Flowtivity 和 deepseek-ai/deepseek-harness )。 九个月前,一位名叫Mario Zechner的奥地利工程师发布了一个完全相反的产品:一款名为Pi的编程辅助工具,它仅配备了四项内置功能,除此之外几乎没有其他附加组
阅读全文
如何构建一个具备自我评估功能的人工智能系统:为大型语言模型应用开发自动化测试与评估流程
你将自己的AI功能部署出去,演示效果也确实不错,团队成员们都感到非常满意。然而,当有用户提出一些超出测试范围的问题时,模型却会给出完全错误的回答。 使用大型语言模型进行开发的现实是:传统的软件测试方法根本行不通。当你的系统每次运行都会生成不同的输出结果时,你根本无法使用“output == expected”这样的简单判断语句来进行测试。 大多数教程都会教你如何构建聊天机器人或设置RAG评估流程,但之后就戛然而止了。它们只会告诉你“将其部署到生产环境中”,仿佛最困难的部分已经结束了。但实际上,真正关键的是要判断你的AI模型是否真的有效,以及在它性能下降时及时发现这个问题。 在这篇文章中,我会带
阅读全文
如何使用 Vercel AI SDK 与 Shadcn/ui 来构建人工智能聊天应用程序界面
如今,你打开的每一款AI产品几乎都具有相同的界面结构:消息列表、底部的文本输入框,以及以单个词元形式逐条显示的信息。这种设计看起来很简单,但实际上要将其构建得完善却并非易事。 你必须处理诸如数据流状态管理、部分词元的处理、工具调用、重试机制、Markdown格式的渲染、滚动位置的设置,以及其他众多细节问题……同时还要确保界面易于使用且运行速度足够快。如果使用不合适的工具来开发这些功能,你将会花费大量时间去修复各种技术问题,而根本无暇专注于产品的核心功能建设。 在本教程中,你将使用两款专为彼此设计的工具来构建一个真正的AI聊天界面:Vercel AI SDK用于处理数据流逻辑和模型运算,而sha
阅读全文