
如何编写能够真正被编译成功的Linux内核模块
Linux中的 内核模块 是一段较小的代码,可以在不重新构建整个内核的情况下被加载到正在运行的内核中。 这听起来很简单,但实际上,即使是最简单的模块也会产生大量相关的文件和数据:对象文件、元数据、导出的符号以及未解析的符号,最后还会生成一个与普通可执行文件截然不同的 .ko 文件。 下面是一个完整的、可以正常工作的Linux内核模块。它的代码仅有22行,其中7行是包含头文件和元数据: #include #include #include MODULE LICENSE("GPL"); MODULE AUTHOR("Chris Roy"); MODULE DESCRIPTION("一个最小的可加载
Linux中的内核模块是一段较小的代码,可以在不重新构建整个内核的情况下被加载到正在运行的内核中。
这听起来很简单,但实际上,即使是最简单的模块也会产生大量相关的文件和数据:对象文件、元数据、导出的符号以及未解析的符号,最后还会生成一个与普通可执行文件截然不同的.ko文件。
下面是一个完整的、可以正常工作的Linux内核模块。它的代码仅有22行,其中7行是包含头文件和元数据:
#include
#include
#include

MODULE LICENSE("GPL");
MODULE AUTHOR("Chris Roy");
MODULE DESCRIPTION("一个最小的可加载内核模块");
MODULE_VERSION("0.1");

static int __init hello_init(void)
{
    pr_info("hello: 模块已加载,地址为 %pS\n", hello_init);
    return 0;
}

static void __exit hello_exit(void)
{
    pr_info("hello: 模块已卸载\n");
}

module_init(hello_init);
module_exit(hello_exit);
在我编写这段代码的机器上编译后,生成的文件大小约为106,000字节;如果去除调试信息,同一个模块的大小就会变为4,864字节。也就是说,在最终生成的文件中,有95%的内容其实并不是真正的代码。
你生成的模块文件大小可能与我的不同,而且这种差异通常是不可预测的。造成这种差异的原因包括编译环境的不同:调试信息会记录编译所使用的目录路径,因此路径如果比较复杂,文件大小就会增加;编译器的版本以及内核配置也会影响最终文件的大小。不过,这些因素所造成的差异通常都处于一个相似的范围内。
了解这些差异是很重要的,因为大多数关于内核模块的学习教程都会给出上面这样的代码示例,然后告诉读者运行make命令即可完成编译过程,而并不会进一步解释编译过程中实际发生了什么。
本文则会详细分析实际的编译过程,说明在编写任何有用的代码之前,你的模块已经依赖于哪些其他组件,同时也解释了为什么2014年发布的那些教程现在已经无法正常使用了。
目录
您所需要的东西
要完成接下来的操作,您需要一台可以用来加载代码的Linux机器、正在使用的内核对应的头文件,以及一个编译器。
在Debian或Ubuntu系统中:
sudo apt install build-essential linux-headers-$(uname -r)
在Fedora系统中,需要安装kernel-devel和kernel-headers包;在Arch系统中,则需要安装与您的内核版本相匹配的linux-headers包。
请确认这些头文件已被安装到了预期的位置:
ls -d /lib/modules/$(uname -r)/build
该路径实际上是一个指向头文件包的符号链接。如果这个路径不存在,那么模块构建很可能会失败,而且错误信息中也不会提到与头文件相关的问题。
即使模块已经成功构建,也有可能无法将其加载到系统中。Secure Boot会拒绝未签名的模块,而内核的锁定机制也会阻止在保密模式下加载模块。请检查这两项设置:
mokutil --sb-state
cat /sys/kernel/security/lockdown
在我的机器上,Secure Boot是处于禁用状态的,而锁定机制显示的值为[none] integrity confidentiality,方括号内的内容表示当前处于哪种模式。如果您的系统中Secure Boot是启用的,那么您需要为该模块签名,或者先在固件中禁用Secure Boot,才能成功加载模块。
我使用的是Ubuntu 22.04系统,内核版本为5.15.0-190-generic,编译器版本为gcc 11.4。您的系统配置可能会有所不同,文章中也说明了在哪些情况下这些配置会起到关键作用。
最简单的可运行模块
将本文开头的代码保存为hello.c文件。下面是这段代码的内容,供您参考:
#include
#include
#include

MODULE LICENSE("GPL");
MODULE AUTHOR("Chris Roy");
MODULE_DESCRIPTION("一个最简单的可加载内核模块");
MODULE_VERSION("0.1");

static int __init hello_init(void)
{
    pr_info("hello: 模块已加载,地址为 %pS\n", hello_init);
    return 0;
}

static void __exit hello_exit(void)
{
    pr_info("hello: 模块已卸载\n");
}

module_init(hello_init);
module_exit(hello_exit);
其中有四部分代码起到了实际的作用。
module_init和module_exit用于注册内核在模块加载或卸载时需要调用的函数。它们并不是模块的“主入口点”——模块并没有一个会执行完毕后返回结果的单一入口点。模块会在两种特定事件发生时被调用,而在这些事件发生之前,模块本身不会执行任何操作,除非有其他代码主动调用它。
__init和__exit实际上是用于标识代码段的标签。__init告诉内核这段代码只会执行一次,执行完毕后其占用的内存可以被释放,因此您会在启动日志中看到“释放未使用的内核内存”这样的信息。__exit则告诉编译器:只有当该模块可以被卸载时,才需要执行__exit函数。MODULE_LICENSE("GPL") 这条指令并非仅仅是形式上的手续而已。内核在加载模块时会检查这条指令;如果某个模块声明了自己使用的是非GPL许可证,那么该模块将无法访问那些被标记为 EXPORT_SYMBOL_GPL 的符号,而这些符号恰恰是系统中最重要、最值得使用的符号。如果完全忽略这条宏,内核会自行“污染”自身的代码结构,并会记录相应的错误信息。
pr_info实际上是printk(KERN_INFO ...)的现代写法。它会将输出内容写入内核的环形缓冲区,而不是你的终端屏幕上,因此初次使用这个函数时,几乎所有人都会遇到困惑。
MODULE AUTHOR、MODULE_DESCRIPTION和MODULE_VERSION这些宏属于元数据,而非与程序行为直接相关的部分;它们会被保存在文件中,以便modinfo工具能够读取。即使不填写这些内容,程序也不会出错,但最新的内核版本会在编译时提示缺少MODULE_DESCRIPTION这一元数据,因此从一开始就建议填写这三项内容。
Makefile的实际运作方式可能比你想象的要复杂
obj-m += hello.o

all:
	make -C /lib/modules/$(shell uname -r)/build M=$(PWD) modules

clean:
(make -C /lib/modules/$(shell uname -r)/build M=$(PWD) clean
这段代码看起来像是一个Makefile,但实际上并非如此。obj-m += hello.o这一行并不是你自定义的Make变量,而是内核自带的构建系统kbuild所识别的指令。
make -C这条命令会将当前目录切换到内核头文件所在的路径,并在那里运行内核的构建系统;同时,M=$(PWD)这个参数用于告诉构建系统“模块源代码位于该目录下”。你的Makefile实际上只是一个外壳程序,它将构建任务交给了这个你无法自行修改的内核构建系统来执行。
正是这种间接调用机制导致了模块构建过程中出现一些看似与你的代码无关的问题。你在编译模块时使用的是内核的头文件,而不是普通的libc头文件;实际上,你是在使用内核自身的构建规则和参数来处理你的模块文件的。
构建过程究竟完成了什么
运行make命令后,请仔细阅读其输出结果,而不要直接跳过这些信息:
make -C /lib/modules/5.15.0-190-generic/build M=/home/chris/lkm modules
make[1]: 进入目录 '/usr/src/linux-headers-5.15.0-190-generic'
  CC [M]  /home/chris/lkm/hello.o
  MODPOST /home/chris/lkm/Module.symvers
  CC [M]  /home/chris/lkm/hello.mod.o
  LD [M]  /home/chris/lkm/hello.ko
  BTF [M] /home/chris/lkm/hello.ko
由于无法找到vmlinux文件,因此跳过了对/home/chris/lkm/hello.ko的BTF生成步骤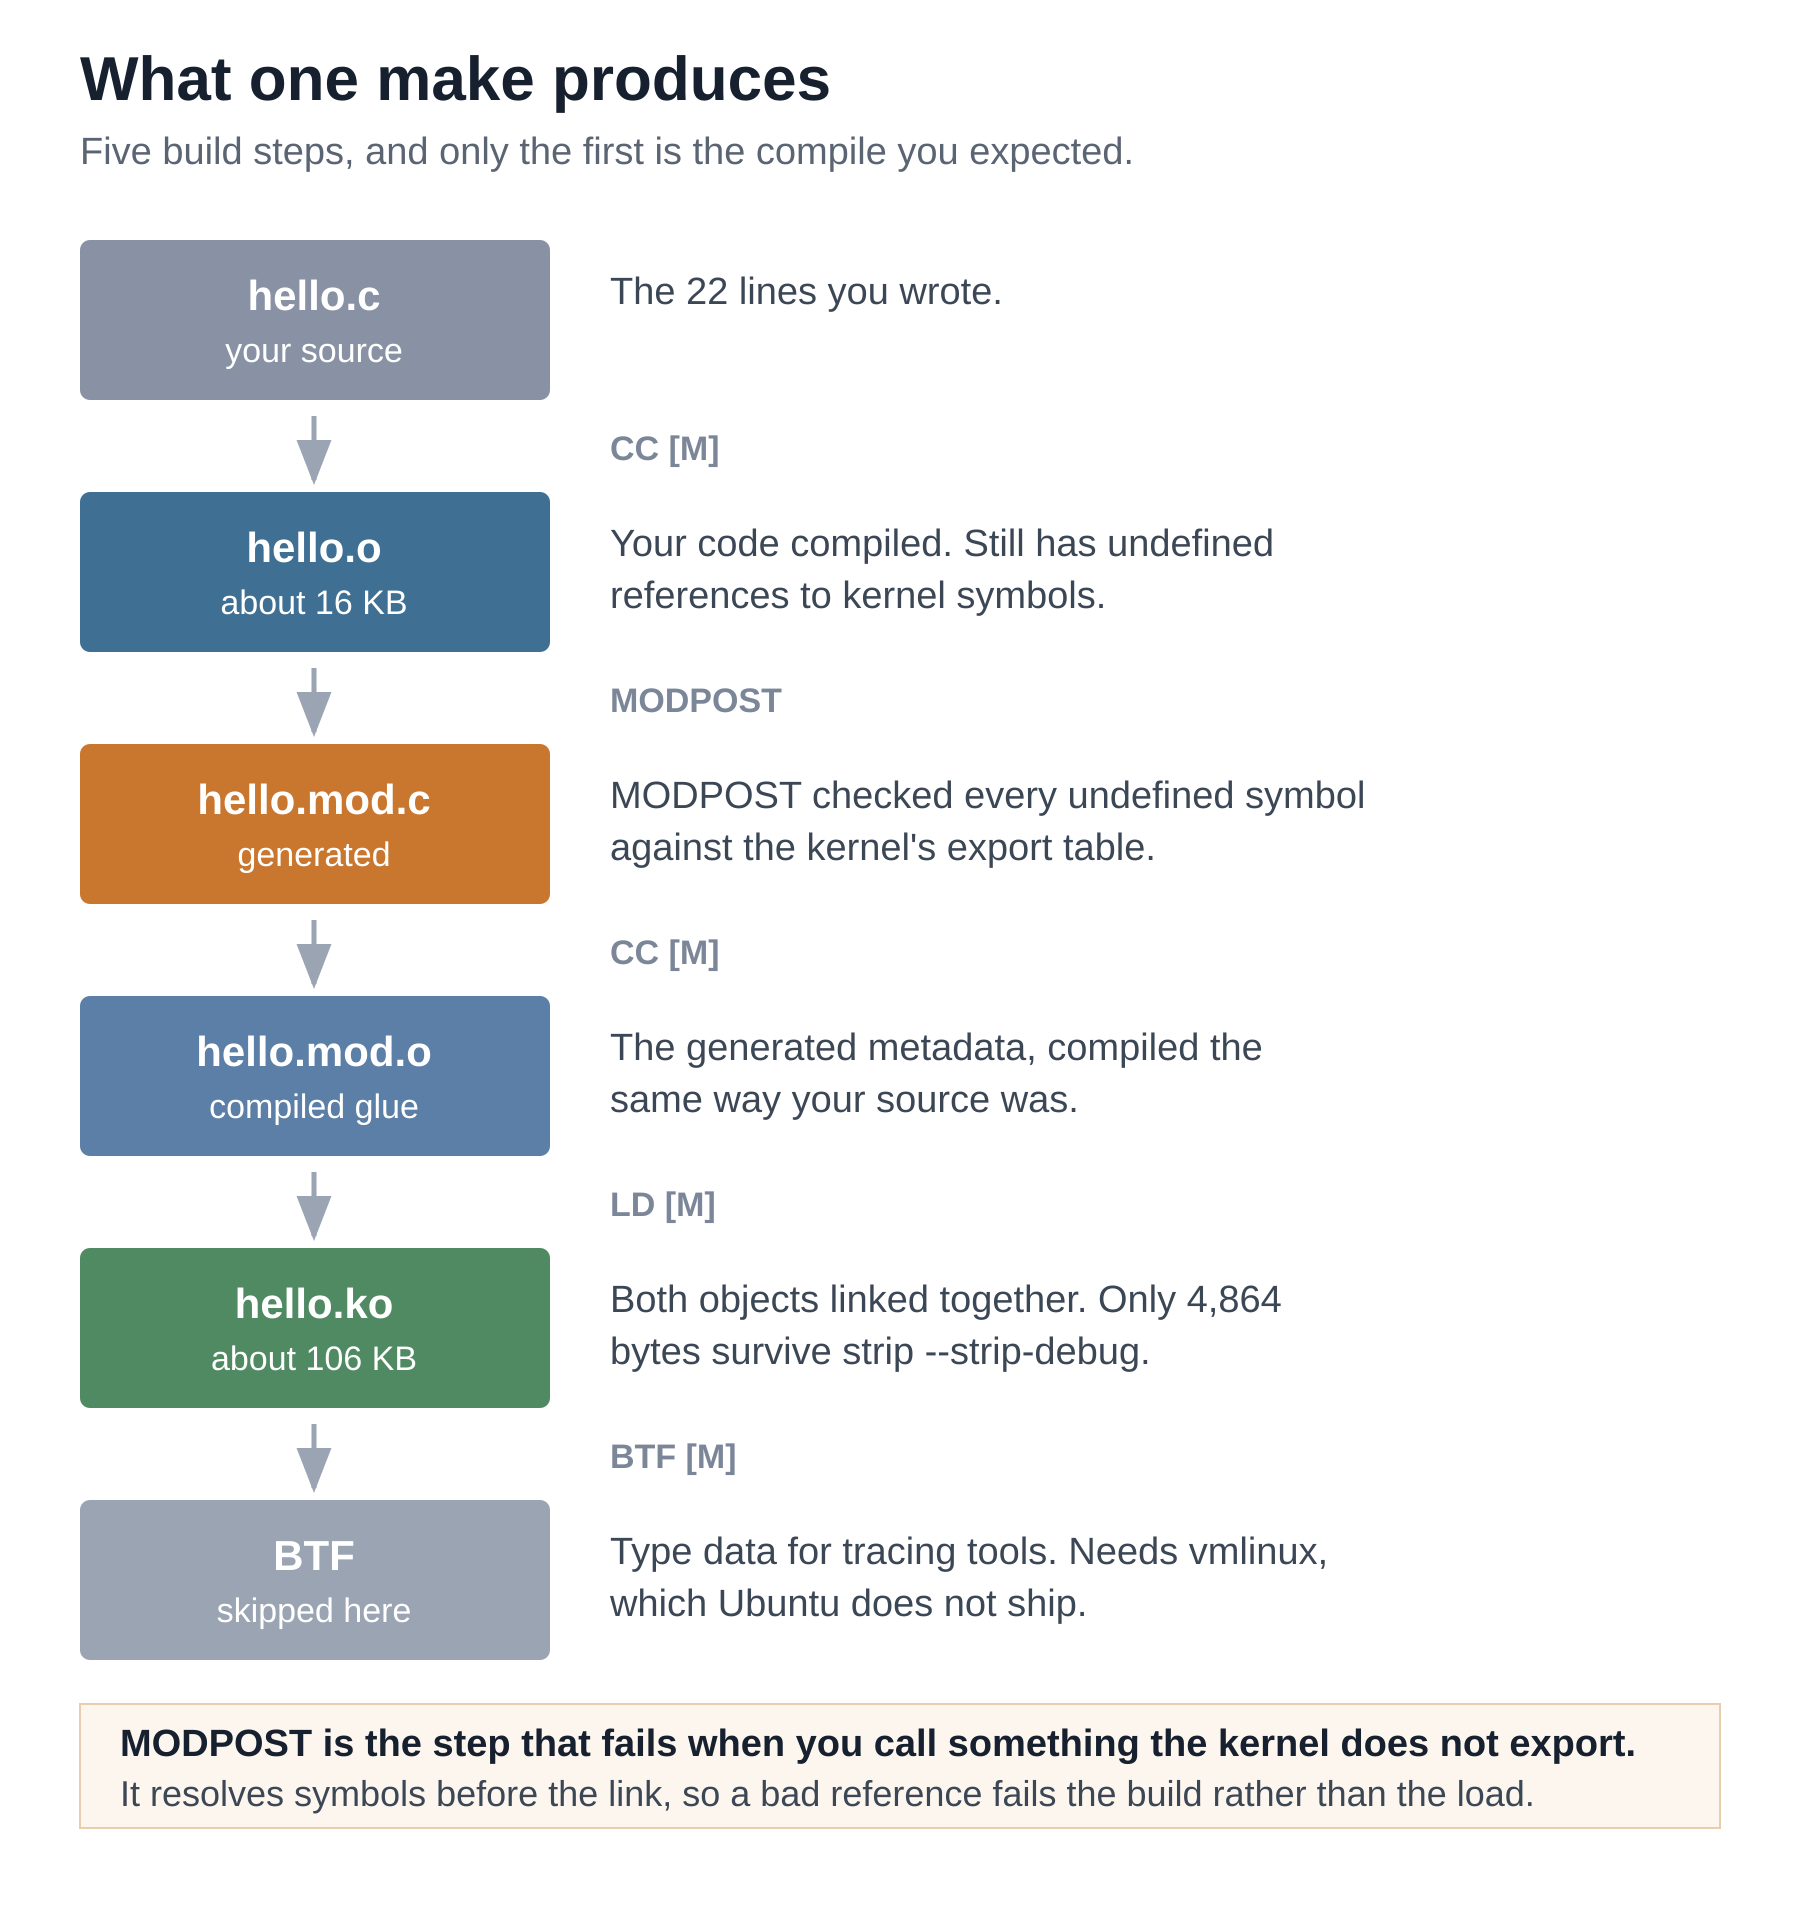
整个构建过程包含五个步骤,但只有第一步才是你通常所理解的编译环节。
CC [M] hello.o这条命令负责编译你的源代码文件,这是一个普通的编译过程。
MODPOST这个步骤值得特别注意。它会检查你的目标文件中那些被引用但并未定义的符号,然后对比这些符号与内核提供的导出符号表;如果发现使用了内核没有提供的符号,构建过程就会失败。此外,MODPOST还会生成一个名为hello.mod.c的小文件,其中包含了你的模块的相关元数据信息。
CC [M] hello.mod.o 命令会编译生成那些用于连接的代码片段,而 LD [M] 会将这些代码与你的对象文件链接起来,最终生成 .ko 文件。
BTF [M] 命令用于添加追踪工具所需的类型信息。但在本次构建过程中跳过了这一步,因为生成 BTF 需要未压缩的 vmlinux 镜像,而 Ubuntu 默认并不提供这个镜像。虽然构建过程会发出警告,但还是会继续进行——这是正确的做法:BTF 虽然有用,但并非必需。
.ko 文件的内部结构
.ko 文件实际上是一个普通的 ELF 对象文件,只不过其中添加了一些与内核相关的特殊部分。让我们来看看它的元数据:
modinfo ./hello.ko
version:        0.1
description:    一个最小的可加载内核模块
author:         Chris Roy
license:        GPL
srcversion:     39D86510C9FF65D797EAF90
depends:
retpoline:      Y
name:           hello
vermagic:       5.15.0-190-generic SMP mod_unload modversions
所有这些信息都存储在一个 ELF 部分中,以空格分隔的字符串形式存在。你可以直接从文件中读取这些内容:
objcopy -O binary --only-section=.modinfo hello.ko /dev/stdout | tr '\0' '\n'
从上面的输出可以看出,这个模块在磁盘上的大小约为 106,000 字节:
ls -l hello.ko
cp hello.ko /tmp/ && strip --strip-debug /tmp/hello.ko && ls -l /tmp/hello.ko
105984  hello.ko
  4864  /tmp/hello.ko
实际上,模块本身的大小不到 5 千字节。其余的部分都是构建过程中生成的 DWARF 调试信息,这些信息的作用是让 crash 和 gdb 这类工具在程序出现异常时能够理解你的代码逻辑。当你加载这个模块时,内核并不会加载那些调试信息,因此内存占用量其实就是那个较小的数值。
你的“Hello World”程序其实已经依赖于三样东西
这部分内容其实是我想先让人向我展示的。让我们看看这个模块到底需要内核提供哪些资源:
nm -u hello.ko
U __fentry__
U _printk
U __x86_return_thunk
U 表示这些符号在编译时并未被定义,因此模块在加载时必须依赖内核来提供这些符号。
_printk 这个符号是可以理解的,因为 pr_info 函数实际上就是调用了 _printk。
__fentry__ 是编译器在每个函数的开头添加的代码。由于内核本身支持函数追踪功能,因此你在模块中编写的每一个函数都会包含这段代码。正是这一机制使得后来可以使用 ftrace 工具来分析你的代码,而无需重新编译。
__x86_return_thunk 是一种用于防范 Spectre 漏洞的防护措施。编译器会将普通的返回指令替换为调用一个特殊的 thunk 函数,从而避免利用该漏洞的投机性执行路径。由于这种防护措施适用于机器上的所有内核代码,因此即使是一个简单的打印模块也会包含这段代码。
在“hello world”示例中使用的三个符号中有两个属于基础设施,这些是机器强制要求你使用的。这其实很好地反映了编写内核代码的实际情况。
在链接成功之前,MODPOST会验证这三个符号确实存在。如果你调用了内核没有导出的函数,构建过程就会在这一点上失败,并出现“未定义符号”的错误,而不会生成一个在加载时就会出错的模块。
vermagic与你的模块为何无法加载
再看看modinfo中的那行代码:
vermagic: 5.15.0-190-generic SMP mod_unload modversions在内核加载任何内容之前,都会将这个字符串与自身存储的值进行比较;如果两者不一致,内核就会拒绝加载该模块。这个验证机制会考虑内核的版本、是否支持SMP架构、是否启用了模块卸载功能,以及是否使用了符号版本控制等功能。
这就是为什么在一个机器上编译好的模块通常在另一个机器上无法加载的原因,也是为什么升级内核后需要重新编译所有模块的原因。
Linux内核本身并不保证应用程序接口的稳定性。不同版本的内核其内部结构会发生变化,因此用一个版本的内核编译出的模块如果用在另一个版本的内核上,很可能会导致内存损坏,而不会干净地出现故障。内核拒绝加载这样的模块,其实是在采取一种谨慎的措施。
这也正是DKMS存在的原因。如果你安装了VirtualBox、ZFS或NVIDIA驱动程序,那么你的系统就已经在自动使用DKMS机制来重新编译相应的模块了。以这台机器为例:
modinfo vboxdrv | head -3filename: /lib/modules/5.15.0-190-generic/updates/dkms/vbox drv.ko
version: 6.1.50_Ubuntu r161033 (0x00320000)
license: GPL注意路径中的updates/dkms/这一部分。DKMS会保存模块的源代码,并且每次你安装新的内核时都会重新编译这些模块。这就是为什么进行vermagic验证后,维护工作就变得不可避免了。
在加载时传递参数
一个总是执行相同操作的模块通常并不是你所需要的。通过module_param函数,可以在加载时设置某些变量的值。将以下代码保存为param.c文件,并与hello.c文件一起使用:
#include
#include

MODULE LICENSE("GPL");
MODULE DESCRIPTION("一个可以接收参数的模块");

static char *who = "world";
static int times = 1;

module_param(who, charp, 0444);
MODULE_PARM_DESC(who, "要向谁打招呼");
module_param(times, int, 0644);
MODULE_PARMDESC_times, "要打多少次招呼");

static int __init param_init(void)
{
    int i;

    for (i = 0; i < times; i++)
        pr_info("param: hello, %s\n", who);
    return 0;
}

static void __exit param_exit(void)
{
    pr_info("param: unloaded\n");
}

module_init(param_init);
module_exit(param_exit);
将这个模块添加到Makefile中,该文件会接收一个参数列表:
obj-m += hello.o param.o这三个参数分别是变量本身、它的类型,以及该变量在 `/sys/module/` 目录下所代表的文件的权限设置。权限设置为 `0444` 时,该文件在加载后既可被读取,其内容也不会被修改;而权限设置为 `0644` 时,root 用户可以在模块运行过程中对该文件进行写入操作并更改其中的值,这种设置非常实用。不过,如果模块在未预料到变量会被修改的情况下直接读取它的值,就可能会引发程序异常。
charp 是一种字符指针类型,其他常见的数据类型还包括 int、bool、long,以及通过 `module_param_array` 定义的 charp 数组。如果传递给该函数的参数类型与实际变量类型不匹配,构建过程将会失败,而不会在后续运行过程中出现异常。
MODULE_PARM_DESC 用于将变量的描述信息添加到模块的元数据中,这样 modinfo 命令就能读取这些描述信息:
name:           param
parm:           who:要向谁打招呼(charp类型)
parm:           times:要打多少次招呼(int类型)
在模块加载时,可以通过 `name=value` 的格式来设置这些参数:
sudo insmod ./param.ko who=kernel times=3
在加载模块之前,任何人都可以查看该模块接受哪些参数,因此编写 MODULE_PARM_DESC 描述信息确实是非常有必要的。
模块的加载过程及输出结果的位置
sudo insmod ./hello.ko
sudo dmesg | tail -2
lsmod | grep hello
sudo rmmod hello
pr_info 命令产生的输出信息会被写入内核的环形缓冲区中,因此这些信息会显示在 dmesg 中,而不会出现在终端窗口里。如果没有 root 权限无法查看 dmesg 的内容,那可能是由于设置了 `kernel.dmesgrestrict` 规则;此时可以使用 sudo journalctl -k | tail 命令通过日志文件来查看相同的信息。
在格式字符串中,`%pS` 用于将内核指针以符号名称和偏移量的形式显示出来,而不是以原始地址的形式呈现。这样,从日志记录中就能读取到易于理解的信息,而不会看到十六进制的地址数值。
lsmod 命令会读取 /proc/modules 文件,并显示三列信息:模块名称、其在内存中的占用大小,以及依赖于该模块的其他组件的数量。如果某个模块的依赖组件数量不为零,那么就无法卸载该模块,这也是 `rmmod` 命令会拒绝执行卸载操作的最常见原因。
在加载任何模块之前,都需要格外小心。因为用户空间中的错误可能会导致程序崩溃,而内核层面的错误则可能会使整个系统瘫痪或导致文件系统损坏。因此,在初次尝试加载模块时,最好在虚拟机环境中进行测试。创建一个系统快照的成本远远低于修复损坏磁盘所需的成本。
四种构建错误及其含义
这四种错误是导致人们花费大量时间进行调试的常见原因,不过一旦了解了这些错误的具体含义,就能迅速找到问题的根源。
No rule to make target 'modules'. Stop. 这个错误提示表示内核头文件缺失,或者位于 `/lib/modules/$(uname -r)/build` 路径下的符号链接指向无效位置。请安装与当前运行中的内核版本完全匹配的头文件包。需要注意的是,如果自上次系统更新后没有重新启动计算机,那么安装的很可能不是最新版本的内核头文件。
ERROR: modpost: “some_function” [hello.ko] 未定义! 你引用了一个内核并未导出的符号。在真正的构建过程中,会出现如下错误:
ERROR: modpost: “this_symbol_does_not_exist” [bad.ko] 未定义!
make[2]: *** [scripts/Makefile.modpost:133: Module.symvers] 错误 1
重新尝试也不会解决问题。要么这个函数是内核内部的、从未被导出过,要么它是使用 EXPORT_SYMBOL_GPL 导出的,而你的模块却声明使用了非GPL许可证。你可以使用命令 grep the_symbol /proc/kallsyms 来检查;其中第二列中如果出现大写的 T,那就表示这个符号是全局文本符号。
insmod: ERROR: 无法插入模块:模块格式无效:虽然构建过程成功了,但 vermagic 与当前正在运行的内核不匹配。请将 modinfo ./hello.ko | grep vermagic 的结果与 uname -r 的输出进行比较。使用正确的头文件重新构建即可解决这个问题。
insmod: ERROR: 无法插入模块:操作不被允许:通常这种情况是由于 Secure Boot 拒绝了未签名的模块,或者系统处于保密模式。在认为是你的代码出了问题之前,请先检查 mokutil --sb-state 和 cat /sys/kernel/security/lockdown 的结果。
还有一点需要特别注意:在构建过程中加载任何非内核源代码中的模块,都会在内核上设置一个标记,而这个标记会在后续出现错误或系统崩溃时被记录下来并显示出来:
cat /proc/sys/kernel/tainted这个标记实际上是一个位掩码。在我的机器上,它的值为 4096,也就是第12位被设置了值,即 TAINT_OOT_MODULE,这说明曾经加载过某个非内核源代码中的模块。
经常有人会把第13位与这个位混淆,其实第13位的含义是 TAINTUnsigned_MODULE,而 Secure Boot 正是在关注这个位。
关于这些标记的完整说明,请参阅内核源代码中的 include/linux/panic.h 文件。内核开发者会在查看你的问题之前,要求你在未设置这些标记的内核上重新重现错误现象,而这个文件正好可以告诉他们你是否做到了这一点。
为什么你找到的教程无法编译
网上大多数关于模块开发的教程都是在一些较早的版本基础上编写的,而这些早期版本中存在的一些细节现在已经发生了变化,因此这些教程就会导致问题。
printk(KERN_INFO “…”) 这种写法仍然可以使用,但现在的标准是使用 pr_info,而且它还会自动确定日志的输出级别。
init_module 和 cleanup_module 如果以纯函数名的形式出现,那也是旧有的用法。现在应该使用 module_init 和 module_exit ,并且可以为它们指定自定义的名称,这样同一个文件中就可以同时定义这两个函数而不会产生冲突。
MODULE_LICENSE 这个选项在过去其实是可选的,但现在它已经变成了一个至关重要的部分,因为它是控制是否能够访问仅通过GPL协议导出的符号的关键。
M= 这个参数过去曾被写作 SUBDIRS=,但这种写法已经被取消了,因此如果使用旧的写法来编写教程,就会遇到错误,因为系统中根本不存在 SUBDIRS 这个选项。头文件的路径已经发生了变化。任何引用/usr/src/linux的内容,都属于在将内核相关头文件分割成单独的包之前的版本了;由于这些内容存在的时间太久,因此其余部分也需要进行检查。还有一个小例子:
如果某个教程在您的 kernel 上编译时没有出现任何警告,那么这个教程所使用的 kernel 版本应该是最新的。如果没有警告出现,那么目标 kernel 版本通常会显示在第一个错误信息中。
结论
现在,您已经能够构建内核模块,了解编译结果,并理解该模块所依赖的各个符号的含义了。
更重要的是,您也明白了为什么这个模块会以特定的方式出现故障。如果缺少/lib/modules/$(uname -r)/build目录,那通常是由于头文件相关的问题;如果版本标识不匹配,就需要重新编译模块;而如果在 MODPOST 阶段遇到未定义的符号,那就说明内核并没有导出您所需要的功能,无论尝试多少次重新编译都无法改变这一情况。
接下来,您可以尝试一些新的方向。例如,可以使用proc_create函数在/proc中注册一个条目,并从中读取数据——这是模块能够实现的最基本的功能之一。
您还可以阅读位于/usr/src/linux-headers-$(uname -r)/目录下的内核文件Module.symvers,这个文件列出了 MODPOST 阶段会检查的 26,420 个导出符号,并为每个符号指明了是EXPORT_SYMBOL还是EXPORT SYMBOL_GPL属性。
或者,您也可以追踪自己编写的模块中的函数调用过程。这是因为从最初的内核版本开始,就存在__fentry__这个钩子函数。虽然没有专门的ftrace命令可供使用,但您可以通过写入文件来控制这一功能:
sudo sh -c 'echo hello_init > /sys/kernel/tracing/set_ftrace_filter'
sudo sh -c 'echo function > /sys/kernel/tracing/current_tracer'
sudo cat /sys/kernel/tracing/trace
在较旧的系统中,这个路径应该是/sys/kernel/debug/tracing。如果您不愿意手动编写这些文件,那么trace-cmd工具也可以提供同样的功能。
结语
以上所有内容都假设您被允许执行这些操作,而正是这个假设让我觉得很有意思。一旦模块被加载到系统中,它就会拥有与内核本身相同的权限——它可以读取任何内存数据、修改任何函数代码,甚至可以无视系统原本设定的各种限制规则。因为当模块运行时,已经没有任何机制能够阻止它这样做。
正因为如此,模块加载这种操作成为了权限模型无法控制的领域,因此内核才会通过签名验证和锁定机制来保护这一过程,而不是依靠传统的权限设置。
在我开发一个基于能力模型的桌面操作系统时,就遇到了这样的问题。在这种系统中,程序的权限范围完全由其配置文件决定,而 Debian 生态系统仍然需要在这种框架下正常运行。在这种情况下,模块的使用就会使得这种权限模型变得无法有效实施,因此弄清楚内核在接收模块之前会检查哪些内容,就不再是一个次要问题,而成为了一个重要的设计约束条件。
我在thechris.in上撰写关于系统及其神秘本质的文章。相关文章
如何将Jekyll博客主题移植到Python环境中:实际操作中的经验与教训
几年来,我一直在使用一个采用 tufte-jekyll 样式设计的博客,正是这个经历让我发现了Edward Tufte所提出的布局理念。 Edward Tufte 因在数据可视化与信息设计领域的贡献而闻名,他是高数据密度设计的坚定支持者,同时也极力反对使用那些毫无意义的视觉元素。 tufte-css (以及它的许多衍生版本)为网页设计带来了诸多优势:充足的空白空间、适合阅读的排版格式,还有用于提供补充信息的 侧边注释 (而非干扰用户体验的弹出窗口)。 除了那些与写作无关的部分外,我对 tufe-jekyll 博客的设计几乎毫无意见。这个基于 Jekyll 框架、使用 Ruby 语言开发的版本,
阅读全文
iOS NFC使用指南:如何使用React Native读取、写入NFC标签以及锁定这些标签
将iPhone靠近贴纸,就会发生一些奇妙的事情:名片会自动添加到联系人列表中,某个聚焦操作会结束,或者某扇门会自动打开。这种芯片的成本大约为20便士,其存储容量约为130字节。 读取一条NFC信息需要执行两次函数调用;而要获得执行这些调用的权限,则需要花费更长的时间。之后,CoreNFC还会要求你再次完成这个流程。 第一个障碍来自苹果公司:你需要拥有一个付费开发者账户,在某个网站平台上注册应用ID,勾选相关选项,并重新生成配置文件。如果其中任何一步出错,构建过程就会因为代码签名错误而失败,而这些错误信息中根本不会提到“NFC”这个词。 第二个障碍则来自CoreNFC本身,而且没有人会提醒你注意
阅读全文
如何使用Python和依赖关系图来检测公共数据集中隐藏的目标泄露现象
不久前,我给一个机器学习模型提供了来自公共CDC数据集的五列数据,让它尝试预测同一文件中的第六列数据。该模型的R²值为0.998,这个数值已经非常接近完美了。 虽然这个结果看起来很成功,但实际上该模型对现实世界的认知几乎没有任何提升——因为CDC本身就是根据其他五列数据计算出了第六列数据的,所以该模型实际上只是机械地应用了CDC的计算方法而已。 数据科学家将这种问题称为 目标信息泄露 ,当输入给模型的数据本身就已经包含了答案的某些信息时,就会发生这种情况。 在公共数据中,这类问题很容易被隐藏起来,因为大量的公共数据都是通过其他公共数据计算得出的。例如,一个政府指数可能是根据调查数据构建的,而另
阅读全文
在Linux系统中,系统调用究竟是如何工作的
这是一个简单的C程序。它调用了三次`clock_gettime()`函数,然后向标准输出输出了5个字节。 #include #include #include int main(void) { struct timespec ts; for (int i = 0; i 这两者看起来都属于系统调用。它们都是向内核请求程序本身无法获取的信息:当前时间,以及文件描述符的访问权限。 gcc -O0 -o mystery mystery.c strace ./mystery 2>&1 | grep -c clock_gettime 答案是`0`。 write() 函数被立即执行了,而那三次`clock_
阅读全文