
iOS NFC使用指南:如何使用React Native读取、写入NFC标签以及锁定这些标签
将iPhone靠近贴纸,就会发生一些奇妙的事情:名片会自动添加到联系人列表中,某个聚焦操作会结束,或者某扇门会自动打开。这种芯片的成本大约为20便士,其存储容量约为130字节。 读取一条NFC信息需要执行两次函数调用;而要获得执行这些调用的权限,则需要花费更长的时间。之后,CoreNFC还会要求你再次完成这个流程。 第一个障碍来自苹果公司:你需要拥有一个付费开发者账户,在某个网站平台上注册应用ID,勾选相关选项,并重新生成配置文件。如果其中任何一步出错,构建过程就会因为代码签名错误而失败,而这些错误信息中根本不会提到“NFC”这个词。 第二个障碍则来自CoreNFC本身,而且没有人会提醒你注意
将iPhone靠近贴纸,就会发生一些奇妙的事情:名片会自动添加到联系人列表中,某个聚焦操作会结束,或者某扇门会自动打开。这种芯片的成本大约为20便士,其存储容量约为130字节。
读取一条NFC信息需要执行两次函数调用;而要获得执行这些调用的权限,则需要花费更长的时间。之后,CoreNFC还会要求你再次完成这个流程。
第一个障碍来自苹果公司:你需要拥有一个付费开发者账户,在某个网站平台上注册应用ID,勾选相关选项,并重新生成配置文件。如果其中任何一步出错,构建过程就会因为代码签名错误而失败,而这些错误信息中根本不会提到“NFC”这个词。
第二个障碍则来自CoreNFC本身,而且没有人会提醒你注意这个问题。这种基于会话的API使用了委托回调机制,包含四个嵌套的异步处理步骤,同时还有一系列规则,这些规则会在不知不觉中给你带来麻烦。
如果将会话相关数据存储在错误的变量中,系统会毫无提示地终止操作;如果成功读取了NFC信息,但随后又进行了第二次读取请求,结果反而会显示失败;如果请求的参数数量超过了允许的范围,整个会话流程就会直接拒绝启动,而不会具体指出是哪个参数出了问题。
在这本手册中,你会学会如何克服这些障碍。你需要亲手编写NDEF解码器,虽然听起来有些大费周章,但当你了解到那些流行库在处理emoji信息时实际做了什么之后,就会明白这其实是非常有必要的;你还会尝试给标签写入数据,但却会发现自己的名片信息并不适合用这种方式存储;你还会构建一个无法停止的聚焦计时器,除非走到另一个房间才能终止它;你甚至会彻底删除对NFC技术的依赖,转而使用Swift语言中的原生模块;最后,你还会学会如何永久性地锁定某个标签,而这是本手册中唯一一项无法撤销的操作。
在编写这个程序的过程中,我得出了两个错误的结论,这两个错误至今仍然存在于代码仓库中,只不过被标记为“已被替换”的内容。我把这些错误过程记录在这里,是因为了解我是如何犯错的,其实比了解后来用什么方法纠正了这些错误更有价值。
这本手册专门针对iOS平台编写。主章节中的所有内容都是在真实的iPhone设备上完成开发、测试和验证的。Android平台的相关内容会有另一本手册介绍;如果你等不及看那一本,书末还提供了预览内容:这是用Kotlin语言实现的相同功能,其中详细说明了两种平台在架构上的差异,这些差异使得对比它们非常有意义。
下面所有的内容都来源于一个名为TapCard的项目,这个项目托管在GitHub上,其中包含了各个阶段的代码检查点,因此你可以随时查看项目的进展并运行测试。
目录
先决条件
要跟随本教程进行学习,您需要准备以下物品:
一部具备NFC功能的iPhone,7版或更高版本。Core NFC功能仅适用于iPhone。苹果的官方文档明确指出只有iPhone 7及后续版本才支持这一功能,而且一位苹果工程师也在开发者论坛上直接表示:“目前,Core NFC功能仅能在具有NFC功能的iPhone上使用。iPad并不支持这一功能。”
一个付费的Apple开发者账户。免费提供的配置文件不包含NFC功能。这是一个强制性的要求,没有其他替代方案。
NTAG213标签贴纸。购买20张这样的标签贴纸大约需要几英镑。在开始编写代码之前,请务必先购买这些贴纸。
Node.js 20及以上版本以及Xcode开发工具。在整个学习过程中,您需要掌握TypeScript的相关知识;在最后三分之一的学习内容中,则需要重点了解Swift语言。
可选:仅针对Android预览版本而言,还需要安装Android Studio及API 36 SDK。
我实际使用的软件版本如下:
| 软件名称 | 版本号 |
|---|---|
| Expo SDK | 57.0.20 |
| React Native | 0.86.3 |
| React | 19.2.3 |
| TypeScript | 6.0.3 |
react-native-nfc-manager |
3.17.2(在后续版本中被移除) |
| Xcode | 26.6 |
| JDK | 17 (Zulu版),仅用于Android预览 |
其中有一行信息非常重要,我稍后会再次提到:NFC相关库被列在清单中只是因为最终这些代码会被删除。完成开发后的应用程序完全不依赖任何第三方NFC组件。
NFC标签的真正含义
NFC标签其实是一种内置有微型天线且没有电池的芯片。您的手机会通过无线方式为该芯片供电,而作为回报,该芯片会返回几十字节的数据。这就是整个NFC标签的全部构造。
这些数据几乎总是以NDEF格式进行存储的,也就是NFC数据交换格式。正是这种格式使得由某个应用程序生成的NFC标签能够被其他所有应用程序读取。一个NDEF消息实际上是由一系列记录组成的,每条记录都包含类型和数据内容。
本手册中提到的标签贴纸属于NTAG213类型,这种标签贴纸可以在网上购买到。它们拥有144字节的存储空间,不过实际可使用的存储空间并非这个数值,而这一点其实非常重要。
NFC标签有以下几点需要注意:
NFC标签并不是信号发射器。它们本身没有电力,只有在手机距离它们几厘米范围内时,才会开始工作并发送数据。
NFC标签默认情况下并不安全。它们的标识信息可以被任何设备读取,而且使用廉价的硬件设备就可以复制这些信息。后面会有专门的内容介绍这一点,因为将NFC标签作为密码来使用,是最容易出问题的用法之一。
您之前在哪里接触过NFC技术
NFC技术其实已经存在于我们的日常生活中了。不过,对于用户来说,有些功能是可以实现的,而有些则无法实现——尽管从外观上看,这些功能似乎都是相同的。
以下是五种你可以亲自去尝试的使用场景,每种场景都由相关公司提供了详细说明:
| 你可能在哪些地方见过这种技术 | 使用这种技术会带来什么效果 | 来源 |
|---|---|---|
| 在你自己的手机上使用快捷指令 | 扫描标签即可触发相应的自动化操作 | 在“快捷指令”中设置触发条件 |
| 当AirTag丢失时 | 任何使用NFC功能的手机扫描该标签,都会打开显示所有者信息的页面 | 在“查找”应用中将物品标记为丢失 |
| Nintendo的amiibo手办 | 将amiibo手办贴在控制器上,某些游戏会读取其中的数据,而有些游戏则会将你的角色信息写回这些手办上 | amiibo常见问题解答 |
| 英国签证申请流程 | “英国移民:身份验证”应用程序会读取你护照中的芯片信息 | 使用该应用程序的说明 |
| iPhone上的“触碰支付”功能 | 商家无需任何终端设备,即可通过手机进行非接触式支付 | iPhone的“触碰支付”功能 |
前三种使用场景正是本手册所要讲解的内容。芯片中存储着少量数据,读取器会读取这些数据,然后软件会根据这些数据执行相应的操作。amiibo手办是其中最典型的例子,因为有些游戏不仅会读取芯片中的信息,还会将数据写回芯片中——而这正是你接下来要学习的内容。
关于第一行中的内容,有一点值得特别关注,因为后面还会提到它。苹果手机内置的NFC自动化功能对于你扫描的标签有以下说明:
“除了唯一的标识符外,NFC标签中的其他信息都会被忽略。”
苹果的这项技术会忽略本手册中介绍的所有数据编写方法,而只依赖序列号来进行识别。后面会有专门的部分解释这样做到底能带来什么好处,以及有哪些局限性。
关于这个表格,还有两点需要注意:护照相关的内容虽然使用的是NFC技术,但它并不属于NDEF格式;生物识别芯片通过相同的无线电频率传输ISO 7816标准的数据,但使用的协议是NFCISO7816Tag,权限验证方式也有所不同,而且还会应用额外的加密技术。同样的天线,却有着完全不同的工作原理,因此这部分内容不在本手册的讨论范围内。最后一行提到的功能也是你目前无法实现的。
除了这五种使用场景外,凡是需要实物向手机传递简短信息的情况,都可以运用这种技术——比如博物馆的标签用来打开展览页面、会议徽章、瓶子上的产品认证印章、公共交通广告、餐厅用的桌牌,以及人们贴在桌上用来启动某些日常任务的贴纸等等。
在iOS系统中,有那么一部分功能是无法实现的:你的手机必须“伪装”成一张卡片才行。比如Apple Pay、存放在Google Wallet中的银行卡信息,或者Apple Wallet里用于酒店开门的钥匙卡。这些功能都是通过名为“安全元件”的专用芯片来实现的——这种芯片具有防篡改功能,能够独立存储卡片的相关信息,并与终端设备进行交互。在iOS系统中,根本不存在任何第三方API来支持这些功能,也就是说,这些功能是完全被封闭起来的,没有任何开放的接口可供使用。后面会有专门的内容详细说明这一点。 因此,当有人提到“NFC”技术时,他们可能指的是这两种其中任意一种功能。这本手册主要介绍的是那些可以编写代码来实现的功能部分,同时也会清楚地解释为什么另外那部分功能是无法使用的。 **标题:为什么没有模拟器环境可供测试** 请不要跳过这一节,因为它会直接影响你的开发流程。 在iOS模拟器或Android模拟器中,NFC技术是根本不存在的。它既没有被部分支持,也没有被设置为可选项——因为相应的硬件设备并不存在,相关的API也会报告该功能不可用。所以,你开发的每一段代码都必须通过将实际的芯片与真实的手机进行配合测试才能验证其正确性。 这种限制带来的影响远不止是不便而已。你无法编写测试用例来证明标签信息已被成功读取;也无法在持续集成环境中演示相关功能;如果你的手机位于另一个房间,那么测试就会受到影响。有一次,我的测试芯片在邮寄过程中丢失了,导致整个项目停滞了两周时间。 应用程序中会明确标注这一点,因为这个问题经常被人们提出来: ```typescript import * as Device from 'expo-device'; // 在iOS模拟器或Android模拟器中,NFC硬件并不存在, // 因此调用isDevice方法也会返回false。因此应该提前进行检查。 if (!Device.isDevice) return false; ``` 所以,你的代码需要被分成两部分来编写。其中一部分代码用于与NFC硬件进行交互——包括建立会话、读取标签信息、向标签写入数据以及关闭会话等操作;而另一部分代码则主要处理数据转换工作:比如将标签上的字节数据转换为URL格式,或将联系人信息转换成适合存储的字节序列,等等。 这些功能中并没有哪一项需要依赖NFC技术,实际上,大多数功能甚至都不需要使用React Native框架。它们其实就是一些简单的函数而已——输入某些值,然后得到相应的输出结果。如果你按照这种方式编写代码,那么即使房间里没有手机,你也可以在笔记本电脑上对其进行测试。在这个项目中,相关代码总共包含了约2,240行TypeScript代码,以及**293个测试用例**,这些测试用例的运行时间都不到一秒钟。而那些真正需要调用CoreNFC函数的代码部分,也被我尽可能地简化到了最简洁的程度。 在整个开发过程中,这个项目因为硬件限制而遇到了三次停滞,其中两次甚至是因为快递问题导致的延迟。不过每次遇到这种问题时,其实还有很多功能是可以继续开发的——因为大部分功能其实并不需要依赖NFC技术。这种“被迫做出最优选择”的情况,反而让我的代码质量得到了提升。iOS合约的运作原理
在这里,有三个与苹果相关的术语起着关键作用。在了解后续步骤之前,弄清楚这些术语的含义是非常重要的,因为错误信息会假定你已经了解了它们。
应用ID是你的应用程序在苹果服务器上注册时使用的身份标识,它与你配置文件中的bundleIdentifier是一致的。权限设置则是应用程序中用于说明“我打算使用这项功能”的内容,NFC功能就属于这类权限设置。配置文件则是一份经过签名的文档,它将应用ID、权限设置以及你的开发者账户信息联系在一起,Xcode会在每次构建应用程序时自动包含这份文件。只有这三者完全匹配,应用程序才能在设备上正常运行。
下面是具体的操作步骤,每个步骤都非常重要:
需要一个付费的苹果开发者账户。
需要在developer.apple.com上注册一个明确的应用ID,而不能使用通配符。
需要为该应用ID启用NFC标签读取功能。
需要重新生成配置文件,以便包含这项功能。
接下来,在app.json文件中做如下设置:
{
  "expo": {
    "ios": {
      "bundleIdentifier": "com.yourname.tapcard",
      "infoPlist": {
        "NFCReaderUsageDescription": "TapCard使用NFC技术来读取和写入标签信息。"
      },
      "entitlements": {
        "com.apple.developer.nfc.readersession.formats": ["NDEF", "TAG"]
      }
    }
  }
}
如果错过了第2步或第3步,构建过程就会失败,并会出现如下错误信息:
配置文件“iOS Team Provisioning Profile: *”不支持NFC标签读取功能。这个错误实际上是指错了问题所在。苹果明确禁止在通配符形式的应用ID上使用特殊功能,而当没有明确的匹配项时,Xcode会自动使用通配符对应的设置。
虽然错误信息显示问题出在你的本地配置文件上,但实际上问题出在苹果服务器上的一个未填写的网页表格中。根本不需要打开浏览器来处理这个问题。
还有一个需要注意的地方:应用ID在所有苹果开发者账户中都是全球唯一的,而不是每个开发团队各自拥有不同的应用ID。我的第一个可选的应用ID已经被别人占了,第二个也被占用了,所以我不得不两次重新命名应用程序的标识符。
这种重新命名的操作非常简单,这里顺便提一下这个项目的配置方式。由于Expo支持持续生成原生代码的功能,因此ios/和android/文件夹根本不会被保存在代码仓库中。每当需要这些文件夹时,expo prebuild命令会根据app.json文件自动重新生成它们,就像node_modules是根据package.json生成的那样。所以,重新命名应用程序只需要修改两行JSON代码,然后运行一次prebuild --clean命令即可,这样iOS项目、Android包以及整个Kotlin源代码树都会被重新生成。完全不需要使用Xcode来进行任何操作。
作为对比,在Android平台上,只需在manifest文件中添加一行代码即可完成同样的配置,而且根本不需要注册账户或使用任何专门的平台工具,也不会产生任何费用。
<uses-permission android:name="android.permission.NFC" />
这种差异并不值得抱怨。及早认识到这一点是很重要的,因为这能让你明白在这个平台上,你的精力应该花在哪里:不是在代码上——毕竟代码本身很简短——而是应该在与之相关的各种文书工作上。
| Android | iOS | |
|---|---|---|
| 读取一个标签所需的信息 | 只需要一条配置文件中的语句 | 应用ID + 功能需求 + 支付账户信息 + 用户资料 |
| 成本 | 免费 | 99美元/年,或当地等价费用 |
| 出现故障时的表现 | 缺少必要的权限 | 会出现代码签名错误,但错误信息中并不会明确显示“NFC”这一原因 |
如何读取你的第一个标签
读取标签所需的代码非常简短,具体内容如下:
import NfcManager, { NfcTech, type TagEvent } from 'react-native-nfc-manager';

export async function readTagOnce(): Promise {
  await NfcManager.requestTechnology(NfcTech.Ndef, {
    alertMessage: '将你的iPhone靠近NFC标签。'
  });

  try {
    return await NfcManager.getTag();
  } finally {
    // 设置throwOnError为false,因为我们已经开始执行后续操作了。如果会话关闭失败,也不应该掩盖最初的错误。
    await NfcManager.cancelTechnologyRequest({ throwOnError: false });
  }
}
这两个操作在两个平台上是完全相同的。但用户看到的界面却截然不同。
在iOS上,`requestTechnology`方法会将控制权交给CoreNFC,系统会弹出一个模态窗口。你无法对这个窗口进行任何自定义设置,你的应用界面也不会显示在屏幕上。
而在Android上,系统中根本不会显示任何提示信息。如果你的应用没有提示用户点击标签,那么就真的没有人会去点击它。
因此,扫描界面的呈现方式是依赖于平台环境来决定的,这种设计模式在整个项目中都被普遍采用:
{
scanning &;& (
{Platform.OS === 'android'
? '将标签靠近手机背面。'
: '正在等待系统弹出提示窗口…'}
{/* 在Android平台上,系统不会显示任何提示界面,因此应用必须自己提供退出方式。 */}
{Platform.OS === 'android' && “取消”按钮只存在于Android平台上,因为在iOS上,系统提示窗口本身就已经包含了这个按钮。
三个可能会让你遇到问题的地方
1. 天线的位置不同。
在iPhone上,天线位于手机顶部边缘、靠近摄像头的位置;而在Android上,天线则位于手机背面的中间位置。因此,“将标签靠近手机”这个提示其实并不具有实际操作意义,如果有人使用错误的位置进行尝试,就会认为你的应用出现了故障。为了解决这个问题,我最终根据不同的平台,在界面上标出了正确的天线位置。
2. 该表格并没有显示你认为它应该显示的那条信息。
我原本以为它会显示来自《app.json》文件中的NFCReaderUsageDescription内容,但实际上并非如此。它显示的是每次调用requestTechnology()函数时传递的alertMessage字符串。而那段使用说明文本其实属于隐私声明信息:它是必须包含的,没有它就无法启动任何会话,而且永远不会被展示给用户看到。
尽管这两条信息的配置都是正确的,拼写也没有问题,但我当初对它们哪一条会被显示出来的判断还是错误的。后来我通过实际操作手机才弄清楚了真相。这也意味着,每次扫描时显示的内容都可能不同。“将你的iPhone靠近标签进行读取”这种操作方式,确实比重复使用之前读取到的信息更有效。
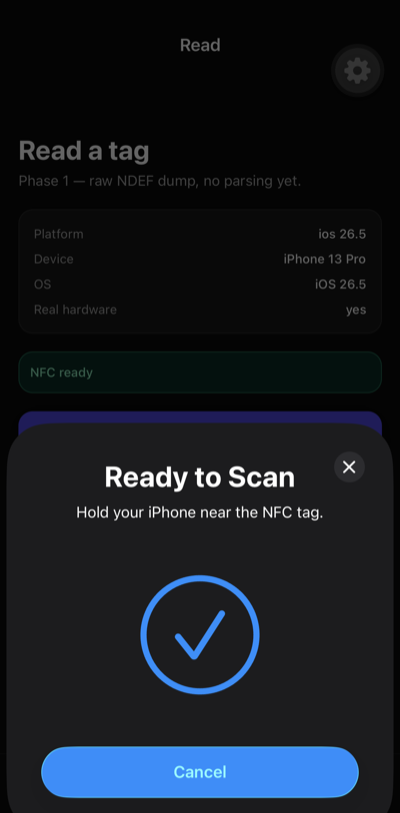
上面那行文字其实就是之前调用requestTechnology函数时返回的alertMessage内容,每一个字都是一样的。而来自《app.json》文件中的使用说明信息,在屏幕上根本看不到。
3. 在iOS系统中,空标签会被识别为错误。
出厂时的NTAG213标签虽然是NDEF格式的,但其中并没有存储任何数据,因此当使用readNDEF函数进行读取时,系统会将其报告为读取失败,而不是显示空字符串。这种区别其实取决于标签的NDEF状态,而非读取过程中出现的错误。由于你购买的每一个标签最初都是这种状态,所以这会是你在使用这些标签时首先遇到的问题。
读取结果是什么
以下是在iPhone 13 Pro上读取NTAG213标签时实际得到的输出结果:
{
  "id": "04C4FC91DF2A81",
  "tech": "mifare"
}
只有两个字段。这就是iOS系统在读取标签信息后返回的全部内容。没有标签的大小信息,没有技术类型列表,也没有NDEF格式相关信息。而Android系统则能从同一个芯片中获取所有这些信息。
我当初从这个结果得出了错误的结论:还根据这个错误结论写了三份文档,并据此规划了一整项工作内容。关于这个错误的具体内容稍后会讲到,因为这个错误反而比实际的事实更有参考价值。如果你想马上了解正确的答案,可以直接跳到后面阅读。
那个id字段其实就是标签的UID,也就是工厂在生产标签时烧录在芯片中的唯一序列号,任何能够读取该标签信息的设备都能识别出这个编号。04这个前缀代表NXP公司的制造商代码,而7字节的UID正是NTAG21x系列标签的标识符,因此这个编号确实能证明这个标签就是它所声称的那种类型。
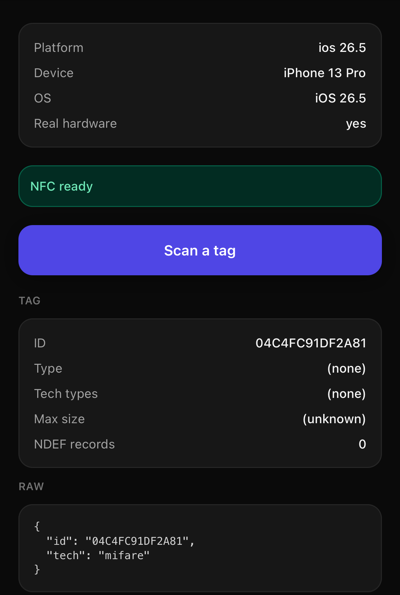
“最大长度”这一栏才是我们需要重点关注的。我之所以得出了错误的结论,正是因为误解了(unknown)这个数值,而实际上(unknown)并不是该平台能够真正提供给用户的信息。
检查点:执行
git checkout step-1-first-read命令。配置完相关权限后,屏幕上会显示原始的NDEF数据。
NDEF记录的实际构成
标签并不会存储URL地址,它存储的是字节数据,而你的应用程序接收到的也正是这些字节。这一整个章节的内容其实都在讲解如何将这些字节转换成https://example.com这样的网址,而这个过程其实比人们想象的要简单得多。
你实际操作的对象是一个记录,而一个记录由三部分组成:
有效载荷:即内容本身的原始字节数据
类型:用来说明有效载荷的具体类型,比如URI地址还是纯文本
TNF,也就是类型名称格式:由3位二进制比特组成,用于指示如何解读类型字段本身
其中第三部分就是人们经常搞错的地方。可以把类型看作是一个标签,而TNF则相当于解读这个标签的规则。当TNF值为U时,表示“URI地址”;但如果TNF值不同,同一个字节可能代表MIME字符串的起始位置。
实际上,有两种记录格式占据了几乎所有NFC通信中的数据流量,而这两种格式的结构都相当简洁。
URI记录
04 65 78 61 6d 70 6c 65 2e 63 6f 6d
│  └──────── "example.com" ────────┘
└─ 前缀索引 → "https://"

→ https://example.com
注释中说明了每个字节的具体作用。第一个字节之后的内容都是普通文本,也就是example.com这个网址本身。而第一个字节04,其实是NFC论坛规范中一个包含36个条目的表格的索引值,其中第4项对应的值就是https://。
因此,这种编码方式实际上只占用了一个字节的空间,而不是原本需要的8个字节。对于那些拥有137个可用字节的标签来说,这种优化虽然幅度不大,但仍然占用了总字节数的5%。
文本记录
文本信息需要包含URI地址所不需要的两部分信息:语言类型以及编码方式。这两部分信息都被存储在了第一个字节中。
02 65 6e 48 69
│  └─┬─┘ └─┬─┘
│   "en"  "Hi"
└─ 状态字节把第一个字节看作一个数字来理解。在这个例子中,这个数字是2,它表示语言代码的长度为2个字节。因此接下来的两个字节就是语言类型:65 6e,代表“en”英语。再后面的字节就是文本内容:48 69,代表“Hi”。
编码方式也隐藏在同一个字节中:如果这个字节的值为128或更高,那么文本就会使用UTF-16编码而不是UTF-8编码。这就是“状态字节”的全部作用。
整个编码格式就是这样的。如果你自己编写解码器,可以通过忽略低位的6位来获取长度信息,而通过最高位来判断文本的编码方式。
我为什么要自己编写解码器
人们会出于两种原因去使用某个库。要么是因为这个库无法提供他们所需的一切功能,要么就是他们工作的环境中,会优先自行开发这类功能,而将依赖外部库放在次要位置。
第二种情况其实比开源项目默认所表现出来的要普遍得多。对于NDEF来说,答案很简单:是的,你可以自己编写这样的代码。这些代码只需要几百行纯函数,其中不包含任何与平台相关的调用,而你刚刚看到的那种格式本身就已经包含了所有所需的规范信息。
而这里发生的实际情况正是属于第一种情况。这个库中包含了解码器,我在使用它们之前先阅读了相关代码,结果仅仅用了20分钟,应用程序的架构就被彻底改变了。
var languageCodeLength = data[0] & 0x3f; // 只取低16位
// languageCode = data.slice(1, 1 + languageCodeLength),
// utf16 = (data[0] & 0x80) !== 0; // 假设使用UTF-16BE编码
// 待后续处理UTF相关问题
这段代码用于获取语言代码的长度,然后利用这个长度跳过相应的代码部分,而原本应该被保留的那行代码也被注释掉了。decodePayload函数返回的只是一个纯字符串,因此调用者根本无法从中恢复出语言信息。“这份记录使用的是哪种语言?”这个问题,正是设置语言字段的意义所在。
这个“待处理”的问题其实非常重要。无论什么情况,UTF-16格式的文本记录都会被解码成UTF-8格式,结果就会产生一些交错的NUL字符。
str += String.fromCharCode(ch);String.fromCharCode函数只会保留字符的低16位字节,而一个表情符号显然无法被表示为16位二进制数据。所以我尝试使用它来处理一个表情符号:原始字节序列:68 69 20 f0 9f 98 80
预期输出结果:hi 😀
但实际上输出的结果是:“hi “,因为代码中使用了U+F600这个私有的Unicode字符
U+1F600这个字符在显示时是不可见的。对于那些由多字节组成的字符序列(比如阿拉伯文和汉字),这种问题并不会显现出来,因此这个漏洞在人们没有使用表情符号之前根本不会被发现。
不过,这个库中的URI解码器只有8行代码,而且功能完全正确。这种不对称性才是真正有趣的地方。这个库本身并不是一个坏库,只是其中有两个部分已经过时了。只有通过实际阅读代码,才能分辨出哪些部分是有效的,哪些部分需要更新。
所以我重新编写了解码器,同时保留了这个库中那些用于与硬件交互的部分。整个解码器的代码长度约为530行,全部是用纯TypeScript编写的,也没有引入任何React Native的相关代码,因此它可以在Node环境中运行,测试速度也非常快。
它的作用就是将一条记录转换成几种已知格式中的一种,而下面这个类型定义正好描述了这一功能:
export type NdefView =
| { kind: 'empty' }
| { kind: 'uri'; uri: string }
| { kind: 'text'; text: string; lang: string; encoding: TextEncodingName }
| { kind: 'mime'; mime: string; text?: string; bytes: number[] }
| { kind: 'aar'; packageName: string }
| { kind: 'unknown'; tnf: number; type: string; payload: number[] };
为什么选择使用多个结构组合的方式来表示数据,而不是创建一个包含大量可选字段的单一对象呢?因为如果使用可选字段,每个处理这些数据的系统都必须自行判断哪些字段已经被填充了。而在这里,你只需要检查一次kind字段,TypeScript就能自动理解其余的信息。对于那些kind值为'text'的记录来说,.uri字段根本不存在;因此,如果某个系统试图读取这个字段,就会导致编译失败,而不会向使用该系统的用户显示undefined这样的结果。
对于那些无法被识别为哪种类型的记录,unknown类型至少还能以十六进制字节的形式展示出来。相比之下,那些默默忽略自己不理解的部分的解析工具,其实比那些只是简单显示“我不知道这是什么,以下是对应的字节数据”的工具更糟糕。
在某些平台上,解码机制本身也存在差异:在Android系统中,记录中的type字段是以原始字节的形式出现的;而在iOS系统中,这个字段有时已经被解码成了字符串。因此,同一个URI记录在某个平台上可能表现为[85],而在另一个平台上则可能表现为'U'——因为85这个字节正好代表字母“U”。
这种差异非常重要,因为[85] === 'U'这种比较显然是不成立的。这种情况下既不会出现错误提示,也不会有警告信息;只是简单的比较就会失败,从而导致原本正常的URI记录被错误地识别为“未知类型”。因此,在进行比较之前,无论在哪个平台上,都应该先将type字段转换为字符串形式。
与被替换的部分进行对比测试
这种测试方法正是我希望大家能够借鉴的。这些测试分为三组。
正确性测试:通过手工生成的数据来验证解码器的正确性。
一致性测试:当库的正确结果与我们自己的解析结果完全一致时,就需要进行这种测试。我们需要使用库编码的12个真实URI地址,并由我们自己进行解码;同时还要检查所有的前缀索引是否正确。对于那些自己手动编写的查找表来说,这种测试是一种验证其准确性的简单方法。
差异性测试:这种测试比较特殊——当库的解析结果出现错误时,我们需要编写专门的测试用例来详细记录这种错误的具体表现形式:
✓ 库会忽略语言代码;而我们会保留它
✓ 库会截断4字节的UTF-8编码;而我们不会这样做
✓ 两者都会处理3字节的字符序列,但只有U+FFFF以上的字符才会导致解析错误
✓ 库会忽略UTF-16标志;而我们会尊重这个标志
从表面上看,这些测试似乎是在故意寻找库中的错误;但实际上,通常情况下,这种情况反而说明库存在问题。
有两条理由使得这种测试方法非常有价值:首先,它们清楚地记录了为什么需要编写自己的解码代码;其次,由于这些测试用例直接验证了库当前的运行行为,因此一旦上游的开发者修复了库中的错误,这些测试就会立即失败。
这种失败的后果恰恰正是我们想要的——它并不是一个有问题的测试用例,而是一种提醒:你之前编写自定义解码代码的原因可能已经消失了,现在你需要去检查一下。相比之下,那些只是简单写着“库存在漏洞”的注释,在库被修改后只会被忽略掉;而测试用例却能确保这种信息被及时传递出去。
有一个细节决定了这些测试是有用还是无用。在表情符号相关的测试中,系统会明确指出确切的错误答案,也就是代码点0xf600,而不仅仅是“某个库与我们存在分歧”而已。
如果测试仅检查是否存在分歧,那么未来版本中如果出现了不同的错误,该测试仍然会通过,你也就永远不会注意到其行为已经发生了变化。但通过指定这个具体的错误值,无论上游代码是否修复了该错误,或者用新的错误替换了原有的错误,任何变化都会被检测出来。
检查点: git checkout step-2-decode。此时会使用自定义的解码器,标签信息界面也会显示每个字段的内容以及原始字节数据。
如何创建标签
现在来看另一种情况。其实有两种选择,它们代表的是截然不同的处理方式,而不是简单的变体而已。
URL记录体积非常小,而且任何手机都能直接打开它,无需安装任何应用程序。大多数商业NFC名片都是采用这种格式的。不过,这种格式也需要相应的支持环境:域名必须能够持续更新,服务器必须保持正常运行,而且在用户进行触碰操作时,网络连接也必须处于可用状态。
vCard则包含了更丰富的信息。text/vcard作为一种MIME记录格式,它不需要依赖服务器,可以在各种设备上使用。不过,vCard的体积也要大得多。
我同时提供了这两种格式,让用户自己进行选择,因为通过具体的数据对比,这些差异会比单纯的文字描述更加直观明了。
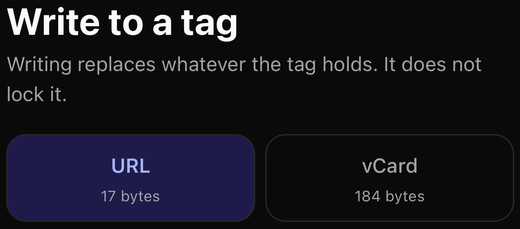
同样的联系信息,URL格式仅占17字节,而vCard格式则占184字节。这种差异实际上代表了两种完全不同的处理方式,因此用户需要自己来做出选择,而不是由系统替他们做出决定。
如何编码vCard
vCard其实只是文本而已。应用程序实际写入标签的内容就是这样的:
BEGIN:VCARD
VERSION:3.0
N:Doe;Jane;;;
FN:Jane Doe
ORG:Example Ltd
TITLE:Full-stack engineer
TEL;TYPE=CELL:+15550100
EMAIL;TYPE=INTERNET:jane@example.com
URL:https://example.com
END:VCARD
每行只包含一个字段:名称、冒号、值,最后再加上回车符和换行符。将这些内容组合起来,就能得到一个有效的vCard标签。
这种格式起源于20世纪90年代,不过其中有三条规则很容易被忽略或误解。因此,你的编码程序必须能够正确处理这三条规则。
1. 长行应按字节进行分割,而不是按字符。
任何长度超过75字节的行都必须被拆分,并在下一行继续显示,开头需要加上空格。虽然可以使用line.slice(0, 75)这种方法来截取前75个字节,但这种方法其实是按照字符数来计算的,因此如果某个字符串中包含多个字节长的字符,这种方法就会导致标签中的数据无效。正确的做法应该是按照代码点来遍历字符串,同时记录每个字节的长度。
2. 发送 `N`,并明确说明你只是在进行猜测。
看看那行 `N:`。vCard 3.0要求将名字拆分为 `家庭名;名字;附加信息;前缀;后缀` 这几部分,因此仅仅发送 `FN` 是不够的。对于中文和匈牙利语的名字、那些有两个姓氏的西班牙语名字,以及那些只使用一个名字的人来说,将显示名称拆分成这些部分实际上是一种猜测行为,而这种猜测往往是错误的。我会记录下这一猜测结果,并让进口工具实际显示的 `FN` 保持用户输入时的原样。
3. 将值中的每个分号都进行转义处理。
在那一行 `N:` 中,那些分号是用于表示结构信息的。如果某人的职位是“Engineer; Lagos”,如果直接将这一字符串写入数据中,就会导致一个字段被分割成两个部分,而进口工具会误将其余内容视为名字的一部分。因此,这些分号必须以 `Engineer\; Lagos` 的形式存在。
只要把这三点处理正确,整个编码程序就只需要大约170行代码来处理字符串相关操作,而且完全可以在不使用任何标签的情况下进行测试。
那个通过了所有测试的转义错误
第三条规则正是我遇到的最严重的错误所在。我的转义函数中有这样一行代码:
.replace(/;/g, '\;') // ← 这行代码并没有对任何分号进行转义处理
vCard要求在值中的每个分号前面都必须加上一个反斜杠。`'\;'"` 看起来似乎是可以达到这个目的的,但实际上并非如此。JavaScript中并不存在 `\;` 这样的转义序列,因此它只会忽略掉反斜杠,直接返回普通的 `';'`。这样一来,这一行代码实际上就是将所有的分号都替换成了它们本身。
正确的解决方法应该是使用 `'\\\;'"`,这样第一个反斜杠就可以用来转义第二个反斜杠了。
后来情况变得更糟了。我为这个转义函数编写了一个测试用例,并期望它能够输出未经过转义的原始数据,因为我认为那一行代码是有效的。然而这个测试用例反而暴露了这个错误,也就是说,如果使用正确的代码,这个测试用例反而会失败。
后来我又写了第三个测试用例,试图通过 `not.toContain('N:')` 来判断某个字段是否不存在。但这个测试永远都不会通过,因为所有的vCard文件都是以 `BEGIN:VCARD` 开头的,而 `BEGIN:` 这一行也必定以 `N:` 结尾。
十分钟内就犯了三个错误,原因都在于对规则的理解有误。
如果先进行测试的话,我是不会犯这些错误的。因为我和测试代码都基于同一个假设:在处理字符串时确实需要对其进行转义处理。
在向标签写入数据之前,先确认一下它的属性
任何写入操作都会替换芯片中原有的数据,因此顺序非常重要:
1. 首先查询标签的属性:它是否可以被写入,其实际容量是多少?
2. 如果发现标签是只读的,或者容量太小,就应该立即停止写入操作。
3. 然后进行写入。
4> 写入完成后,再读取数据,确认它是否与之前发送的数据一致。
第二步才是确保数据安全的关键。如果在写入操作之前就发现标签无法被修改,就可以避免对标签造成任何破坏;而如果在写入操作进行中出现错误,至少也可以防止数据被部分地写进去。
步骤4的存在,正是因为那种报告了“操作成功”但实际上并未真正发生写入操作的情况,才是最糟糕的结果。需要在同一会话中重新进行读取操作,并且比较记录的内容,而不是原始的字节数据。实际上,某个标签在发送完全相同的数据时,其返回的信息格式可能与你发送时的格式不同。
这四个步骤都需要在同一个会话中完成,而不能分开进行。在iOS系统中,每个`requestTechnology`请求都会在用户面前弹出系统提示窗;因此如果将这四个步骤分开处理,就意味着需要弹出四个提示窗,并且用户需要进行四次点击才能完成同一个操作。而在Android系统中,系统并不会注意到这种差异——正是这种差异,使得在iOS平台上设计出来的界面看起来显得有些随意,直到你在其他平台上看到同样的设计时才会明白其中的原因。
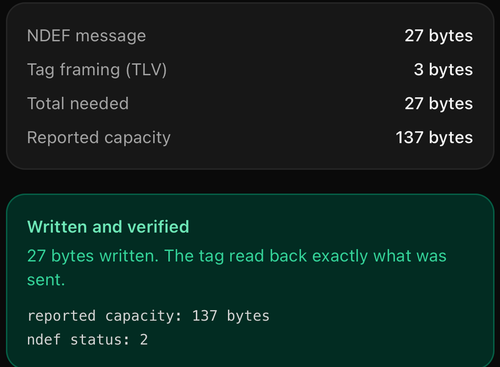
在这一个界面中,你可以看到全部四个步骤:首先向标签发送请求,然后接收返回的数据并进行测量(而不是基于假设进行计算),接着执行写入操作,最后通过读取操作来确认数据是否确实被正确地存储了下来,而且每一字节的数据都得到了验证。
检查点: 使用`git checkout step-3-write`命令进入相关代码目录。使用配置文件编辑器进行设置,采用vCard格式进行编码,并在写入数据之前先检查所需的存储空间是否足够。
容量够吗?137字节,而不是144字节
在这个过程中,这个项目让我学到了很多东西。
NTAG213标签具有144字节的用户可用存储空间。这个数值在所有的技术规格说明中都有明确记载:总共36页,每页占4字节,也就是第4页到第39页。我正是根据这个数值来设计容量检查机制的。
一个普通的名片所包含的信息(姓名、头衔、公司信息、电话号码、电子邮件地址以及一个链接)大约需要184字节的文本空间;而当这些信息被封装成NDEF格式的消息后,总大小会变为202字节,这就是前面提到的那个数值。
因此,普通的名片是无法存储在普通的NTAG213标签上的。这是一个真实存在的产品限制,并非软件故障;应用程序必须明确说明这一点,而不是让用户遇到莫名其妙的问题。
不过我的计算结果是错误的。当我最终去测量一个真正的NTAG213标签的容量时,发现它实际上只有137字节的存储空间。
144字节这个数值指的是芯片的用户可用存储空间;而对于开发者来说,真正重要的数值是NDEF消息的最大长度。由于标签本身会进行一些额外的数据存储处理,所以实际可用的存储空间要比144字节小。我之前的计算结果多算了7字节,这就导致我认为名片可以存储在标签上,但实际上是不行的。
这个错误还隐藏了另一个问题:标签并不会直接存储你发送的消息,而是会用一些额外的字节来对消息进行格式化处理,这种格式化信息被称为TLV格式,用于说明数据的类型、长度和实际内容。我在计算存储容量的时候,把这些格式化字节也算进去了,因此导致了重复计算。实际上,所有被用来计算存储容量的数值(比如Android系统的`getMaxSize()`方法返回的值、iOS系统的状态查询结果,以及一些合理的假设值)都已经包含了这些格式化字节,也就是说,这些数值其实已经代表了“排除格式化信息后的消息大小”了。
更大的错误
比这个数字本身更糟糕的是,我对这个平台的判断是错误的。
因为iOS的getTag()函数只返回{ id, tech }这两个字段,所以我得出了“iOS无法检测标签的实际容量”这个结论。我在代码中、在平台对比分析中,以及应用程序的用户界面中都写了这一点,并且还计划开发一个专门的模块来弥补这一缺陷。最终,这个模块也被成功集成到了应用程序中:
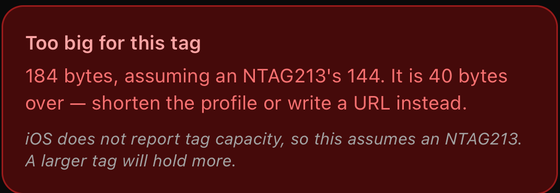
那条用斜体字写的说明实际上是一个错误的结论,但却被当作事实呈现给了用户。上面那张提示卡片中的所有数据其实都是基于这个错误假设得出的。
这种判断是错误的。ndefHandler.getNdefStatus()函数——也就是CoreNFC的queryNDEFStatus方法——在当前会话进行过程中,就能同时返回标签的读写状态以及其实际容量。其实,这个功能早在几周前我就已经掌握了。
让我们来看看这个错误的形成过程:
我的错误认知:认为只有一个函数getTag()能够获取标签信息,而这个函数并不提供标签的容量信息。这是事实吗?
我的错误结论:因此我认为iOS无法告诉用户标签能存储多少字节的数据。但这种推理是错误的。
一个函数没有回答某个问题,并不意味着整个平台都无法提供这个信息。就好比我尝试打开一扇门,发现它锁着,就认为根本无法进入这栋建筑一样。
对于这个项目,我的原则是:在任何情况下,只有当我在实际设备上验证过某个结论后,才会将其记录下来作为事实。但在测量数据时,我遵循了这个原则;而在根据测量结果得出结论时,我却忘记了这一原则。
一个未经验证的结论,与一个未经核实的数字一样危险,而且更难以被发现,因为这样的结论会借助那些经过验证的数据来增加自身的可信度。
所以现在,应用程序会在询问标签信息后,只有在没有收到任何回应的情况下,才会假设标签的容量为默认值。每当出现这种假设时,应用程序都会明确说明这一点:
该标签容量过大。应为137字节,但实际上有202字节,超出65字节的限制。请缩短数据格式或使用链接。
目前还没有标签返回其实际容量信息,因此这里默认使用NTAG213类型标签。当您向标签写入数据时,标签会自动显示其真实容量。
每当数值是经过假设得出的时候,都会出现“应为……”这样的字样。这种表述方式其实是故意设计出来的:一旦应用程序不再强调这一点,读者就会误以为这些数值确实是经过实际测量得出的。
下面是当标签已经返回了其容量信息后,同样的提示卡片会显示什么内容:
![红色错误提示,内容为“该标签容量过大。该标签报告的容量为137字节,但实际上有202字节,超出65字节的限制。请缩短数据格式或使用链接。” height="400" loading="lazy" src="https://cdn.hashnode.com/uploads/covers/66c84fbe8c8c80534346db05/716bffb6-f7e0-4c24-966f-e93cae6e08b1.png" style="display: block;" width="600"/><p>“这个标签报告了……”而不是“假设这是一个NTAG213标签”。同样的卡片,相同的布局,唯一发生变化的那一句话,就是用来说明该编号是来自芯片还是由我手动输入的。</p>
<h3 id="heading-a-bug-that-made-this-harder-to-find">一个导致该问题更难被发现的漏洞</h3>
<p>在飞行前的检查过程中,当有消息无法被完整显示时,<strong>该库自身提供的</strong><code>TagSizeTooSmall</code>错误会被触发。因此,当写入操作失败时,系统会显示<code>TagSizeTooSmall</code>这个错误信息,而这正是CoreNFC在拒绝执行写入操作时会显示的内容。</p>
<img alt="应用程序的写入界面。数据显示:NDEF消息占202字节,标签帧格式占3字节,总共需要205字节的存储空间;假设该标签的最大容量为144字节。下方有一张红色提示卡,上面写着“尺寸过大,无法存储”,点击后会显示开发人员提供的详细信息,其中会显示NfcError.TagSizeTooSmall错误以及相应的提示信息:“(空)”。</p>
<p>在那个开发工具面板中,有两项内容:<code>NfcError.TagSizeTooSmall</code>是该库自带的异常类型,它是在我的代码开始执行之前就被触发的;而<code>message: „“ (空)</code>则反映了这一错误背后的真正原因——实际上这个异常类型已经包含了所有需要传达的信息,但屏幕上显示的那一串空字符串却没有任何实际意义。</p>
<p>无论是我的代码还是标签本身产生的错误信息,内容都是完全相同的。而我试图回答的那个问题(即该平台是否真的报告了标签的容量信息?),恰恰被这个错误信息给掩盖掉了。</p>
<p><strong>绝对不要在自己的逻辑代码中直接使用依赖库所抛出的错误类型。</strong>这样做会使得“我的代码拒绝了操作”和“标签本身拒绝了操作”这两种情况被混为一谈;而当真正出现问题时,你却需要准确区分这两者。</p>
<p>如果为这种错误专门定义一个包含标签实际容量信息的错误类型,那么答案就会立刻显现出来:</p>
<pre><code class="language-text">WritePreflightError: 尺寸过大
标签报告的容量为2字节,实际需要202字节的存储空间</code></pre>
<p>原来如此,该平台其实一直在报告标签的实际容量信息。</p>
<p>同样的界面,相同的芯片,在修复前后显示的内容也完全一样:</p>
<img alt="修复前的应用程序标签信息界面。容量一栏显示“未报告”,并附有说明“CoreNFC不提供标签容量的相关信息”,同时提示后续会从标签的容量存储区域中读取该信息。” height="400" loading="lazy" src="https://cdn.hashnode.com/uploads/covers/66c84fbe8c8c80534346db05/a39df4b8-8df2-48e5-b8ff-8a0be5848670.png" style="display: block;" width="600"/>
<img alt="修复后的应用程序标签信息界面。容量一栏现在显示为137字节,并标注“由标签本身报告”;NDEF类型一栏仍显示“未报告”,并附有说明“CoreNFC不显示NDEF类型的名称”。下方还列出了标签的相关信息,如记录编号、是否可写入、芯片型号为NTAG21x / MIFARE Ultralight,其UID为7字节。” height="400" loading="lazy" src="https://cdn.hashnode.com/uploads/covers/66c84fbe8c8c80534346db05/3e9b42f9-fee3-4f2f-8951-7b9f54a2c092.png" style="display: block;" width="600"/><p>在第一份报告中,“容量”这一项下列出的所有内容都是我编写的,但其中那些自信满满的说法其实是错误的。而下面那条蓝线所代表的情况更为糟糕:原本是为了填补根本不存在的差距而安排的一系列工作,最终却白费力气了。</p>
<p>第二份报告里标注了一个数字,说明这个数字是“由标签本身提供的信息”,而在那之后平台上并没有添加任何新的内容。不过需要注意的是,有些东西其实并没有发生变化。“NDEF类型”这一项仍然显示为“未提供数据”,因为这种信息确实是无法获取的。这就是为什么我会长期误以为某些事情是正确的,而实际上平台根本无法回答这些问题的原因。</p>
<h2 id="heading-a-focus-session-you-cant-end-without-the-tag">一个离不开标签的专注会议</h2>
<p>名片固然可以用来演示这个功能,但它只能发挥标签作用的一半潜力。另一半作用在于将芯片作为一种“物理条件”来使用:也就是说,在现实世界中必须满足这些物理条件,软件才能执行相应的操作。</p>
<p>因此,这款应用还具有另一个功能:一个专注计时器,如果你不想结束会议,就必须回到那个标签所在的位置。</p>
<p>你可能会把芯片放在不方便拿到的地方,比如楼下的抽屉里或者橱柜的后面。想要开始会议,就需要点击这个芯片;而要结束会议,也必须回到它所在的地方。</p>
<p>这个想法并不是我提出的。<a href="https://github.com/awaseem/foqos">Foqos</a>(开源项目,在App Store上可以下载)、<a href="https://github.com/cajdata/TapBlok/">TapBlok</a>、nfcGuard以及Focusaur这些项目都采用了这个理念,而他们之所以会采用这个理念,是因为其实这与NFC技术本身并无直接关系:</p>
<p><strong>真正造成障碍的因素是地理位置,而不是操作手势。</strong>点击芯片确实需要花费一秒钟的时间,但真正让你感到不便的是标签位于楼下的地方。标签的“位置”才是决定整个系统能否正常工作的关键因素,而NFC技术只不过是让这个位置信息能够被有效利用的一种手段而已。</p>
<p>由此可以得出三条规则,每一条规则都对应着一行代码。</p>
<h4 id="heading-1-one-tag-two-meanings">1. 一个标签,两种含义</h4>
<p>当应用程序处于空闲状态时,同样的点击操作会启动会议;而当用户开始专注工作时,同样的点击操作则会结束会议。如果使用两个不同的标签,那就意味着需要记住两个不同的位置,并养成两个不同的习惯。不过所有的决策其实都包含在一个简单的函数中:</p>
<pre><code class="language-ts">export function verdictForTap(
scannedTagId: string,
boundTagId: string | null,
isFocused: boolean
): TapVerdict {
if (!boundTagId) return { action:]()
“wrong-tag”这条规则是整个系统正常运行的基础。如果接受任何标签都可以使用这个功能,那么这个过程就变成了“拥有一个贴纸”,而不是“去找到那个贴纸所在的地方”。
对标签信息进行规范化处理的重要性远超人们的想象。同一个物理芯片,通过不同的读取方式可能会被识别为04C4FC91DF2A81或04:c4:fc:91:df:2a:81。如果将这些不同的识别结果视为不同的标签,就会导致严重的错误:你手中拿着的正确芯片,也可能因为读取方式的不同而被系统拒绝识别。
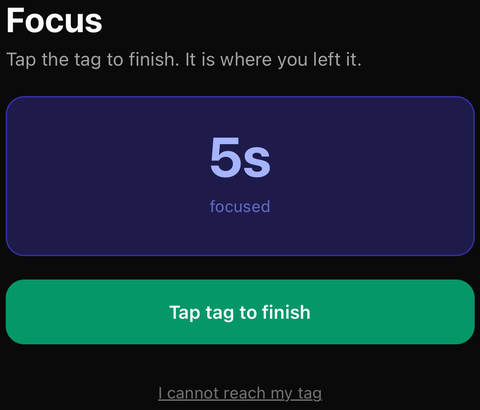
那个绿色按钮并不会终止任何操作,它只是启动扫描流程,而真正结束会话的是这个扫描过程本身。在它的下方,以较为低调的方式显示着通往机场的出口信息。
2. 计时器是向上计时的,永远不会倒计时。
如果选择倒计时,那么你就可以坐在沙发上等待会话结束;无论你是否采取了任何行动,会话都会自动终止。而向上计时的方式则能真实反映实际发生的情况。
3>会话中断时,系统会进行记录,而无法阻止这种情况的发生。
这就是这个设计的有趣之处所在。
它实际上能够强制执行什么
它无法屏蔽TikTok。在iOS系统中,要真正禁止某个应用程序的运行,就需要使用com.apple.developer.family-controls这个权限设置。这是一个由苹果公司单独审核并仅授予那些以保障用户数字健康或提供家长控制功能为目的的应用程序的特权;即便是用于测试环境的TestFlight也需要这个权限。Focoos应用程序拥有这个权限,但如果你按照本手册的操作来进行设置,那么你的应用程序很可能没有这个权限。因此,如果有人承诺可以屏蔽某些应用,那肯定是一个无法兑现的承诺。
所以,它实际上能够强制执行的只有一件事:对会话记录的保存。
虽然提供了一个“逃生通道”,但如果你在机场真的遇到了麻烦,第一次使用这个功能时,就会留下永久性的痕迹——系统会记录这次会话是提前结束的。这个痕迹是永久存在的,每次你打开这个应用程序时都会看到它。
而“会话记录本身”才是真正需要被保护的对象,因为这是这个应用程序中唯一值得用户自己加以保护的资料。这种保护机制是不对称的:
查看记录
始终免费。关键在于你可以随时查看这些记录。
添加新记录
只有在实际进行了会话操作后,才能添加新的记录。
清除记录
清除记录需要特定的标签。
如果你在晚上11点坐在沙发上选择清除记录,那么实际上什么记录都不会被删除。而清除这些记录所付出的代价,恰恰就是当初创建这些记录时所花费的时间和精力。
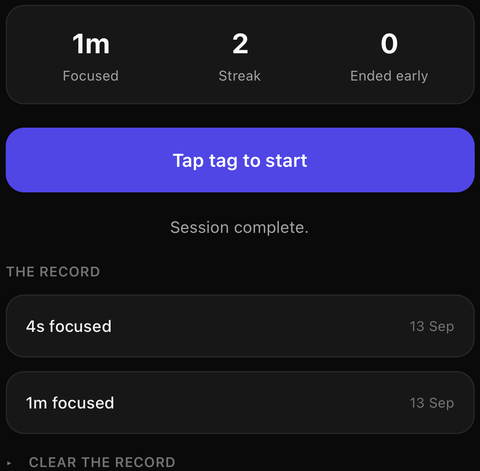
无论你是否有过专注会话的经历,“提前结束”这一栏都会被显示出来,这就是这个设计的意义所在。这一栏会永久地出现在界面中,因此在使用“逃生通道”之前,你就会清楚地知道使用它所带来的后果。而“清除记录”这个选项则位于界面的最下方,是这个应用程序中唯一需要特定标签才能执行的操作。
还有两个看似微不足道的设置,实际上却非常重要。正在进行的会话在重新启动后仍然会继续存在,因为这些会话数据会被保留下来;因此,强制退出应用程序并不能真正逃避这些规则。能够结束会话的唯一方法就是使用特定的标签或“逃生通道”,而其中任何一种方法都会留下痕迹。
即使会话中断,这些时间仍然会被计入总专注时长中,因为在你真正失去专注状态之前,你确实处于专注状态。将这类时间重置为零既不公平,也不准确。
相比之下,“连续专注时长”机制的设计更为严格:一旦会有会话中断,该时长就会被重置为零。一个不可能丢失的数值其实没有必要被记录下来。
编译器发现的两个React漏洞
这两个漏洞都属于React通用层面的问题,并非与NFC功能相关,而且它们都不是我发现的。React编译器通过eslint-plugin-react-hooks提供了相应的代码检查规则,这些规则能够标记出那些无法被安全优化的代码片段,而这两个漏洞就是通过这些规则被检测出来的。你并不一定需要使用React编译器才能遇到这些问题。
const [now, setNow] = useState(Date.now()); // ✗ 在渲染过程中使用这个函数会导致代码不纯
这就是purity规则所针对的情况:Date.now()与Math.random()、crypto.randomUUID()一样,都被归类为“对于相同的输入会返回不同结果的API”。在渲染过程中不断获取当前时间会导致组件每次渲染时都产生不同的输出结果。
一个显而易见的解决方法是在效应函数的开头设置这个时间值,但这样做又会违反另一个规则。set-state-in-effect明确指出:“在效应函数内部立即设置状态会迫使React重新开始整个渲染流程”,从而导致“不必要的额外渲染”。
purity规则推荐的解决方案是使用延迟初始化的方式,即useState(() => Date.now())。对于一个在组件挂载后才开始运行的计时器来说,这种实现方式确实是正确的。因为计时器并不是在组件挂载时就开始运行的,而是在某个会话开始时才开始计时,所以如果在挂载时就获取当前时间,得到的结果就会失效;而使用延迟初始化的方式就可以避免这个问题。
将初始值设置为0既符合“代码纯度”的要求,也能作为一个有效的提示信号:当值为假时,说明“还没有开始计时”,因此界面上就不会显示无意义的数值。
那种既正确又简洁的实现方式是将计时操作延迟到某个特定的时机执行:useEffect(() => {
if (!session) return;
// 延迟执行而不是立即调用:在效应函数内部直接使用setState会导致额外的渲染操作;
// 而通过设置0毫秒的超时时间,可以让这个操作被推迟到下一个任务执行,
// 这样就可以避免不必要的额外渲染。
const first = setTimeout(() => setNow(Date.now()), 0);
const id = setInterval(() => setNow(Date.now()), 1000);
return () => {
clearTimeout(first);
clearInterval(id);
};
}, [session]);
为什么你的NFC锁并不安全
“专注时长”功能会使用标签的标识符作为键值对来进行存储。大多数NFC“锁屏”应用也是采用这种方式。有必要明确说明这种做法的优缺点是什么。
标签的UID是全世界都能看到的,而且很容易被复制。它并不是什么秘密——本质上就是一个序列号,任何请求获取该信息的人都会得到这个编号。
正如第一节所提到的,苹果自己开发的快捷键功能也是基于这一原理运行的。这说明,平台本身是如何评估这种安全性的:对于“打开我的台灯”这样的操作来说,使用UID是完全可行的;但它从来不会被用作身份验证的依据。一个价值20英镑的设备可以在几秒钟内复制出一个UID,而手机甚至可以直接模拟一些这类功能。因此,如果一个访问系统仅仅依靠“这个UID是否正确”来进行安全控制,那简直就是天方夜谭。
对于需要设置定时器的场景来说,使用UID是完全没问题的。值得强调的是:这种安全机制实际上是在考验你在自己家里是否会偷懒——为了逃避锻炼而复制自己的标签,这样的做法反而违背了设定这个机制的初衷。制造一些阻碍才是真正的安全措施,而不是仅仅依靠防止复制来保障安全。
但如果你真的把标签当作一种身份验证手段来使用(比如用来开门、进行支付或配对设备),那么UID这种格式就完全不够用了。你需要的是一种能够执行加密操作的芯片。
通常情况下,NTAG424 DNA芯片就是解决方案。这种芯片不会直接提供一个固定的数字,而是会利用内置的密钥,在每次标签被扫描时计算出一个随次数递增的消息认证码。因此,每一个扫描结果都是独一无二的,一旦被截获,瞬间就会失效。这就是标识符和认证器之间的区别。
所以,关键在于要明白:UID的作用仅仅是用来回答“这是哪个标签?”这个问题而已。如果你的安全需求依赖于这个编号的不可伪造性,那么你需要的就是一种能够生成签名信息的芯片,而不仅仅是一个能显示数字的芯片。
四个让我每晚都要花几个小时去解决的麻烦问题
这些问题的每一个乍看之下都像是我代码中的错误,但实际上都是平台本身的特性导致的。
问题1:系统界面会无缘无故地消失
当你开始扫描标签时,系统界面会出现一会儿,然后立刻消失。没有任何错误提示,也没有任何拒绝信号,控制台里也看不到任何相关信息。
这是因为CoreNFC会话被释放掉了。在Swift语言中,一旦没有变量引用某个对象,这个对象就会被自动释放——这就是自动引用计数机制的作用。因此,如果你把会话保存在启动扫描操作的函数中的局部变量里,那么当函数执行完毕时,这个变量也会被销毁,随之会话也会被清除。
为了解决这个问题,你需要把会话保存在一个在函数执行结束后仍然存在的对象中。在Expo模块中,可以使用以下方式来实现:
// 该会话会在整个模块的生命周期内保持有效,而不会随着扫描操作的结束而被清除。
private var readSession: Any?问题2:你的扫描结果会被会话结束操作覆盖
当你成功读取了一个标签的信息并完成了相关处理后,JavaScript却会收到错误信息。
这是因为成功的读取操作也会导致会话被关闭,所以didInvalidateWithError这个方法会在你的完成处理函数之后被执行。如果两个不同的路径都会导致同一个结果,那么后执行的那个操作就会覆盖之前的结果。为了解决这个问题,需要确保某个操作只执行一次。即:一个锁,一个地方:
private func settle(resolving value: [String: Any]) {
lock.lock()
defer { lock.unlock() }
guard let promise else { return } // 如果已经完成解析,则什么都不做
selfpromise = nil
promise.resolve(value)
}
由于这里存在四个嵌套的异步操作步骤以及五条可能导致失败的路径,因此必须严格执行这一规则,而不能仅凭假设来处理问题。
问题3:你已经拥有的某个权限实际上“缺少所需的权限”
你的权限配置中包含了NDEF和TAG,但会话仍然无法启动。
造成这种问题的原因是轮询选项——也就是你在打开会话时告诉CoreNFC应该监听哪些无线电标准。每一个标准都需要对应的权限才能被使用。我请求使用了[.iso14443, .iso15693, .iso18092],其中最后一个标准是FeliCa,这种标准主要在日本使用,而使用它还需要com.apple.developer.nfc.readersession.felica.systemcodes权限。如果没有这个权限,整个会话都会失败,而错误信息中并不会明确指出“是FeliCa导致了问题”。
为了解决这个问题,只需要请求那些你确实有权限去处理的选项即可:
pollingOption: [.iso14443, .iso15693]
.iso14443涵盖了NTAG和MIFARE,这些正是任何标签项目所需要的标准。我当初添加了第三个选项,结果却导致会话无法启动——因为有些不常见的标签会导致错误信息出现。
这与之前遇到的“通配符配置文件导致的错误”是同一个道理,只不过问题的表现形式不同而已:在那种情况下,是“缺少某个权限”导致了签名失败;而在这里,则是本来不需要的权限在运行时被要求使用了。
问题4:对于一个确实存在的文件,编译器却提示“找不到‘YourClass’这个类”
你将一个Swift文件添加到本地的Expo模块中,然后进行构建,但编译器却提示该类不存在。
造成这种问题的原因是iOS依赖关系的管理方式。CocoaPods是负责管理这些依赖关系的包管理工具,每个依赖项都会附带一个podspec文件,这个文件列出了该依赖项所包含的所有源代码文件。你的项目中,podspec文件中可能写着“这个文件夹中的所有.swift文件”,也就是**/*.swift这样的写法。
问题在于:CocoaPods在执行pod install命令时,只会将这个通配符模式解析一次。由于这是一个静态的规则列表,之后你添加的任何文件都不会被包含在这个规则中,因此编译器认为你的类确实不存在。
为了解决这个问题,请记住这个规则,以后不要再为此浪费时间了:
如果是在现有的文件中添加一个函数,就需要重新构建项目;如果是添加一个新的文件,则应该先执行pod install命令,之后再重新构建项目。
错误信息中并没有提到这两点。
为什么无法实现“触屏支付”功能
正是在这里,这两个平台之间的差异已经不再仅仅是程度上的区别了。在向产品经理做出任何承诺之前,你必须了解这一点。
“触屏支付”实际上代表着两种不同的含义。
首先,有一种是用手机进行支付:比如Apple Pay,或者Google Wallet中的银行卡功能。在iOS系统中,相关的安全组件是被关闭的,也没有任何第三方API可供使用——既没有相应的权限,也不具备这样的功能。
其次,还有一种是通过手机接收付款请求:例如iPhone上的“触屏支付”功能,或者ProximityReader框架。虽然这些技术确实存在,但要想真正将其集成到应用中,仍然需要满足许多条件:
需要拥有机构级开发者账户,并且要以账户持有者的身份进行申请。
需要分别申请测试版权限和正式上线权限。
苹果会根据预先设定的标准进行审核,而获得正式上线许可可能需要数周时间。
必须通过经过苹果认可的支付服务提供商来进行集成,比如Stripe、Adyen或Square。
现在来看Android系统。HostApduService允许任何应用程序模拟银行卡的功能。无需任何审批流程,也不需要特定的权限或支付服务提供商的支持——只需实现processCommandApdu()方法并注册你的AID即可。AID其实就是应用程序标识符,支付终端会根据这个编号来决定应该让手机上的哪个应用程序进行处理。
不过这里确实存在一个关键限制:只有在你的应用程序被设置为默认钱包应用(在Android 15及更高版本中),或者处于前台状态并调用了setPreferredService方法时,那些注册在CATEGORY_payment类别下的AID才能正常使用。而那些用于封闭式支付卡、会员积分系统、访问控制功能或存储值服务的AID,则始终是可以被使用的,且无需任何特殊审批。
iOS
Android
模拟银行卡功能
无法实现
可以使用HostApduService,无需审批
支付相关的AID
N/A
需要设置为默认钱包应用才能使用
非支付相关的AID
N/A
可以随时使用
接收付款请求
需要权限、支付服务提供商的支持,且审批过程可能需要数周时间
可以随时使用
与本手册中提到的其他所有差异不同,这种差异并不是程度上的或形式上的区别。简单来说,其中一个平台根本就不具备实现这一功能的能力。如果你的产品计划中包含了让手机模拟银行卡的功能,那么这个方案只适用于Android系统;最好现在就了解这一点,而不是等到开发周期快结束的时候才发现这个问题。
为什么你需要自己编写原生模块
到目前为止,本项目中的所有功能都是通过react-native-nfc-manager来实现的。但在项目的最后阶段,我们更换了这一依赖库,而且原因也在开发过程中发生了变化。
最初的理由是容量检测方面的问题:iOS本身无法提供容量的详细信息,因此我们需要编写自己的原生代码来读取这些数据。但正如你们所见,这个理由已经站不住脚了——那其实只是一种推论,并非事实依据。因此,我们不应该默默地让这些带有缺陷的代码继续存在下去。事实上,有些团队确实无法使用第三方依赖项。某些内部政策、审计要求,或者某些包,根本无法在合理的时间内得到修复并合并到项目中来。对于“我该如何自己实现这个功能?”这个问题,确实值得认真思考。
至于这个特定的依赖项,相关的证据早已被收集到了——通过阅读相关代码就可以发现这些问题:
问题所在
出现位置
文本解码器会忽略它刚刚检测到的语言编码
ndef-lib/ndef-text.js
忽略了UTF-16标志,这是一个待解决的缺陷
ndef-lib/ndef-text.js
String.fromCharCode方法在处理U+FFFF以上的字符时会截断结果ndef-lib/util.js
index.d.ts文件是无效的TypeScript代码,之所以能编译通过,只是因为启用了skipLibCheck选项index.d.ts
在非原生运行环境中使用该包时会出现错误
src/NativeNfcManager.js
所有的错误类都包含一个空的message字段
src/NfcError.js
最后那个问题在测试阶段导致了严重的故障:扫描失败后,屏幕上根本不会显示任何内容,因为error(err.message)这一代码会返回空字符串,而React会将空字符串视为错误。这个问题的存在其实只是因为在代码中定义了错误的处理方式而已。
这些问题都无法通过JavaScript来解决。
搭建框架已不再是难点
npx create-expo-module@latest --local --name NfcNative \
--package com.you.nfcnative -p apple android --features Function
通过pod install命令,系统会自动将这四个文件集成到构建过程中。无需进行任何Xcode项目配置,也无需使用RCT_EXPORT_METHOD宏或手写JSI代码——这种C++层使得JavaScript可以直接调用原生代码。如果你是在“桥接时代”编写过React Native原生模块的,那么这种方法对你来说应该非常熟悉。
不过也存在两个小问题,而且这些问题的文档中并没有明确说明:--name参数用于设置原生模块的名称,而存储目录则是通过路径参数来指定的(如果没有指定路径,模块会被保存在modules/my-module文件夹中)。另外,生成的podspec文件可能会无形中提高应用程序的最低系统要求。
那些真正能传达信息的类型错误
internal final class NoNfcSettingsException: Exception {
override var reason: String {
"iOS系统中没有可使用的NFC设置。只有当硬件支持NFC功能时,才能使用它。”
}
}
Expo框架中的Exception类为每种错误都提供了一个代码以及一条说明信息,这些信息都可以通过JavaScript直接读取。这就是解决上述问题的根本方法。
而这里有一个让我感到惊讶的地方:即使掌握了原生代码的实现,也并不能免除你排查错误的工作。Expo会自动处理这些异常信息:
FunctionCallException: 调用‘openNfcSettings’函数失败
→ 原因是:NoNfcSettingsException:iOS系统中没有可使用的NFC设置……
err.message实际上只是描述异常发生原因的代码段而已。在错误链中,这一部分位于最后;这与库中出现的问题恰恰相反——在库中,这些错误信息是空字符串;而在这里,它们被隐藏了起来,但两者都导致了同样的问题。
下面是在应用程序中显示的这条错误链,它与JavaScript接收到的信息完全一致:
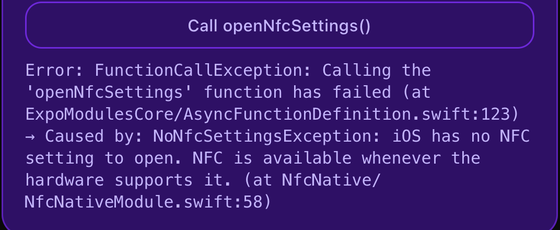
在用户能够看到的信息之前,有整整三行与框架相关的代码。解决问题的关键并不在于Swift语言本身,而在于用户界面的设计:应该先展示最核心的错误信息,其余的详细内容则可以放在需要时才显示出来的地方。
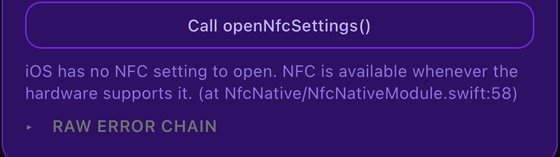
同样的错误,同样的信息,没有任何内容被遗漏。那些用Swift语言编写的代码才是引导用户理解问题原因的关键部分,而“原始错误链”则可以在需要时通过一次点击就能查看。
掌握原生代码的实现确实会改变哪些信息会让你感到惊讶吧。
那个在测试中未能被发现的漏洞
在将应用程序的实现方式切换后,当取消扫描操作时,系统会显示一条红色的提示信息“无法读取标签”,而之前则什么信息都不会显示。
在我们的Swift代码中,会抛出UserCancelledException异常;相应的映射表也是根据UserCancelledException来设计的。然而这两者并不匹配,因为Expo在处理这些异常时会对代码进行修改:它会去掉字符串末尾的Exception后缀,将驼峰式命名法转换成小写字母形式,然后在前面加上ERR_前缀:
UserCancelledException → ERR_USER_CANCELLED
这就是为什么所有的测试都能通过的原因:
const wrapped = (code, message) =>
new Error(`调用‘readTag’函数失败 → 原因是:${code}: ${message}`);
实际上,并不存在code这个属性,因为我认为Expo并没有设置它。代码本身及其对应的测试都基于一个错误的假设而设计,因此它们才会得出完全一致的结果。
< p>你发明的那些测试工具,其实只能证明你的代码本身是自洽的罢了。真正起到关键作用的是用户点击“取消”按钮这一行为。
< p>这个修复方案使得表格中的键值对仍然与Swift类名保持一致,并且能够自动生成ERR_系列的相关代码格式,这样一来,就只有一个权威的数据来源了,而不会再有两份逐渐出现差异的列表。现在,通过使用设备错误信息、code属性等来进行测试,就可以确保代码不会出现回归问题。
< p>检查点: git checkout step-4-own-module。这个模块与相应的库是分开管理的。
< h2 id="heading-how-to-prove-parity-before-you-switch">如何在切换实现方案之前验证其正确性
< p>千万不要仅仅凭直觉就决定更换实现方案。应该先在两种实现方式中都读取相同的物理标签数据,然后对比分析结果。
< p>使这种验证方法变得有效的设计原则是:“不同”并不意味着结果一定是错误的。我们的检测机制会同时报告数据的容量和可写性等信息,而库的检测机制并不包含这些内容;如果将这种差异视为错误,反而会造成误导。
< table>
状态
含义
相同两种实现方式都报告了相同的结果,因此它们是一致的
不同两种实现方式报告的结果不同,因此存在差异。
仅本端支持我们的实现方式了解的信息更多,这就是需要切换的原因
仅库端支持我们丢失了一些信息,因此也无法进行切换
两者均不支持无法得出任何结论
< p>当仅库端支持这种情况出现时,禁止进行切换是非常重要的:虽然这种差异并不表示代码存在矛盾,但丢失信息确实是一个严重的问题。
< p>以真实的NTAG213标签为例:四个字段的内容是完全相同的,其中有两个字段只被我们的实现方式报告出来,因此没有任何冲突。这就是我们决定进行切换的依据,而不是因为觉得新代码看起来更合理而已。
< h2 id="heading-what-a-config-plugin-was-doing-for-you">配置插件究竟为你做了什么
< p>删除某个依赖项时,最危险的部分其实并不是代码本身。
< p>react-native-nfc-manager提供了一个配置插件,这个插件负责生成iOS系统的NFC权限相关文件以及NFCReaderUsageDescription描述信息。如果删除了这个插件,那么这些文件就会消失,应用程序会因此失去NFC功能,而且不会出现任何错误提示。在构建过程中,也不会有任何问题发生;只是相关的配置选项不会再出现在界面中了。
< p>因此,正确的操作顺序应该是:首先在app.json文件中自行配置这些选项,然后进行预构建测试,确认生成的结果与插件产生的结果完全一致,之后再删除插件,再次进行验证,最后才删除相应的依赖包。
< p>删除一个依赖项意味着会继承它的构建配置;而插件实际输出的代码,才是最终可见的部分。
< h3 id="heading-keep-the-evidence-after-deleting-the-dependency">在删除依赖项后,务必保留相关证据
< p>之所以要替换那个库,是因为它存在一些缺陷,但这些缺陷对应的测试文件已经不存在了。如果删除了这个库,那些用于检测这些缺陷的测试就无法再运行了,而那些用于验证两种实现方式是否一致的测试也会失效,这样一来,那个手工编制的、包含36个条目的对照表也就无法得到验证了。因此,该仓库在 `vendor/` 目录下保存了一个被冻结的副本,这个副本遵循 MIT 许可协议,仅被一个测试文件所使用;同时,它也被排除在了 ESLint 和 Prettier 的检查范围之外,因为其相关属性的值在文档中记载有误,而对其进行重新格式化将会破坏它原本所要展示的功能。
✓ 每个错误类别在创建时都会被赋予空消息
✓ 将 U+1F600 这一字符转换为 U+F600,即一个仅用于私用领域的字符
✓ 会忽略它刚刚检测到的语言代码
✓ 对状态字节中的 UTF-16 标志也会视而不见
如果未来的某个版本修复了这些缺陷,那么这些测试用例就会失败,这时我们就需要重新考虑相关的设计方案,而不是将这些失败视为麻烦事。
检查点: git checkout step-5-no-dependency
如何永久锁定标签
在这个整个流程中,有一项操作是无法撤销的。正是这项操作,如果其设计出现错误,就会导致物理设备遭到损坏,因此它被放在了最后一步进行。
在 iOS 上使用 `NFCNDEFTag.writeLock`,在 Android 上使用 `Ndef.makeReadOnly()`——这两种方法都会将芯片中的锁定位设置为“已锁定”状态。这样一来,这个标签就可以被永久读取,但再也无法被写入任何内容了:无论是你的应用程序、其他任何应用程序,还是任何手机都无法对其进行修改。这种操作没有撤销机制,也无法通过恢复出厂设置来改变它的状态。
在实际应用中,人们经常会这样做。比如活动徽章、产品认证标识,或是博物馆的标签等等——凡是会被公众所接触到的物品,都会被设置为“不可修改”状态,因为如果一个标签可以被重新写入,那么任何人都可以随意修改它。
“门”本身就是这个功能的关键所在
原生调用代码只有四行,而所有真正重要的操作其实都发生在这四行代码之前。
在这个应用程序中,两次点击操作才能完成对标签的写入操作——毕竟写入操作是可以被撤销的,你只需要重新输入其他内容即可。但在这种情况下,这样的设计显然是不够的。因此,开发者借鉴了 GitHub 在删除仓库时使用的机制:你需要输入该标签的名称,以证明你知道自己正在删除的是哪个标签。
它所接收到的 `status` 值其实就是标签本身的 NDEF 状态,这个值与写入操作所需的参数是完全相同的——要么是“NDEF”状态,要么是“可读写”状态,要么已经是“只读”状态了。
export function lockGate(tagId, status, typed): LockGate {
if (!tagId) return { state: 'no-tag' };
if (status === NDEF_STATUS.READ_ONLY) return { state: 'already-locked' };
if (status === NDEF_STATUS NOT_SUPPORTED) return { state: 'not-lockable' };
return normaliseTagId(typed) === normaliseTagId(tagId)
? { state: 'armed', tagId }
: { state: 'needs-confirmation', expected: tagId };
}
确认对话框用于验证用户是否真的愿意执行锁定操作;而输入标签标识符这一行为则体现了用户的关注程度。我们需要重点防范的情况并不是那些想要锁定标签的人,而是那些想要锁定错误的标签的人。
正因如此,在你先读取标签的内容之前,系统是不会启动锁定机制的,并且会显示标签上当前存储的信息。这样,就可以避免在标签被错误地使用之前,导致不必要的麻烦。
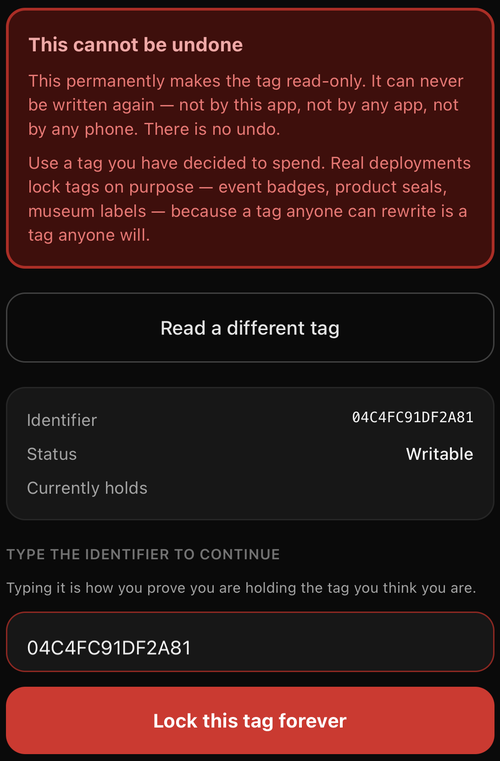
标签的标识符会显示在屏幕上,用户也需要手动输入它。这看起来似乎有些多余,但当你想到它的存在目的时,就会明白其重要性了:确保正确的设备能够识别到正确的数据。
注意这个操作流程的顺序:already-locked会在用户确认输入之前被检查,因此没有人能够通过输入来“锁定”一个已经锁定的标签,并且系统也不会提示操作成功。实际上,这种操作根本无法成功,也没有其他办法可以补救。
“无事可做”并不意味着“出了问题”
AlreadyLockedException与LockFailedException被明确区分开来,用户界面会用绿色颜色来显示这种错误状态,并且不会提供任何锁定按钮。标签的状态正好符合用户的期望,但如果将这种情况视为失败,就会让人们误以为某个正常的芯片出了问题。
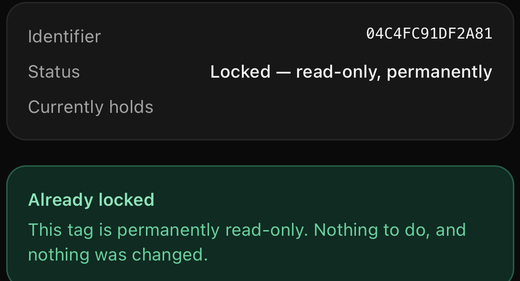
“无需采取任何操作,也没有任何内容会被更改”这句话确实传达了重要的信息:它说明应用程序并没有尝试进行任何操作,而对于那些无法重复执行的操作来说,了解这一点是非常重要的。
这个原则与在自己的代码中避免抛出依赖关系的错误类型是一样的:两种不同的情况绝对不能被当作同一个信号来处理,而当你需要区分它们时,往往就意味着出现了问题。
需要验证,因为无法通过重试来确定结果
这两种实现方式都会在操作完成后重新检查标签的状态。这种检查在写入操作中也会存在,但在这里它的意义有所不同:如果写入操作失败,还可以重新尝试;但如果锁定操作看似成功,但实际上并没有发生任何变化,那么这个标签就会被认为处于受保护的状态,而用户也无法通过重试来验证这一点的正确性,因为重试本身就会导致问题进一步恶化。
因此,未经过验证的锁定状态不会像未经过验证的写入操作那样被当作一个警告信息来显示。系统会提示标签的状态未知,在依赖该标签之前需要先读取其内容。
最确切的确认信号会来自标签本身,而不是应用程序。当用户再次尝试写入该标签时,CoreNFC系统会直接拒绝这一操作,而不会让用户的代码有机会执行这个操作。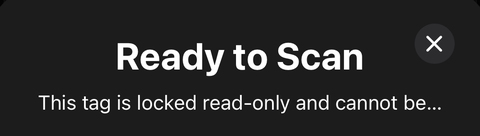
那句话是iOS编写的,而不是这个应用程序编写的。这是唯一真正重要的证据,也是你永远无法再次获取的证据。
一个独立的类,而非某种标志
NfcLockSession在很大程度上重复了写入会话的相关内容:设置、代理以及一次性的确认流程。这种设计是故意的。
另一种选择是在写入会话中使用lock: Bool这个参数。然而,这样一个布尔型参数有时会导致标签损坏,而三年后,在有人对代码进行重构时,恰恰因为这个人从未读过原始代码文件,所以不小心使用了这个参数。两个调用位置、两种不同的意图,但却没有从错误的地方能够访问到相同的代码路径。
有时候,对于“这些代码几乎是一样的”这种情况,最好的处理方式就是让它们确实保持几乎相同的状态。
以及那个在代码有误时却仍然正确的测试
it('会拒绝完全不符合NDEF标准的标签', () => {
expect(lockGate(TAG, NDEF_STATUS NOT_SUPPORTED, TAG).state).toBe('armed');
});
从名称上看,这个测试应该是用来“拒绝”不符合NDEF标准的标签的;但从实际的测试结果来看,它显示的是“armed”。这个测试通过了,因为代码确实执行了相应的操作,而writeLock方法是NFCNDEFTag对象上的方法,因此,对于不符合NDEF标准的标签来说,本来就不应该调用这个方法。
名称是正确的,但代码却是错误的。这个错误之所以能够被发现,是因为在查看测试结果时,看到了与测试名称相对应的正确结果;只有通过这种方式,才能发现这种错误:那些与错误代码相匹配的测试,在实际的测试运行过程中是无法被检测出来的。
你究竟会如何将这个产品正式发布呢?
上面提到的所有步骤都是使用expo run:ios、Xcode、CocoaPods在本地完成的,而且过程中还两次对整个硬盘进行了清理操作。另一种选择是使用EAS Build工具来进行开发,因此,对于这两种方法来说,确实需要进行一次认真的比较,而不仅仅是简单地进行推荐。
下面提到的所有步骤都是通过EAS Build工具进行测试的:首先进行了一次正式的生产环境构建测试,然后还设计了一个专门的实验来验证上述说法的正确性,而不是直接假设这些说法就是正确的。唯一没有做的事情就是安装最终生成的.ipa文件。由于这是App Store版本的应用程序,因此无法通过其他方式安装;此外,本手册中提到的所有与NFC功能相关的测试,都是在使用在真实设备上本地编译生成的二进制文件进行的。
如果使用EAS Build工具,本来可以节省很多时间和精力
在这个项目中,最令人头疼的问题就是这个错误:
“iOS团队配置文件”不支持NFC标签读取功能。
解决这个问题的方法需要手动操作,而且从错误信息中根本无法看出解决办法:需要在苹果的官方平台上注册一个明确的App ID,然后勾选NFC标签读取选项,最后重新生成配置文件。从这个错误信息来看,根本没有任何提示说明需要打开浏览器来解决问题。
EAS会自动完成这一步骤。如果你的权限文件中包含了受支持的权限项,eas build命令会在Apple开发者控制台中启用相应的功能;如果该功能已经启用,系统就会跳过这一步骤。而com.apple.developer.nfc.readersession.formats这个键值对,正是这款应用所声明的权限项,它确实被列在受支持的权限列表中。
因此,在整个使用指南中,唯一需要人工操作且过程较为繁琐的步骤,实际上却被我根本没有使用的EAS工具给自动化处理掉了。
如何通过实际验证来确认事实
使用eas build命令针对TapCard的实际应用包标识符进行测试,并无法证明这一点的正确性。在相信别人提供的截图之前,了解其中的原因是非常重要的:
✔ 注册的应用包标识符:com.nfccard.tap
✔ 同步后的权限项:无更新
“无更新”,是因为这个App ID原本就已经具备了NFC标签读取功能。我是通过浏览器手动为它配置了这个功能的。所有这些测试结果只证明了EAS工具认可我之前已经完成的工作而已。很多声称“EAS会自动处理这些步骤”的说法,其实都是基于这样的测试结果来宣传的。
要真正验证这一点的正确性,就需要使用一个从未存在过的应用包标识符。因此,我们可以创建一个临时项目,比如com.nfccard.tap.eastest,这个项目中除了包含所需的权限项外,不包含任何其他内容。这样的临时项目应该与真正的应用程序分开管理,而不能通过暂时更改其应用包标识符来完成测试,因为这样做可能会导致存储的凭证信息混乱。
✔ 注册的应用包标识符:com.nfccard.tap.eastest
✔ 同步后的权限项:已启用:NFC标签读取功能
事实确实如此。我们使用了一个根本不存在的App ID,仅通过权限文件就为它配置了NFC标签读取功能,整个过程没有使用浏览器,也没有访问任何官方门户网站。由于同步操作是在配置凭证信息的步骤中进行的,所以使用的命令是eas credentials:configure-build,而且这个命令并没有消耗任何构建资源。
如果你要重复进行这个测试,有一个实际需要注意的地方:请先运行真正的应用程序构建过程。分发证书是针对整个账户而言的,而Apple对每个账户可以持有的分发证书数量是有限制的,因此如果先创建临时项目,就会浪费一个证书,而这个证书最终可能会被用于一个你打算删除的应用程序上。按照正确的顺序操作的话,临时项目会尝试重用真正的分发证书,而只会为自己生成一个新的配置文件,这种配置文件是针对每个应用包标识符单独生成的。
CLI工具的实际功能
这种权限项与功能之间的对应关系并不是什么神奇的机制,也不是隐藏在某个难以发现的地方。实际上,它就是一个查找表,而NFC标签读取功能在这个查找表中也有相应的条目(文件路径为eas-cli/build/credentials/ios/appstore/capabilityList.js):
{
name: 'NFC Tag Reading',
entitlement: 'com.apple.developer.nfc.readersession.formats',
capability: CapabilityType.NFC_TAG_READING,
// 从技术上讲,似乎只有`TAG`这个选项是被允许的,但很多应用程序都会建议用户同时添加`NDEF`选项。
validateOptions: createValidateStringArrayOptions(['NDEF', 'TAG')),
getSyncOperation: getDefinedValueSyncOperation,
}
请再读一遍那条评论,因为它实际上是在谈论你:NDEF 可能并不是一个有效的值。所有的教程都建议你使用["NDEF", "TAG"]这个格式,这本手册中的app.json文件也是这样写的,而负责维护映射表的人也明确表示只有TAG才有实际意义,但他还是接受了这两种格式,因为如果拒绝其中任何一种,就会导致整个系统出现问题。当没有人去检查相关规范时,这就是所谓的“惯例”了。
getDefinedValueSyncOperation则是另一个关键环节。这个操作会判断某个功能是否已被定义,因此同步过程是双向进行的,而不仅仅只是添加新的内容。
还有一个文档中没有提到的实际细节:同步操作实际上是由credentials步骤触发的,而不是由构建步骤引发的。
SetUpTargetBuildCredentials.runAsync()
└─ ensureBundleIdExistsAsync({ entitlements, … })
└─ syncCapabilitiesAsync()
→ "Synced capabilities: Enabled: NFC Tag Reading" (或 "No updates")
因此,通过eas credentials:configure-build --platform ios命令,你可以注册App ID并同步相关功能,而无需进行任何构建操作。如果你只需要确保苹果端的相关设置正确无误,那么你根本不需要花费额外的成本来进行构建。
随之而来的问题
同步过程是双向的:如果某个功能在远程被设置为启用状态,但本地的相关配置文件中并没有这个选项,那么当你运行eas build命令时,这个功能就会自动被禁用。
那些既通过门户网站手动管理各种功能,又使用EAS进行构建的团队,会发现EAS会自动关闭一些功能。无论你是否愿意,配置文件最终都会成为决定各项功能是否启用的权威依据。
EXPO_NO_CAPABILITY_SYNC=1这个选项可以让你选择不参与同步过程,但需要注意的是,这样做会导致远程所做的更改无法被同步到本地,从而后续可能会引发配置文件不一致的问题。因此,请为各种功能指定一个明确的负责人,让其来负责这些功能的配置和管理。
EAS也无济于事的事情
对于这个项目遇到的大多数问题来说,“使用EAS”并不能解决它们,如果有人声称EAS能帮助解决问题,那其实就是在误导人们:
问题
EAS能帮忙吗?
在App ID中启用NFC标签读取功能
✅ EAS可以自动完成这个操作
需要将整个磁盘空间重复使用两次
✅ 构建过程可以在其他地方进行
构建完成后Gradle后台进程会占用大量内存
✅ 可以在本地不运行任何构建相关程序
添加Swift文件后需要执行pod install命令
✅ 每次构建都会进行清理操作
CoreNFC会话释放后内存未得到正确处理
❌ 这是一个代码错误
需要多次执行相同的操作来完成某项任务
❌ 这也是一个代码错误
FeliCa相关的功能请求
❌ 这并不是EAS能够管理的功能
String.fromCharCode方法在处理emoji时会出现截断现象❌ 这是一个依赖库相关的问题
Expo在处理某些情况时会返回ERR_USER_CANCELLED错误代码
❌ 这只是一个错误的假设而已
读取标签数据本身
❌ 对于这种功能来说,云端服务根本无法替代物理芯片的作用
EAS能够解决机器本身存在的问题,但无法解决与NFC技术相关的问题。 如果这本手册中任何关于NFC的内容,其结果都会是完全相同的。
交易方式
本地构建需要耗费磁盘空间、内存资源以及进行相应的设置工作。在这个项目中,我们曾两次使用460GB的磁盘进行构建;在内存压力较大的情况下,有三个后台进程被强制终止;此外,还因为Gradle守护进程出现故障而导致重建工作失败。
使用EAS需要等待排队时间,并且还需要使用云服务来进行构建;同时,你的签名凭据也会存储在Expo的服务器上。但它无法缩短真正关键的那个环节:你仍然需要亲自将芯片靠近手机进行读取操作。 即使云构建结果显示成功,也无法确定标签数据是否已经被正确读取。
对于那些拥有可用本地开发工具链的个人项目来说,本地构建在迭代速度上确实具有优势;但对于团队项目、持续集成管道,或者那些发现自己的磁盘空间在构建过程中被完全占用的用户来说,仅从代码同步的角度来看,使用EAS也是一个非常不错的选择。
Android端的简要介绍
Android确实值得拥有属于自己的专门手册,而这样的手册也正在编写中。对于那些不想等待的人来说,这一部分内容可以作为一个预览:其中介绍了Kotlin语言在Android平台上的使用方式,以及两种平台在架构上的差异——这些差异使得NFC技术在Android和iOS上的实现方式实际上是完全不同的。
请将这部分内容视为设计层面的预览,而不是已经经过验证的实现方案。Kotlin代码是针对官方文档中规定的API进行编译的,其功能与在硬件上经过验证的Swift代码是相似的;因此,整体框架是正确的。至于关于设备测试的详细信息,请参阅后续发布的正式手册。
那些真正重要的差异是从API层面就能看出来的,而不是通过设备测试才能发现的;而这些差异恰恰决定了你应该如何组织代码结构。
Android没有会话机制
iOS会为你提供一个会话对象,这个会话对象本身就是整个交互流程的核心:你启动应用程序后,操作系统会生成相应的界面元素,并将标签数据提供给你;之后该会话对象就会失效。而Android则提供了读取模式:这种模式会在标签靠近设备时触发,对应的回调函数会被绑定到你的前台活动中。
adapter.enableReaderMode(activity, ::onTagDiscovered, flags, Bundle())
iOS会话对象所承担的所有功能,在Android系统中都会由你自行负责实现:
iOS
Android
扫描界面显示
操作系统生成界面元素
应用程序自己绘制所有界面元素
会话结束时机
读取一个标签后自动结束
在每次退出程序时调用disableReaderMode
所需资源
屏幕上不会显示任何内容
仅需要前台活动对象,而非上下文对象
回调线程
主线程
绑定器线程
取消操作
系统会提供相应的接口来处理
需要你自己手动实现取消操作
最后那一行代码实际上与JavaScript相关。这个跨平台的`cancelScan()`函数在Android系统中确实能够正常工作,但在iOS系统中则被明确记录为“无实际效果的功能”:在iOS系统中,系统本身负责处理取消操作,而Swift模块也故意没有实现这一功能。
export async function cancelScanNative(): Promise {
if (Platform.OS !== 'android') return;
await NfcNative.cancelScan();
}
另外:需要传递 FLAG_READER_NO_platform_SOUNDS,否则操作系统会在应用程序已经向用户说明操作步骤的情况下,仍然播放自己的发现提示音。
Kotlin与One Design Note
private fun onTagDiscovered(tag: Tag) {
val ndef = Ndef.get(tag) ?: run {
stopReaderMode(); rejectOnce(NotNdefException()); return
}
try {
ndef.connect()
val status = NfcTagInfo.status(ndef)
val capacity = ndef.maxSize
messageToWrite?.let { message ->
// 在执行任何操作之前先进行确认,操作顺序与Swift中的相同:如果拒绝操作,标签的状态将保持不变;如果在写入过程中出现错误,标签的状态可能会发生变化。
if (!ndef.isWritable) { … }
if (message.toByteArray().size > capacity) { … }
ndef.writeNdefMessage(message)
}
// 可以通过相同的连接来读取数据。对于写入操作来说,这一过程属于验证环节;而对于读取操作来说,它就是获取到的数据本身。
val onTag = ndef.ndefMessage
…
} finally {
runCatching { ndef.close() }
}
}
Android系统中并没有与iOS的NFCNDEFStatus相对应的机制,因此标签的状态是通过其他方式推导出来的,而不是直接被读取到的。
fun status(ndef: Ndef?): Int =
when {
ndef == null -> 1 // 不是NDEF格式:因为Ndef.get()返回null
ndef.isWritable -> 2 // 可读写
else -> 3 // 只能读取
}
iOS可以直接给出这个问题的答案;而Android则是通过Ndef.get()返回null来表示“不是NDEF格式”,同时会通过isWritable属性来判断标签是否可以写入数据。将这两种方式映射到同一组数字中,就可以确保TypeScript代码无需知道当前是在哪个平台上运行,而这正是原生模块的主要作用所在。
如果你移植这段代码,就会遇到一些重要的差异
iOS
Android
权限模型
应用ID + 功能权限 + 是否为付费账户
只需在manifest文件中添加一行代码,即可免费使用
配置错误时的后果
会出现签名错误,但错误信息中不会明确指出“NFC”相关问题
会因为权限缺失而导致功能无法使用
权限的细分程度
针对每个具体的操作请求进行判断
一个权限就可以覆盖所有相关的操作
扫描用户界面
使用系统自带的界面,无法进行自定义设计
没有专门的用户界面,所有元素都需要手动绘制
通过读取操作可以获取标签的容量信息
❌ 需要通过特殊查询才能获取
✅ 可以使用getMaxSize()方法获取
通过读取操作可以判断标签是否可写入数据
❌ 需要通过特殊查询才能获取
✅ 可以通过isWritable属性来判断
天线的位置
位于设备的上边缘
位于设备的后中部
卡片模拟功能
无法实现
可以通过HostApduService实现卡片模拟功能
是否支持永久性锁定
使用writeLock方法可进行永久性锁定,且这种锁定是不可逆的
使用makeReadOnly()方法可进行永久性锁定,且这种锁定也是不可逆的
从那张表格中可以归纳出两种模式。
iOS会将处理这些操作的负担提前承担,而Android则会在后期进行处理。在iOS系统中,需要在读取任何数据之前先完成权限验证、签名等操作;而在Android系统中,则是在阅读模式下通过Activity的生命周期机制来处理这些功能,同时也可以自行实现取消操作的功能。
此外,两者之间的功能差异并没有看起来那么大。并不是说iOS提供的信息更少,而是说在Android系统中,这些功能会在普通的读取操作中被自动执行;而在iOS系统中,则需要用户在进行特定操作时主动请求这些功能。同样的数据,但获取方式却不同。正如你们所见,我在分析三份文档时都犯了这个错误。
演示仓库
以上所有内容都属于同一个项目,即TapCard,它是一个完整的应用程序,而不是零散代码的集合。
层级
位置
包含的内容
应用程序代码
app/(tabs)/包括读取、写入、聚焦等相关界面,以及标签信息显示功能
纯逻辑代码
lib/包含NDEF解码器与编码器、vCard格式处理代码、容量检测逻辑、错误处理机制等,约2,240行代码,未使用React Native库
原生模块代码
modules/nfc-native/包含约1,010行的Swift代码和约475行的Kotlin代码,主要用于会话管理、类型化异常处理及标签格式转换等功能
状态存储代码
store/用于存储应用程序的状态信息,如用户配置、最后读取的标签信息等,同时使用AsyncStorage进行数据持久化存储
辅助代码
vendor/包含被移除的依赖项及相关测试代码,用于验证这些依赖项移除的合理性
备注文件
DEVLOG.md, GOTCHAS.md, PLATFORM-NOTES.md记录了所有的命令执行过程及出现的错误信息,还包括75个陷阱测试结果以及各项功能之间的运行对比数据
总共进行了293次测试,分属于15个测试套件,整个测试过程耗时约一秒钟,而且完全不需要任何硬件设备。这就是保持解码逻辑纯粹所带来的好处。
git checkout step-0-scaffold # 启动应用程序,但不支持NFC功能
git checkout step-1-first-read # 进行权限验证及原始数据读取操作
git checkout step-2-decode # 使用自定义解码器进行标签信息解析
git checkout step-3-write # 处理vCard格式数据并检测标签容量
git checkout step-4-own-module # 使用原生模块与库文件一起运行应用程序
git checkout step-5-no-dependency # 移除所有依赖项,仅使用库文件
git checkout step-6-android # 在Android平台上使用Kotlin语言的读取模式
你可以克隆这个项目,购买一些贴纸,然后切换到step-1-first-read分支,将自己的芯片放在手机上测试这些功能。通过这种实际操作,你能最快地了解上述所有内容的具体运作方式。
开始之前需要了解的内容
首先购买标签芯片。目前没有模拟器可供使用。当初我的芯片在邮寄过程中丢失了,导致项目停摆了两周时间,没有任何复杂的架构设计能够替代真正的芯片来完成这些功能。在信任任何依赖项之前,先仔细阅读相关文档。** 使用ndef-lib进行了20分钟的测试后,我们发现了三个真正的缺陷,这些缺陷甚至改变了应用程序的架构。而这些缺陷中,没有一个出现在我会去搜索的问题跟踪系统中。
要假设程序出现故障时可能不会产生任何提示信息。** 在我记录的75个问题中,有大约12个根本不会引发任何错误:未释放的会话对象、被移除的配置插件、未被正确处理的分号、被截断的emoji符号、空白的错误信息,以及被Git忽略的原生模块。在NFC相关的技术场景中,“什么异常都没有发生”其实是最常见的现象,因此必须相应地设置监测机制,并在实际运行环境中进行验证,而不能仅仅依赖返回值来判断问题是否存在。
应该将平台差异明确体现在代码类型中,而不是通过注释来说明。** 应将该差异定义为一种“一级状态”,例如这样定义:
```typescript
type Fact = {
label: string;
value: string | null; // null表示该平台没有提供相关数据
unavailable?: string; // 用通俗的语言解释为什么无法获取该数据
};
```
如果一个用户界面在值缺失或为0的情况下都只显示一条空白的提示信息,那么这种设计根本起不到任何教育意义。
另外,不要让某个结论继承其背后观察结果的可信度。** 有个例子就耗费了我们最多的时间,而实际上它与NFC技术毫无关系。
结论
现在你们已经对iOS平台有了全面的了解:复杂的权限设置机制、因为常用解码器会丢失数据而不得不手动编写的解码程序、在执行操作之前需要先询问标签的写入路径、受地理位置影响的聚焦计时功能、用Swift语言实现的原生模块、被删除但其相关证据仍被保留的依赖项,以及那些需要用户输入名称才能使用的标签。
接下来有三件事值得进一步探索:
背景标签读取功能:** 在应用程序关闭的状态下点击标签。iOS系统会弹出一条通知,用户必须点击这条通知才行,而且这种功能仅适用于某些类型的标签。正是这一特性让NFC技术显得如此神奇,而关于哪些标签符合这个条件,其具体规则也值得深入了解。
加密标签:** NTAG424类型的标签会在每次被点击时更新计数器。如果你想让某个标签具有凭证功能而不是仅仅作为标识符使用,那么这就是你需要开始研究的方向。
还有Android平台,** 它将是我们的下一个学习对象。上面的概述只是整个内容的框架,而关于如何在真实设备上操作Android平台的详细步骤,将在后续的内容中介绍。
实际上,真正有趣的部分从来都不是requestTechnology这个方法。真正值得关注的是那些两个平台在你使用方法错误时拒绝告诉你的信息。
参考资料与延伸阅读
关于Apple、CoreNFC以及权限设置的相关资料:
-
queryNDEFStatus: 这个方法其实并不存在,我们的项目之前错误地认为它存在。
Near Field Communication Tag Reader Session Formats entitlement
-
-
iPad上是否支持CoreNFC功能: 一位Apple工程师确认,该框架仅适用于iPhone。
Android:
相关格式:
NFC论坛的NDEF与RTD规范:包括URI前缀表及文本记录的状态字节
RFC 2426:vCard 3.0规范,涉及N字段以及行折叠功能
Expo与React Native:
eslint-plugin-react-hooks,以及其中两个备受关注的规则:purity和set-state-in-effect
-
-
EAS Build中的iOS功能支持:哪些权限会被同步,以及EXPO_NO_CAPABILITY_SYNC的作用
expo-modules-core与ios/Core/Exceptions/CodedError.swift:ERR_USER_CANCELLED这个错误码的来源
已发布的NFC相关功能,可参考以下链接:“你可能已经见过这些内容”:
在“快捷方式”中设置触发条件,苹果官方文档。NFC功能需要iPhone XS或更高版本及iOS 13.1系统
在“查找”应用中将AirTag等物品标记为丢失,苹果官方文档
amiibo常见问题解答,任天堂官网,关于只读与可读写数据类型的区别
使用“英国移民身份验证”应用程序,GOV.UK官方网站
iPhone上的“轻触支付”功能及支持地区列表,苹果官网
与“焦点功能”相关的前沿技术:
- Foqos(开源项目,可在App Store》中下载)以及TapBlok
本项目所替代的库:
react-native-nfc-manager:这个库属于MIT许可协议。在3.17.2版本中,通过阅读其源代码发现了其中存在的缺陷;这些缺陷对应的测试用例已被保存在演示项目的vendor/目录中。
相关文章
如何利用功能标志来实现安全、渐进式的功能推出
功能开关是团队在部署过程中最强大的工具之一。它们将 部署 与 发布 分离开来,这意味着你的持续集成/持续交付流程可以在每次代码合并时都将更新推送到生产服务器上,但只有当你明确启用这些功能开关时,用户才会看到新的变化。 “部署”是一个技术性操作,而“发布”则是一项产品决策。正是这种分离机制,使得本文中讨论的诸多内容成为可能。 然而,如果实现不当,功能开关反而会带来技术债务、测试难题以及运行时的复杂性。在这篇文章中,你将学习到实施功能开关的核心方法——从简单的布尔值切换,到基于百分比的比例化部署方案,再到针对不同用户群体的功能启用策略,同时还会了解相关的生命周期管理方法及应避免的错误做法。以下就是
阅读全文
如何逐步迁移传统的单体应用系统,而无需进行大规模的重新开发
大多数传统的迁移项目在最终切换完成之前就会失败。 这种失败通常源于将迁移过程视为一个单一的步骤来执行:迁移应用程序、数据库,转移所有用户数据,调整流量分配,然后关闭旧系统。 这种做法隐含了一个危险的假设:即旧系统和新系统必须同时被替换掉。 但实际上,这种情况很少会发生。 如果你已经了解了旧系统的运行机制,可以通过编写测试用例来保护这些现有功能,设定适合迁移的边界条件,并对比新旧系统的实现方式,那么你就有了另一种选择。 你可以一次只迁移一个功能模块。这样就能彻底改变原有的迁移方案。 旧式单体系统 ↓ 全面重构 ↓ 一次性切换完成 而你现在可以选择的做法是: 旧式单体系统 ↓ 提取出一个功能模块进
阅读全文
如何编写能够真正被编译成功的Linux内核模块
Linux中的 内核模块 是一段较小的代码,可以在不重新构建整个内核的情况下被加载到正在运行的内核中。 这听起来很简单,但实际上,即使是最简单的模块也会产生大量相关的文件和数据:对象文件、元数据、导出的符号以及未解析的符号,最后还会生成一个与普通可执行文件截然不同的 .ko 文件。 下面是一个完整的、可以正常工作的Linux内核模块。它的代码仅有22行,其中7行是包含头文件和元数据: #include #include #include MODULE LICENSE("GPL"); MODULE AUTHOR("Chris Roy"); MODULE DESCRIPTION("一个最小的可加载
阅读全文
在旧系统迁移过程中如何使用差异测试方法
在旧系统迁移过程中,最危险的时刻并不一定是在开始编写新实现代码的时候,而是在新实现看起来已经完成的时候。 代码编译通过了,测试也通过了,架构也更加清晰了,新的服务响应速度也更快了…… 然后所有人都会开始问同一个问题: 我们现在可以把流量切换过来吗? 这时,信心就会变得难以建立。 一个新的实现虽然能够通过自己的测试套件,但其行为仍可能与它所要替代的系统有所不同。 也许数值的舍入规则发生了变化,或者对空值的处理方式不同了,又或许某个错误现在被当作成功的响应来处理了…… 也许记录的排序方式改变了,某些副作用出现的顺序也变了,又或许在迁移过程中,一些从未被记录下来的业务规则丢失了…… 正因如此,在进行
阅读全文