
什么是模型蒸馏?开发者指南
随着时间的推移,知识以多种形式被传承下来。在古代美索不达米亚(今天的伊拉克)文字尚未被发明之前,法律、历史、神话、歌曲等各种信息都是通过口耳相传的方式从一代人传到另一代人的。这种传播方式要么是通过具体的指示来进行,要么是通过讲故事来实现的——尤其是那些民间传说以及发生在很久以前的事件。 但另一种常见的知识传递方式就是师徒之间的传授,无论是正式的还是非正式的。我们在历史上也能看到这样的例子:《圣经》记载,耶稣有十二个门徒,在他开始传道直到去世的这段时间里,每天都教导他们。苏格拉底教导柏拉图,而柏拉图又在雅典创立了一所学堂,并在那里教导亚里士多德长达二十年。亚里士多德在科学、逻辑学和政治学领域取得
随着时间的推移,知识以多种形式被传承下来。在古代美索不达米亚(今天的伊拉克)文字尚未被发明之前,法律、历史、神话、歌曲等各种信息都是通过口耳相传的方式从一代人传到另一代人的。这种传播方式要么是通过具体的指示来进行,要么是通过讲故事来实现的——尤其是那些民间传说以及发生在很久以前的事件。
但另一种常见的知识传递方式就是师徒之间的传授,无论是正式的还是非正式的。我们在历史上也能看到这样的例子:《圣经》记载,耶稣有十二个门徒,在他开始传道直到去世的这段时间里,每天都教导他们。苏格拉底教导柏拉图,而柏拉图又在雅典创立了一所学堂,并在那里教导亚里士多德长达二十年。亚里士多德在科学、逻辑学和政治学领域取得了革命性的成就,类似的例子还有很多。
21世纪的一个例子就是深度学习领域中的这种师徒传承关系。在20世纪的“人工智能寒冬”期间,当人们认为神经网络已经走入了死胡同时,正是这种师徒相传的精神让这个领域的梦想得以延续下去。
被誉为“人工智能之父”的杰弗里·辛顿创立了一个实验室,在那里他教导了扬·勒昆、伊利亚·苏茨克维等人。扬·勒昆后来发明了卷积神经网络,而伊利亚·苏茨克维则共同创立了OpenAI,之后又去了Safe Superintelligence Inc.工作。
虽然人类之间进行知识传递这一概念已经为大家所熟知,但机器与机器之间的知识传递又是什么呢?这就是所谓的“模型蒸馏”技术。
在这篇文章中,我将详细解释什么是模型蒸馏,探讨它所使用的技术手段,并指导大家如何使用PyTorch从零开始实现这一技术。通过阅读本文,你将了解到如何训练规模更小、效率更高的模型,以及模型蒸馏与其他压缩技术(如量化技术和剪枝技术)之间的区别。
我们将会讨论的内容
先决条件
要顺利完成学习过程,您需要具备以下条件:
一个GitHub仓库:该项目的完整实现代码可在此处查看:点击访问,您需要将其克隆到自己的机器上才能进行学习。
对Python及面向对象编程概念有基本了解(例如会使用类进行开发)。
了解深度学习的基础知识,包括训练周期、前向传播、损失函数等相关概念。
掌握PyTorch的基本用法:虽然我会为您解释每段代码的功能,但如果您对PyTorch的张量及训练流程有基本认识,会更有帮助。
具备开发环境:您的机器上需要安装Python。我使用的是Visual Studio Code作为编辑器,但您也可以选择任何其他编辑器或集成开发环境。
硬件要求:对于这个项目来说,我们使用的数据集规模较小,因此普通的CPU就能满足需求。
什么是模型蒸馏?
模型蒸馏(或称为知识蒸馏)是一种旨在将大型、高精度模型的学习成果传递给小型、计算效率更高的模型的技术,从而使后者更适合实际应用。
模型蒸馏其实是一种压缩技术:通过这种技术,较小的模型会学会模仿较大、更复杂的模型的输出结果。其目标在于让小型模型达到与大型模型相近的性能水平,但同时使其参数数量大大减少,从而提高部署效率。(来源)
为什么需要模型蒸馏?
在撰写本文时,无论是开源模型还是闭源模型,它们在训练过程中都会涉及数万亿个参数。这些参数是模型从训练数据中自动学习得到的配置信息。由于参数数量庞大,如果没有足够的资金支持,运行这些模型将会非常困难且成本高昂。此外,这些模型还会消耗大量能源,并需要高性能的硬件设备。
通过模型蒸馏技术,我们可以将这些先进模型的学习成果转移到小型、高效的模型上,从而使它们变得更易于使用且成本更低。
模型蒸馏技术
所采用的蒸馏技术取决于需要转移的具体知识内容。有些方法仅传输最终预测结果,而另一些方法则会传输模型的内部表示结构、注意力分布图、推理过程,甚至整个教师模型的行为特征。
以下是一些常见的模型蒸馏技术:
基于响应的蒸馏
这一方法最初是由杰弗里·辛顿在他的论文《从神经网络中提取知识》中提出的,属于典型的“教师指导学生学习”的训练模式。在深入探讨其工作原理之前,有几个与模型训练相关的概念你需要先了解:硬标签和软标签。硬标签严格对应于固定的分类目标。当将一张狗的图片输入模型,并要求它判断这张图片代表的是狗、猫还是马时,模型会输出“狗(1)”、“马(0)”或“猫(0)”作为结果。在这种情况下,模型并不会考虑图片中有多少部分看起来像猫或马,也不会涉及这些特征所占的比例。而软标签则与概率相关。当使用软标签将同一张图片输入模型时,模型会输出该图片是狗的概率为0.85、是猫的概率为0.10、是马的概率为0.5。
在基于响应的蒸馏方法中,学生模型并非仅通过硬标签进行训练,它还会学习教师模型输出的概率信息(即软标签)。这样,学生模型不仅能知道这张图片代表的是狗,还能了解到这张图片与猫有几分相似,与马则几乎没有相似之处。
这种额外的信息被称为“隐性知识”。它使得较小的模型能够在保持高性能的同时,复制规模更大、准确性更高的教师模型的行为特征。
基于响应的蒸馏方法具有实施方便、稳定性强且适用于图像分类等优点。不过它也存在一些缺点,最突出的问题就是它忽略了网络内部的具体运作机制。
也就是说,基于响应的蒸馏方法只关注输出层的结果(即各种概率值),因此学生模型与教师模型之间存在着“黑箱”关系——学生模型只能知道教师模型的最终判断结果,却不清楚它是如何得出这个结论的。以之前的例子来说,学生模型虽然能了解到某张图片属于狗、猫或马的概率,但却无法理解其背后的原理或计算过程。
基于特征的蒸馏
这种技术传输的是大型模型的内部特征表示结构,而不仅仅是最终的输出结果。
举个简单的例子:假设你是一位优秀的数学导师的学生。导师给你出一道数学题,并告诉你最终的正确答案。你可能会逐渐猜出正确的解题方法,但实际上你更多是在学习如何记住这个答案而已。
但如果导师要求你查看他们的解题过程,那么你就真正理解了他们的思考方式。
在基于特征的蒸馏过程中,学生在训练时需要生成与教师模型隐藏层激活值相匹配的结果。通过均方误差这一评估指标,学生模型不仅会在正确预测最终结果时获得奖励,其内部功能结构如果与教师模型不一致,也会受到惩罚。
这种方法在卷积神经网络、视觉变换器以及物体检测等领域得到了广泛的应用。
这种方法的缺点在于:由于学生在每次训练过程中都需要提取并存储教师模型的内部特征图,因此内存消耗和计算资源的需求会迅速增加,从而导致运行成本大幅上升。注意力蒸馏
在这种方法中,学生模型并不会复制所有神经元,而是会观察大型模型关注哪些神经元,并复制这些神经元。
在变换器模型中,这类模型旨在理解整句话的含义,而非关注单个单词。注意力图能够表明,在进行预测时,模型认为哪些输入元素或区域最为重要。学生模型会尝试重现这些注意力图或教师模型的权重分布,这样它就能知道在解决问题时应该“关注”哪些部分。
不过,注意力蒸馏的缺点在于训练时间和硬件资源消耗较大。这是因为需要计算均方误差(MSE)和库尔贝克-莱布勒散度等指标。这些指标作为损失函数,能够告诉模型其预测结果与教师模型的差异有多大。而对庞大的注意力张量进行这样的计算会显著增加资源消耗。
自我蒸馏
模型也能够自我训练。这一过程涉及将早期版本的知识传递给后期版本,同时也可能包括网络中不同层次之间的知识交流。
这样做的一个优势是:模型可以在不增大规模的情况下变得更好,从而降低使用大型模型来训练学生模型的成本。
如何在PyTorch中实现知识蒸馏
为了展示模型蒸馏在实际应用中的运作方式,我们将使用PyTorch和MNIST数据集来训练一个教师模型和一个学生模型。
该数据集包含了大约70,000张手写数字的灰度图像。我们先训练教师模型,然后将其固定不变,再利用教师模型的标签和目标值来训练学生模型。
需要注意的是,MNIST数据集规模相对较小,因此我们通过蒸馏获得的改进可能不会很明显。但这个项目仍然能够展示知识蒸馏的整个流程,为后续处理更大规模的数据集打下基础。
要运行这个项目,你需要以下Python包:
| 包名 | 用途 |
|---|---|
torch |
我们用于构建和训练神经网络的核心深度学习框架。 |
torchvision |
提供MNIST等数据集以及图像处理工具。 |
numpy |
用于数值计算和数组操作。 |
matplotlib |
用于绘制图表并可视化结果。 |
tqdm |
在训练过程中显示进度条。 |
对于这个项目,我将使用Visual Studio Code编辑器进行开发,但你们也可以使用任何其他喜欢的代码编辑器。
这是我们的项目结构。接下来我会结合项目中的代码来解释这些文件夹和文件的功能。
knowledge-distillation/
│
├── data/
│
├── models.py
│
├── engine.py
│
├── losses.py
│
├── train_teacher.py
│
├── train_student.py
│
├── train_distilled_student.py
│
├── evaluate.py
│
├── visualize.py
│
├── utils.py
│
├── plots.py
│
├── requirements.txt
│
└── README.md
在我们的文件夹结构中,第一个是data文件夹。这个文件夹里存放着我们的MNIST数据集。
models.py文件定义了项目中使用的所有神经网络的架构。其中包含了教师网络类和学生网络类,每个类都描述了网络的层结构、前向传播过程以及数据在网络中的流动方式。
import torch
import torch.nn as nn
import torch.nn.functional as F

class TeacherNet(nn.Module):

    def __init__(self):
        super().__init__()

        self.flatten = nn.Flatten()

        self.fc1 = nn.Linear(28 * 28, 1024)
        self.fc2 = nn.Linear(1024, 512)
        self.fc3 = nn.Linear(512, 256)
        self.fc4 = nn.Linear(256, 128)
        self.fc5 = nn.Linear(128, 10)

    def forward(self, x):

        x = self.flatten(x)

        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = Frelu(self.fc3(x))
        x = F.relu(self.fc4(x))

        logits = self.fc5(x)

        return logits


class StudentNet(nn.Module):
    """
    规模较小的神经网络(学生网络)
    """

    def __init__(self):
        super().__init__()

        self.flatten = nn.Flatten()

        self.fc1 = nn.Linear(28 * 28, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):

        x = selfflatten(x)

        x = F.relu(self.fc1(x))

        logits = self.fc2(x)

        return logos
utils.py文件负责准备数据集,并解答“这些数据集是从哪里获取的?”这个问题。在这个文件中,我们会下载MNIST数据集,对图像进行标准化处理,然后创建训练和测试数据加载器。
from torchvision import datasets, transforms
from torch.utils.data import DataLoader


def get_dataloaders(batch_size=64):
    """
    下载MNIST数据集(如需要),并返回训练和测试数据加载器。
    """

    transform = transforms.ToTensor()

    train_dataset = datasets.MNIST(
        root="data",
        train=True,
        download=True,
        transform=transform
    )

    test_dataset = datasets.MNIST(
        root="data",
        train=False,
        download=True,
        transform=transform
    )

    train_loader = DataLoader(
        train_dataset,
        batch_size=batch_size,
        shuffle=True
    )

    test_loader = DataLoader(
        test_dataset,
        batch_size=batch_size,
        shuffle=False
    )

    return train_loader, test_loader
engine.py文件中包含了可重复使用的学习算法,这些算法有助于实现训练过程。该文件会接收`model.py`中的代码,并对其进行训练。
import torch
from tqdm import tqdm


def train_one_epoch(
    model,
    dataloader,
    criterion,
    optimizer,
    device,
):
    model.train()

    running_loss = 0

    progress = tqdm(dataloader)

    for images, labels in progress:

        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        outputs = model(images)

        loss = criterion(outputs, labels)

        loss.backward()

        optimizer.step()

        running_loss += loss.item()

        progress.set_description(
            f"损失值:{loss.item():.4f}"
        )

    return running_loss / len(dataloader)


def evaluate(model, dataloader, device):

    model.eval()

    correct = 0
    total = 0

    with torch.no_grad():

        for images, labels in dataloader:

            images = images.to(device)
            labels = labels.to(device)

            outputs = model(images)

            _, predicted = torch.max(outputs, dim=1)

            total += labels.size(0)

            correct += (predicted == labels).sum().item()

    accuracy = 100 * correct / total

    return accuracy


def predict(model, images, device):

    model.eval()

    with torch.no_grad():

        images = images.to(device)

        outputs = model(images)

        _, predictions = torch.max(outputs, dim=1)

    return predictions

def train_distillation_epoch(
    teacher,
    student,
    dataloader,
    optimizer,
    device,
    loss_fn,
    temperature=4.0,
    alpha=0.5,
):
    """
    使用固定的教师模型来训练学生模型。
    """

    teacher.eval()
    student.train()

    running_loss = 0

    progress = tqdm(dataloader)

    for images, labels in progress:

        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        # 教师模型的预测结果(不计算梯度)
        with torch.no_grad():
            teacher_logits = teacher(images)

        # 学生模型的预测结果
        student logits = student(images)

        # 综合损失值
        loss = loss_fn(
            student_logits=student(logits,
            teacher_logs=teacher_logits,
            labels=labels,
            temperature=temperature,
            alpha=alpha,
        )

        loss.backward()

        optimizer.step()

        running_loss += loss.item()

        progress.set_description(
            f"蒸馏损失值:{loss.item():.4f}
        )

    return running_loss / len(dataloader)
losses.py文件定义了模型如何评估自身的错误程度。由于神经网络是通过最小化损失值来学习的,因此在基线可视化中使用了`CrossEntropyLoss`;而在知识蒸馏的过程中,则采用了`distillation_loss()`函数。
在这个文件中,我们通过交叉熵和K1散度结合了硬标签与软目标。杰弗里·辛顿的算法正是基于这种机制实现的。import torch
import torch.nn as nn
import torch.nn.functional as F
cross_entropy = nn.CrossEntropyLoss()
def distillation_loss(
student_logits,
teacher logits,
labels,
temperature=4.0,
alpha=0.5,
):
"""
Geoffrey Hinton提出的知识蒸馏损失函数
参数
----------
student_logs: 学生模型的输出结果
teacher_logs: 教师模型的输出结果
labels: 真实标签
temperature: 用于控制概率分布的“软度”
alpha: 衡量硬损失与软损失之间权重的参数
"""
# 硬标签损失
hard_loss = cross_entropy(student_logits, labels)
# 教师模型的软目标概率分布
teacher_probs = Fsoftmax(
teacher_logs / temperature,
dim=1
)
# 学生模型的软预测概率分布
student_log_probs = F.log_softmax(
student logits / temperature,
dim=1
)
# KL散度
soft_loss = F.kl_div(
student_log_probs,
teacher_probs,
reduction="batchmean"
)
# 最终的蒸馏损失
loss = (
alpha * hard_loss
+
(1 - alpha) * (temperature ** 2) * soft_loss
)
return loss
train_teacher.py文件用于训练教师模型。首次运行该脚本后,便不会再重新训练教师模型了。
import torch
import torch.optim as optim

from models import TeacherNet
from utils import get_dataloaders
from engine import train_one_epoch, evaluate
from losses import cross_entropy

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

teacher = TeacherNet().to(device)

optimizer = optim.Adam(
    teacher.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_one_epoch(
        teacher,
        train_loader,
        cross_entropy,
        optimizer,
        device,
    )

    accuracy = evaluate(
        teacher,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    teacher.state_dict(),
    "teacher.pth",
)

print("\n教师模型训练完成,保存成功。")
train_student.py文件用于训练学生模型。它的训练流程与train_teacher.py相同,只不过使用的模型规模较小,且不依赖教师模型的指导进行训练。通过这种方式可以获取学生在没有教师模型辅助情况下的基准表现。
import torch
import torch.optim as optim

from models import StudentNet
from utils import get_dataloaders
from engine import train_one_epoch, evaluate
from losses import cross_entropy

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

student = StudentNet().to(device)

optimizer = optim.Adam(
    student.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_one_epoch(
        student,
        train_loader,
        cross_entropy,
        optimizer,
        device,
    )

    accuracy = evaluate(
        student,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    student.state_dict(),
    "studentbaseline.pth",
)

print("\n学生模型的基准数据已保存成功。」
train_distilled_student.py是这段代码的核心。在这个文件中,我们利用标签以及教师的知识来训练学生模型。在这里,我们实现了基于响应的知识蒸馏机制。
import torch
import torch.optim as optim

from models import TeacherNet, StudentNet
from utils import get_dataloaders
from engine import (
    train_distillation_epoch,
    evaluate,
)
from losses import distillation_loss

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

# 加载教师模型
teacher = TeacherNet().to(device)
teacher.load_state_dict(
    torch.load(
        "teacher.pth",
        map_location=device,
    )
)

teacher.eval()

# 学生模型
student = StudentNet().to(device)

optimizer = optim.Adam(
    student.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_distillation_epoch(
        teacher,
        student,
        train_loader,
        optimizer,
        device,
        distillation_loss,
        temperature=3,
        alpha=0.7,
    )

    accuracy = evaluate(
        student,
        test_loader,
        device,
    )

    print(
        f"第 {epoch+1} 届训练 | 损失:{loss:.4f}"
        f| 准确率:{accuracy:.2f}%"
    )

torch.save(
    student.state_dict(),
    "student_distilled.pth",
)

print("\n蒸馏后的学生模型已保存成功。")
evaluate.py用于检测训练好的模型的性能。在这里,我们只需加载模型、加载测试数据、进行预测并计算准确率即可。
import torch

from models import TeacherNet
from utils import get_dataloaders
from engine import evaluate

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

_, test_loader = get_dataloaders()

teacher = TeacherNet().to(device)

teacher.load_state_dict(
    torch.load(
        "teacher.pth",
        map_location=device,
    )
)

accuracy = evaluate(
    teacher,
    test_loader,
    device,
)

print(
    f"教师模型的准确率:{accuracy:.2f}%"
)
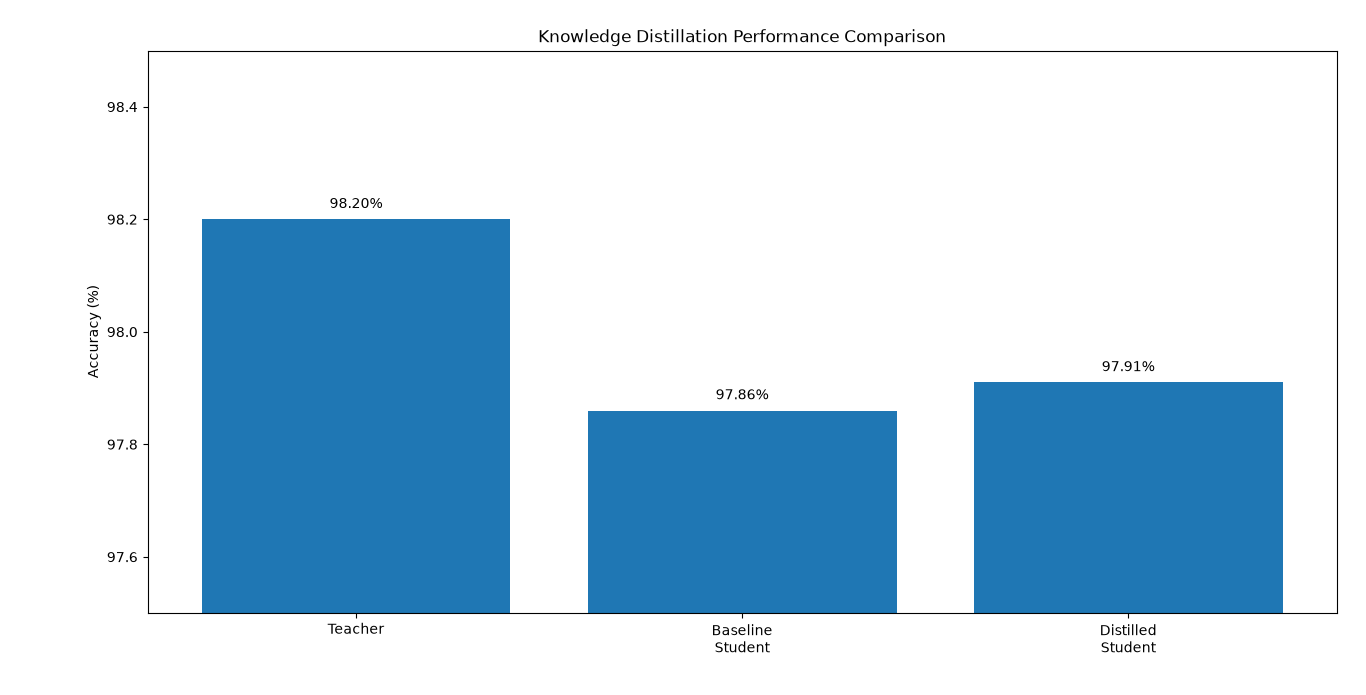
visualize.py这个文件用于以可视化的方式展示我们的实验结果。我们使用了Python的matplotlib库来呈现教师模型、基线学生模型以及蒸馏后学生模型的性能数据。
import matplotlib.pyplot as plt

models = [
    "Teacher",
    "Baseline\nStudent",
    "Distilled\nStudent"
]

accuracy = [98.20, 97.86, 97.91]

plt.figure(figsize=(7,5))
plt.bar(models, accuracy)

plt.title("知识蒸馏性能对比")
plt.ylabel("准确率 (%)")

for i, v in enumerate(accuracy):
    plt.text(i, v + 0.02, f"{v:.2f}%", ha="center")

plt.ylim(97.5, 98.5)

plt.tight_layout()
plt.savefig("accuracy_comparison.png", dpi=300)
plt.show()
下面您可以看到我们整个程序的工作流程,从而了解各个部分是如何协同工作的: utils.py
│
加载MNIST数据集
│
▼
models.py
TeacherNet / StudentNet
│
▼
losses.py
交叉熵损失函数 + 蒸馏损失函数
│
▼
engine.py
通用训练与评估功能
┌────────────┼────────────┐
│ │ │
▼ ▼ ▼
train_teacher.py train_student.py distilled_student.py
│ │ │
▼ ▼ ▼
teacher.pth studentbaseline.pth distilled.pth
│
▼
evaluate.py
计算最终准确率
│
▼
visualize.py
生成图表与实验结果图如何评估结果
现在,让我们来检查并评估一下我们的实验结果。这些截图是针对教师网络、学生网络以及优化后的学生网络分别运行10个训练周期后得到的。
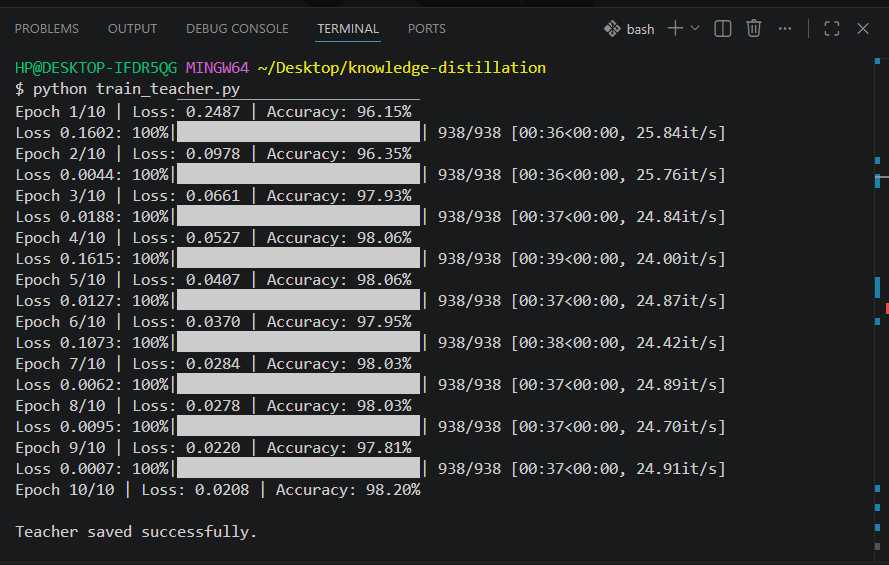
教师网络:在完成10个训练周期后,我们获得了98.20%的准确率。
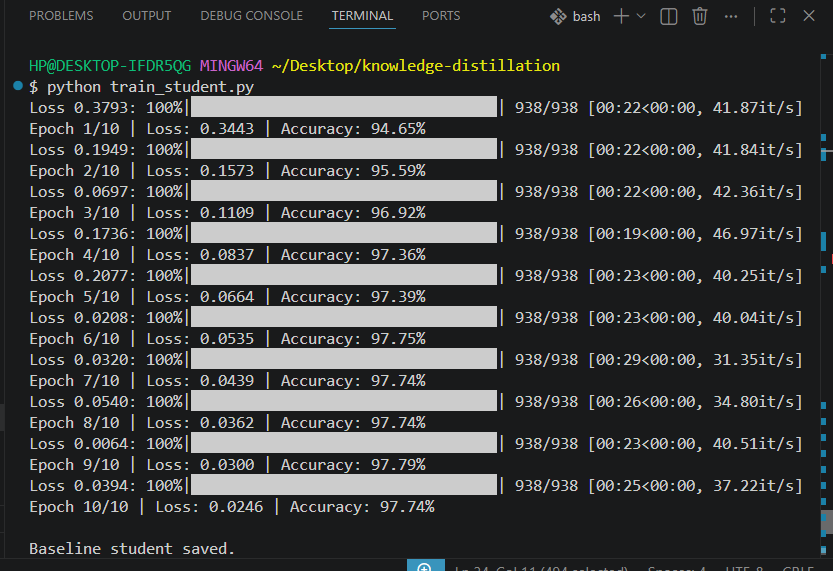
学生网络:在完成10个训练周期后,我们获得了97.74%的准确率。对于一个没有教师模型作为参考的小型网络来说,这个成绩已经相当不错了。
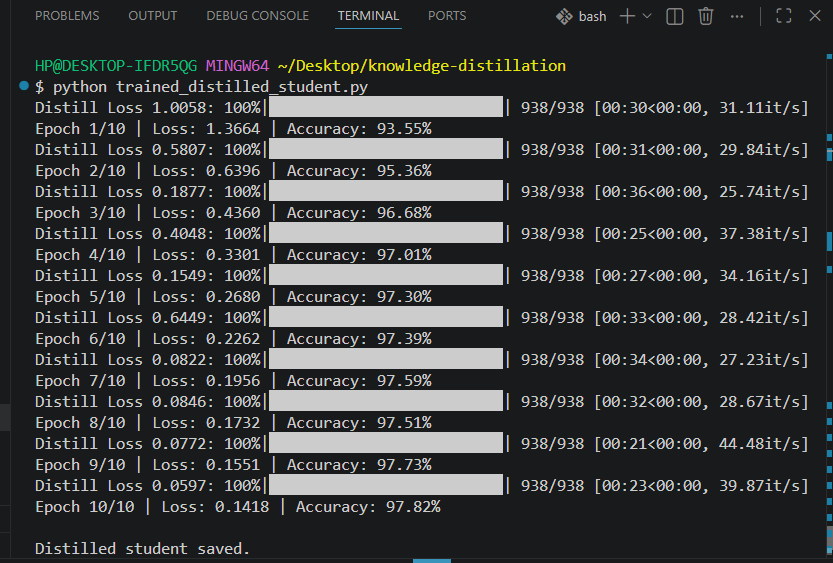
优化后的学生网络:在完成10个训练周期后,我们同样获得了98.20%的准确率。与没有教师模型时的97.74%相比,这一成绩确实有所提升。
请查看下图,了解各模型的具体表现:
减少模型规模的其他方法
现在我们已经通过实际代码示例了解了模型蒸馏技术,接下来让我们看看开发者们还采用了哪些其他方法来缩小大型语言模型的规模,从而降低延迟、减少内存占用并节省计算成本,同时了解这些方法与模型蒸馏有何不同。
在这方面,我们有三种主要的解决方法:
量化
量化技术通过严格限制用于存储神经网络数值权重和激活值的底层数据类型的位宽来提高效率。它的目标在于解决内存带宽的限制问题,而非调整模型架构本身。
简单来说,量化技术可以将32位的数值转换为8位的数值,这样就能使文件大小减少约75%。
举个现实生活中的例子:在打印教科书时,量化技术就类似于通过使用低分辨率字体来节省墨水和纸张;而模型蒸馏则更像是对原有内容进行压缩和精简。
剪枝
剪枝的原理在于:大型语言模型中往往存在大量冗余且对模型性能影响较小的参数。通过去除这些弱连接,模型可以变得更小、运行速度更快。
用教材来打比方的话,剪枝过程就相当于翻阅教材时,将那些你觉得没有必要的页面或章节撕掉。
低秩分解
这是一种利用线性代数简化深度学习架构中占主导地位的矩阵乘法运算的数学方法。
举个例子来说,这个过程就是把复杂的句子改写成意义相同但结构更简单、更简洁的表达式。
选择哪种方法取决于你试图解决的瓶颈问题。量化技术通常适用于解决内存限制带来的问题,而剪枝和蒸馏技术则旨在减少计算时间。
结论
知识迁移对人工智能而言,就如同它对人类历史一样重要。正如亚里士多德在柏拉图的理论基础上进行了进一步发展一样,如今那些高效且可部署的神经网络,也是建立在从庞大的、计算资源消耗巨大的训练模型中提取出的基础性知识之上的。
虽然训练参数数量高达万亿的前沿模型需要耗费大量的硬件资源和资金,但知识蒸馏技术确保了这些技术的实际应用效果不会被庞大的计算瓶颈所限制。
正如我们在PyTorch MNIST实验中所展示的那样,即使是简单的基于响应的知识蒸馏技术,也能帮助规模较小的模型通过学习大型训练模型的概率分布信息,从而发挥出超出其本身能力的性能。
当知识蒸馏技术与量化、剪枝等其他优化方法结合使用时,它为在边缘设备、手机以及消费级硬件上部署功能强大的人工智能系统提供了一条清晰的路径。
感谢您的阅读!欢迎关注我的YouTube频道,我在那里会发布许多与人工智能相关的视频内容。
参考文献:
相关文章
如何使用TypeScript从零开始构建一个AI代理程序
许多关于AI代理的教程都是从语言模型开始讲起,为它提供一些工具,然后让它运行循环直到产生答案。这样的做法确实足以展示这些工具的使用方法,但却没有回答那些有趣的工程学问题。 当某个工具出现故障时会发生什么?谁来验证这些操作的结果?是什么机制能防止代理无限期地运行、执行不安全的命令,或者耗尽其上下文信息?又如何在不依赖模型不可预测的响应的情况下测试这些功能呢? 这些职责都属于 代理框架 ——也就是位于语言模型与其所运行的环境之间的那层软件。 在本次教程中,我们将使用TypeScript来构建一个小型且与具体工具提供商无关的代理框架,并以编码代理作为示例进行讲解。我们会从基本的执行循环开始,逐步添加
阅读全文
演讲主题:25万亿枚代币究竟揭示了什么?这些数据能帮助我们了解开发者们实际上是如何运用人工智能代理技术的。
Brendan O’Leary探讨了现实世界中人工智能的普及程度实际上取决于人们是否能够建立起对相关技术的信任,而非仅仅追求各种模型评估指标。他利用多达40万亿条使用数据,详细解释了人工智能普及过程中的四个关键阶段,并分析了在信息构建、多模型协同处理以及反馈机制等方面可能出现的故障点,这些分析有助于工程领域的领导者成功推进基于人工智能的工作流程的规模化应用。 作者:Brendan O’Leary
阅读全文
在您的CPU上从零开始构建并训练一个拥有2500万参数的大型语言模型
你并不需要庞大的GPU集群来了解现代前沿人工智能的运作原理。在freeCodeCamp.org的YouTube频道上发布的新视频中,你可以直接在自己的笔记本电脑或普通CPU上构建、预训练并微调这个拥有2500万个参数的语言模型。 虽然前沿实验室会使用拥有数十亿个参数的大型系统进行训练,但其核心架构、数学原理和工作流程其实都是相同的。将模型的参数数量减少到2500万,并使用简洁的词汇表,就能大幅降低对昂贵云计算资源的依赖,使得训练过程能够在几秒钟内就在你的CPU上完成。这种快速的迭代机制让你能够实时观察到数据集、损失函数及奖励机制的变化如何影响模型行为。 本课程涵盖以下内容: 现代大语言模型架构
阅读全文
如何使用Next.js、Supabase以及TypeSafe Jev来构建一个用于筛选人工智能相关简历的工具
每当我们发布一份工程招聘启事时,一周内就会收到300到400份简历。仔细阅读每一份简历大约需要两分钟的时间。因此,仅仅为了处理一个职位空缺,我们在开始任何面试之前就已经要花费11个小时来处理这些简历了。 但实际上,并没有人会真的去阅读每一份简历。相反,人力资源部门会进行快速的筛选工作。他们会快速浏览应聘者的职位名称、工作经验年限以及所掌握的技术框架,然后在大约15秒的时间内,将简历分为“需要进一步查看”和“可能不符合要求”两类。当他们看到第40份简历时,他们对这份简历的关注程度就已经远远低于对第4份简历时的关注了。 我们的目标就是取代这种快速筛选的过程,而不是放弃阅读简历这一环节。当阅读简历确
阅读全文