
如何使用Gemini与Vercel的无服务器功能来构建AI聊天机器人🚀
几个月前,我使用React、Node.js以及Vercel Serverless Functions构建了一个聊天机器人应用程序,并将其应用到了我的网站 buildcv.makeadifference.app 中。在本次教程中,我将详细向您讲解我是如何构建这个应用程序的——从与Google的Gemini API进行交互的后端无服务器函数,到用于显示AI生成响应内容的React聊天组件,都会一一为您介绍。完成本教程后,您将了解以下内容: 如何配置Vercel Serverless函数,使其能够调用Gemini API,并将生成的响应以小段文本的形式实时传输给浏览器。 为什么采用这种技术能让聊天机
如何配置Vercel Serverless函数,使其能够调用Gemini API,并将生成的响应以小段文本的形式实时传输给浏览器。
为什么采用这种技术能让聊天机器人显得更加快速、反应更灵敏——因为用户不必等待所有回复内容一次性全部传回才才能看到结果。
如何开发React组件,以便能够读取这些实时传输的响应数据,并在新的文本内容到达时立即更新聊天窗口。
下面是整个流程从开始到结束的运作方式:浏览器向Vercel函数发送请求,Vercel函数再调用Gemini API,而Gemini的响应会分块逐个传回浏览器。
实际上,这意味着后端会在响应数据生成完成后分小部分将其发送给前端,而不是让用户等待所有数据全部准备好后才看到任何内容。
✅ 先决条件
在开始之前,请确保你已经具备以下条件:
已在本地安装Node.js(版本为18或更高)
从Google AI Studio获取的Gemini API密钥 🔑
拥有一个Vercel账户
,并熟悉Vercel命令行工具在你的函数项目中安装了
@google/genai包,你可以通过运行npm install @google/genai来添加这个包
在进行本地开发时,建议将API密钥存储在名为process.env.GOOGLE_API_KEY的环境变量中;在部署应用程序之前,也请在Vercel项目的控制面板中设置这个环境变量(位于“设置”→“环境变量”选项下),这样应用程序上线后就能正确使用该API密钥了。
📜 API协议
在开始研究代码之前,先了解一下前端与后端之间的“协议”是很重要的——也就是说,前端应该发送什么数据,后端又期望收到什么样的响应。
当用户在聊天窗口中发送消息时,前端会向/api/chat发送一个POST请求,请求体中包含两部分内容:用户输入的文本信息,以及已经加载到应用程序中的简历数据(因为这个聊天机器人具有提供简历指导的功能)。后端会结合这两部分信息来生成针对该用户的具体回复,而不会给出通用的回应。
请求示例:
POST /api/chat
{
  "message": "我该如何改进我的简历摘要?",
  "resume": { "name": "...", "experience": [...], "skills": [...] }
}
⚙️ 后端(Vercel无服务器函数)
这就是整个应用程序的核心:一个单一的Vercel无服务器函数,它接收聊天请求、对其进行验证,然后将其传递给Gemini API,同时将AI生成的响应分块实时传回浏览器。
下面是完整的处理逻辑代码,在了解整体结构后,我会逐一解释其中各部分的功能。
const { GoogleGenAI } = require("@google/genai");
const ai = new GoogleGenAI({
    apiKey: process.env.GOOGLE_API_KEY,  // GOOGLE_API_KEY可以在Vercel中配置
});
const MAX_TEXT_LENGTH = 2000;
const MAX_ARRAY_LENGTH = 50;

function sanitizeString(input = "") {
    // 在这里对输入的字符串进行清洗处理
}

function sanitizeObject(obj = {}) {
    // 对传入的对象进行清洗处理
}

const allowCors = fn => async (req, res) => {

    res.setHeader('Access-Control-Allow-Origin', '<<你的Web应用地址在这里>>'
    res.setHeader('Access-Control-Allow-Methods', 'GET, POST, OPTIONS');
    res.setHeader('Access-Control-Allow-Headers', 'Content-Type, Authorization');

    // ✅ 处理预检请求
    if (req.method === 'OPTIONS') {
        return res.status(200).end();
    }
    // 另一种处理方式
    res.setHeader('Access-Control-Allow-Methods', 'GET, HEAD, OPTIONS, POST, PUT, DELETE')
    res.setHeader(
        'Access-Control-Allow-Headers',
        'X-CSRF-Token, X-Requested-With, Accept, Accept-Version, Content-Length, Content-MD5, Content-Type, Date, X-Api-Version'
    )
    if (req.method === 'OPTIONS') {
        res.status(200).end()
        return
    }
    return await fn(req, res)
};

const handler = async (req, res) => {

    if (req.url === '/api/chat' && reqmethod === 'POST') {

        const { message, resume } = req.body || {};

        const safeMessage = sanitizeString(message);
        const safeResume = sanitizeObject(resume);

        if (!safeMessage) {
            return res.status(400).json({ error: "输入的信息无效" });
        }

        if (!safeMessage || !safeResume) {
            return res.status(400).json({ error: '缺少信息或简历数据' });
        }

        try {
            const stream = await ai.models.generateContentStream({
                model: "<<>这里填写GEMINI模型名称>>",
                contents: `
            你是一位专业的简历辅导AI。

            - 总会给出清晰、礼貌且专业的回复。
            - <根据你的需求添加具体的提示指令>
            - 简历信息:
${JSON.stringify(safeResume, null, 2)}

用户问题:
${safeMessage}
`,
            });
            res.setHeader("Content-Type", "text/plain; charset=utf-8");
            res.setHeader("Cache-Control", "no-cache");

            for await (const chunk of stream) {
                const text = chunk.text;
                if (text) {
                    res.write(text);
                }
            }

            res.end();
        } catch (error) {
            console.error('GEMINI出现错误:', error);
            res.status(500).json({ error: 'AI请求失败' });
        }
    }

    // 我添加了一个健康检查接口用于测试handler
    if (req.url === '/api/chat?type=healthcheck' && req.method === 'GET') {
        res.status(200).json({ message: '来自聊天端点的问候!' });
    }
}

module.exports = allowCors(handler)
现在,让我们逐一分析这些步骤:
配置 Gemini 客户端: 在文件的开头部分,我们使用存储在 `
GOOGLE_API_KEY` 环境变量中的 API 密钥来创建一个GoogleGenAI客户端。在后续的代码中,我们将通过这个客户端与 Gemini 进行交互。清理输入数据: 在处理传入的请求之前,我们会使用 `
sanitizeString` 和 `sanitizeObject` 函数对消息内容和简历信息进行清洗。这些函数会删除任何异常或过长的数据,因此我们绝不会在未经检查的情况下直接将不可信的用户输入传递给 AI。处理 CORS 请求: `allowCors` 包装函数用于处理跨源资源共享相关的问题。由于聊天组件可能被嵌入到与 Vercel 函数所在域名不同的网站上,因此我们需要明确允许来自该域名的请求,并处理浏览器在发送实际的 `
POST` 请求之前会自动发出的 `OPTIONS` 预检请求。验证请求内容: 在处理请求的逻辑中,我们会检查 `message` 和 `resume` 这两个字段是否已经通过了清洗流程。如果其中任何一个字段缺失或无效,我们会立即返回 400 错误码,而不会浪费资源去处理一个已知有问题的请求。
调用 Gemini 并获取响应数据: 这是整个教程的核心部分。我们没有使用常规的 “生成内容” 方法并等待完整的响应结果返回,而是调用了 `
generateContentStream` 函数——该函数会返回一个异步可迭代对象。我们通过 `for await...of` 循环来处理这个数据流,每当有新的文本片段出现时,就会立即使用 `res.write(text)` 将其写入响应结果中。正是这种机制使得浏览器能够在 Gemini 完成全部内容生成之前就开始接收文本数据。错误处理与健康检查: 如果在与 Gemini 交互的过程中出现任何问题,我们会捕获错误并记录日志,然后返回 500 错误码,以便前端能够知道发生了什么故障。此外,还有一个简单的 `
GET` 健康检查接口,你可以通过它来确认函数是否正常运行,然后再开始测试实际的聊天流程。
🧪 在搭建前端界面之前先测试端点
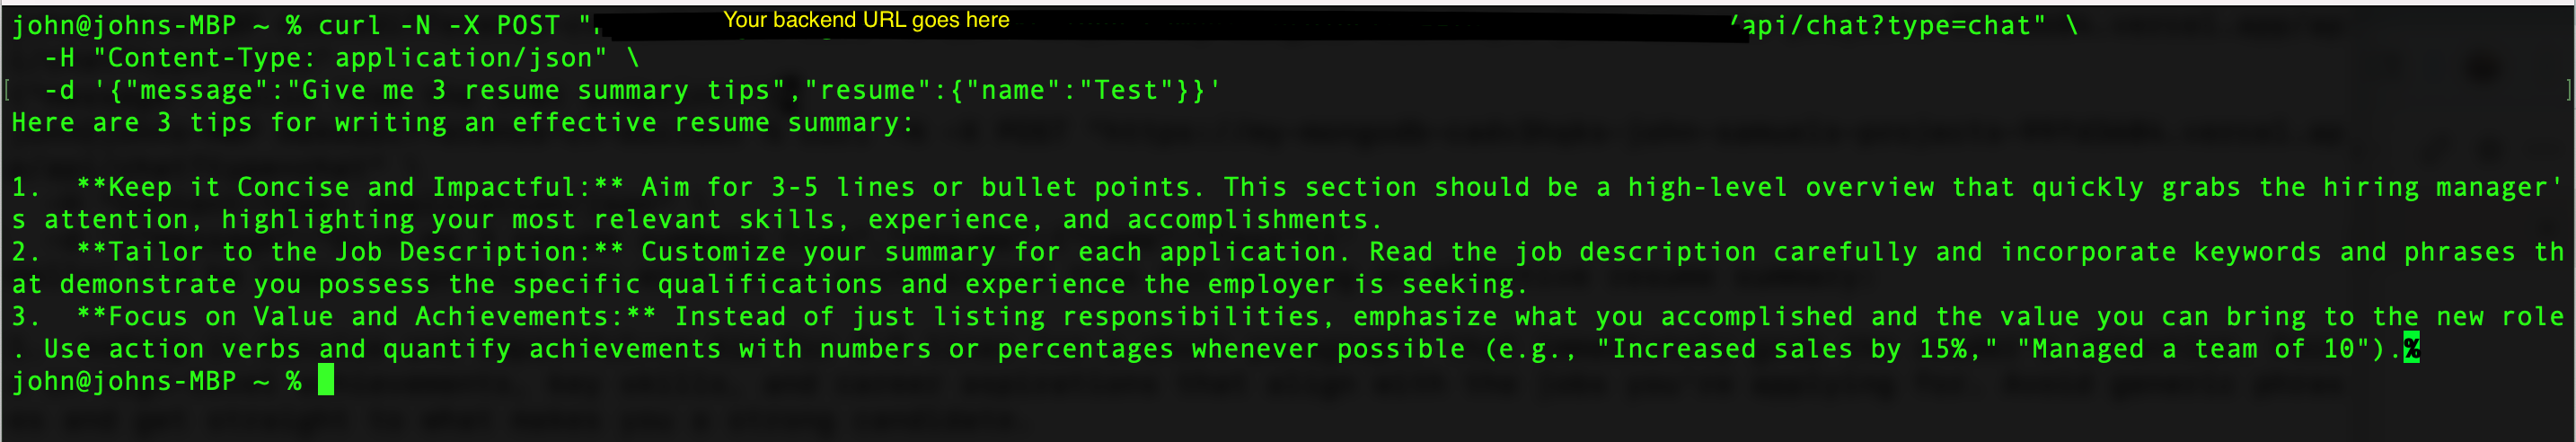
在开始开发前端界面之前,最好先确认这个无服务器函数是否真的能够按照预期的方式发送数据片段。你可以使用简单的 `curl` 命令来验证这一点。
curl -N -X POST "https://YOUR_APP.vercel.app/api/chat?type=chat" \
  -H "Content-Type: application/json" \
  -d '{"message":"Give me 3 resume summary tips","resume":{"name":"Test"}}'
-N选项会禁用curl的输出缓冲功能,因此你会在终端中逐渐看到输出内容,而不会一次性全部显示出来。这样,在你编写任何前端代码之前,就能确认数据流传输过程是否正常进行。
🎨 前端:读取响应数据流
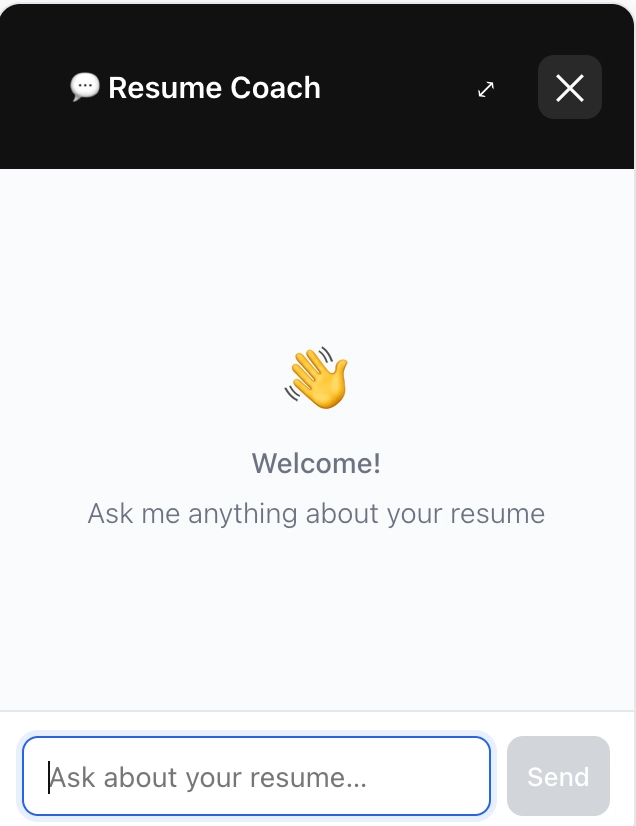
这是我用React构建的聊天界面的截图:
我们不会在这里从头开始讲解如何构建这个界面。界面的布局、样式以及消息列表的显示方式,完全取决于你自己的设计需求。
我们要讨论的是实现这一功能的核心代码:也就是点击“发送”按钮后执行的那个函数。该函数会接收用户输入的内容,将其发送到我们的无服务器函数中,然后读取返回的数据流,从而让聊天界面能够逐条显示AI生成的回复内容,就像你在上面的截图中看到的那样。
在深入探讨这个函数之前,先来看看它所在的代码结构,这样你就能了解它在整个组件中的位置了:
function ChatWidget({ resume }) {
const [messages, setMessages] = useState [];
const [input, setInput] = useState("");
const [loading, setLoading] = useState(false);
const [error, setError] = useState(null);
async function sendMessage() {
// ...实际的功能代码放在下面
}
return (
);
}
这就是这个函数所在的代码结构:包含了消息列表的状态、输入框的状态、一个表示加载状态的标志,以及一个用于存储错误信息的字段。sendMessage函数会在用户点击“发送”按钮时被调用。
下面是完整的sendMessage函数代码。每当用户输入内容并点击“发送”按钮时,这个函数就会被执行。正是这段代码将上面展示的界面与我们刚刚构建的后端服务连接了起来。
async function sendMessage() {
const messageText = input.trim();
if (!messageText || loading) return;
const userMessage = { role: "user", text: messageText };
setMessages((message) => [...message, userMessage]);
setInput("");
setLoading(true);
setError(null);
try {
const res = await fetch("<<你的Vercel无服务器函数地址>>/api/chat", {
method: "POST",
headers: { "Content-Type": "application/json" },
body: JSON.stringify({ message: messageText, resume })
});
if (!res.ok) {
throw new Error(`获取响应失败:${res.status}`);
}
const reader = res.body.getReader();
const decoder = new TextDecoder();
let fullText = "";
setMessages((message) => [...message, { role: "assistant", text: "" }]);
while (true) {
const { value, done } = await reader.read();
if (done) break;
const chunk = decoder.decode(value);
fullText += chunk;
setMessages((message) => {
const updated = [...message];
updated[updated.length - 1] = { role: "assistant", text: fullText };
return updated;
});
}
} catch (err) {
setError("发送消息失败。请重试.");
setMessages((m) => [...m, {
role: "assistant",
text: "抱歉,发生了错误。请稍后再试。”
}));
} finally {
setLoading(false);
}
}
以下是整个过程的详细步骤:
首先,当用户点击“发送”按钮时,我们会获取他们输入的消息内容,并立即将其添加到`messages`数组中,这样消息就会立刻显示在聊天界面中。
接着,我们会向`/api/chat`端点发送一个`POST`请求,将消息内容以及相关数据一同传递过去。收到响应后,我们会调用`res.body.getReader()`来获取响应体中的`ReadableStreamDefaultReader`对象,然后使用`TextDecoder`将每一段原始字节数据转换为可读文本。
之后,我们通过循环逐段读取这些文本,并将其添加到不断增长的`fullText`字符串中;每次循环都会更新聊天界面中显示的最新消息内容。
正是这个循环机制才产生了你在截图中看到的“打字”效果:助手的消息会随着新内容的逐步到达而一点点显示出来,而不是全部一次性呈现。这种处理方式与你们通常使用的`fetch().then(res => res.json())`调用方式有所不同,因此如果你之前没有经历过类似的操作流程,那么仔细了解一下这个过程是很有必要的。
🚀 部署
在确认函数和用户界面在本地都能正常运行之后,部署其实只需要三个步骤:
在Vercel中设置环境变量。进入项目控制面板,选择“设置”→“环境变量”,然后添加`GOOGLE_API_KEY`,其值应与你在本地使用的值保持一致。
更新CORS配置及数据获取URL。在后端代码中,将`allowCors`配置中的`Access-Control-Allow-Origin`头指向实际部署的域名;在前端代码中,使用该部署后的函数地址代替`localhost`进行数据请求。
开始部署。根据你的工作流程选择合适的部署方式即可。
选项A:通过CLI进行部署
npm install -g vercel # 如果你还没有安装的话
vercel login
vercel --prod
执行`vercel login`命令可以登录到Vercel管理界面,而`vercel --prod`则会直接从项目目录构建并部署代码到生产环境。这种方式非常适合一次性部署,或者当你需要精确控制部署时间时使用。
选项B:通过GitHub集成进行部署
如果你的项目还没有托管在GitHub上,请先将其推送到相应的仓库中。
在Vercel控制面板中,点击“添加新项目”,然后选择你的仓库。
Vercel会自动检测你的框架配置,确认无误后即可开始部署。
此后,每次向主分支推送代码时,系统都会自动触发重新部署过程。
我一直更喜欢这个选项,如果你正在积极地对项目进行迭代开发,那么这个选项会显得更加方便,因为你根本不需要自己去记得执行部署命令。部署完成后,Vercel会为你提供应用程序的在线URL。你可以使用之前使用的curl命令进行测试,只需将URL替换为生产环境的地址,从而确认在正式环境中数据流传输功能能够正常工作,之后才能认为任务完成。
⚠️ 关于嵌入式小部件的CORS注意事项
如果你打算将这个聊天小部件嵌入到与你的Vercel应用程序属于不同域名的网站上(例如,将其作为小部件嵌入到一个营销网站中,而其功能本身则部署在其他地方),那么默认情况下你会遇到CORS限制。除非服务器明确允许,否则浏览器会阻止对不同源地址的请求。
为了解决这个问题,你的无服务器函数需要响应浏览器在发送实际的POST请求之前自动发出的OPTIONS预检请求,并且需要设置Access-Control-Allow-Origin头部字段,使其与你的小部件实际运行的域名相匹配。上面后端代码中的allowCors封装函数正是用来实现这一点的。
🎉 总结
纯文本分块传输技术使得聊天机器人能够在Vercel平台上展现出良好的响应速度。因为用户能够逐渐看到回复内容,所以他们不必等待所有回复信息生成完毕才能在屏幕上看到任何内容。
如果你想进一步扩展这个功能,以下是一些可以考虑的后续步骤:添加速率限制机制以防止对端点的滥用;使用KV存储、Redis或Postgres等工具来实现对话内容的持久化保存,这样在刷新页面时聊天记录就不会丢失;为小部件添加“停止”按钮,让用户能够取消正在生成中的回复。
如果你用这种方法开发了什么产品,我很乐意听到你的分享!你计划用Gemini和Vercel构建什么呢?
祝你们这一周一切顺利!😇
相关文章
技术实践
我在自己的网站上添加了CDN缓存,结果网站的加载速度反而变慢了。其实我应该先进行一些计算或分析才采取这个措施。
上周,我在一个静态网站前面加入了CDN缓存,本以为这样会让访问速度变快。 然而结果却恰恰相反——访问速度明显变慢了。这种变化非常明显:在调整之前,有一个独立的爬虫工具检测到了38个页面加载缓慢;而在调整之后,这个工具检测到的缓慢页面数量增加到了 75个 。 我在当天就恢复了原来的设置。下面我将说明到底发生了什么、为什么会出现这种结果,以及如果我在部署之前进行某个计算,就能避免这个错误。 目录 先决条件 设置过程 我做了哪些更改 最终结果 为何会适得其反,第一部分:犯错是要付出代价的 为何会适得其反,第二部分:爬虫工具的反应总是迟缓的 我本应该先进行的计算 那个令人后悔的决定 一个值得保留的方法
阅读全文
技术实践
如何使用Hono和Zod构建类型安全的API
如果你之前曾经开发过 Node.js API,那么你就应该了解这种麻烦:TypeScript 中定义的类型与运行时验证的结果不一致,而 OpenAPI 文档的内容也与这两者都不同。 有时有人会在接口中添加新的字段,但相应的模式文件却从未得到更新。因此,文档内容会一直保持过时的状态,直到有客户端提交错误报告为止。这种情况下,既不会出现编译错误,也不会有测试失败的情况——这三个信息来源就这样出现了分歧。 在本教程中,你将学习如何使用 Hono 和 Zod 将这些问题统一起来。你会学到我在实际开发中使用的那些模式,包括我在维护的开源视频处理工具包 ClipForge 中所采用的方案。这些方法能够确保
阅读全文
技术实践
如何使用JavaScript开发一款可将基于浏览器的图像故事板转换为PDF格式的工具
在任何人开始拍摄视频、制作广告或绘制漫画的最终画面之前,通常会先画出一份故事板草图:按照拍摄顺序为每一镜头绘制一幅图片,并附上简短的说明,说明该镜头中发生了什么以及持续时间有多长。 大多数人已经拥有这些图片了——它们可能是手机照片、截图、粗略的草图,或者是通过人工智能生成的图像文件,这些文件都保存在某个文件夹里。但他们所缺乏的是一种能够将这些文件快速整理成格式规范、编号整齐的文档,并将其打印出来或发送给客户的工具。 在这个教程中,你将学习如何制作这样一个基于浏览器的工具。你需要添加一组图片,为每张图片指定标题、描述和持续时间,选择合适的布局方式,预览生成的文档,然后下载可供打印的PDF文件。
阅读全文
技术实践
演讲主题:利用OpenTelemetry消除排队环节中的瓶颈问题
Oli Lane和Julian Wreford介绍了如何利用OpenTelemetry追踪技术来取代分布式异步队列中的猜测性分析方法。他们解释了为什么传统的监控指标无法满足实际需求,说明了如何根据延迟分布来制定以用户为中心的服务水平目标,并提供了实用的调试技巧,这些内容有助于高级开发人员、软件架构师和工程团队领导者提升系统的可靠性并改善团队协作氛围。 作者:Julian Wreford, Oli Lane
阅读全文