
如何将RECIST曲线转换为三维肿瘤分割掩膜
放射科医师可以通过在CT扫描图像中绘制一条直线来标记肿瘤的位置。而要完成完整的3D分割,就需要在肿瘤出现的所有切片中都标出其边界,这个过程耗时较长。 本教程介绍了Lumina的工作原理。该系统利用CT扫描图像以及RECIST标记线,生成被标记肿瘤的3D分割掩膜。 Lumina是专为 FLARE 2026泛癌症分割挑战赛 开发的。该系统设计用于在内存限制为8GB、推理时间上限为60秒的CPU上运行。 本教程涵盖了形成最终系统的各项关键设计决策、实现细节以及相关实验内容。 我们将涵盖以下内容: Lumina的功能 Lumina处理流程概述 先决条件 步骤1:编码前请先审核您的数据 扫描图像已经过亮
放射科医师可以通过在CT扫描图像中绘制一条直线来标记肿瘤的位置。而要完成完整的3D分割,就需要在肿瘤出现的所有切片中都标出其边界,这个过程耗时较长。
本教程介绍了Lumina的工作原理。该系统利用CT扫描图像以及RECIST标记线,生成被标记肿瘤的3D分割掩膜。
Lumina是专为FLARE 2026泛癌症分割挑战赛开发的。该系统设计用于在内存限制为8GB、推理时间上限为60秒的CPU上运行。
本教程涵盖了形成最终系统的各项关键设计决策、实现细节以及相关实验内容。
我们将涵盖以下内容:
Lumina的功能
放射科医生可以通过在肿瘤最长的可见直径上画一条线来测量其大小。这种测量方法被称为RECIST测量(实体瘤反应评估标准),它在癌症治疗过程中被广泛用于检测肿瘤的反应情况。
RECIST测量所使用的线条仅表示肿瘤的二维直径,无法反映肿瘤的三维形态。
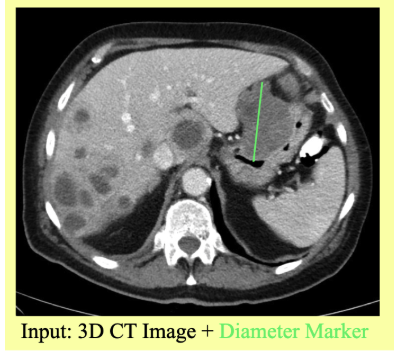
Lumina利用这种测量结果来驱动三维分割模型的运行。
这一过程可以描述为:
输入:一份三维CT扫描图像,以及一条用于标记肿瘤位置的二维RECIST线。
输出:该肿瘤的三维掩膜图像,其中每个体素都会被赋予一个标签。
体素是像素在三维空间中的对应概念。每个体素代表CT扫描图像中一小块组织。
RECIST线为模型指明了需要分割的目标肿瘤,随后模型会预测出该肿瘤的三维范围。
这样的设计使得分割任务变得更加具体,因为模型无需识别扫描图像中所有可能的肿瘤区域。
Lumina处理流程概述
整个处理过程包含多个步骤。首先,我们需要获取一份三维CT扫描图像以及一条用于标记肿瘤位置的RECIST线;接着,我们将这条线条转换成额外的输入数据,对图像进行裁剪和重采样处理,最后将这些处理后的数据输入到三维分割模型中。
该模型会生成一个概率分布图,我们通过进一步的重采样、阈值处理及连通组件分析,将这个概率图转化为最终的三维肿瘤掩膜图像。
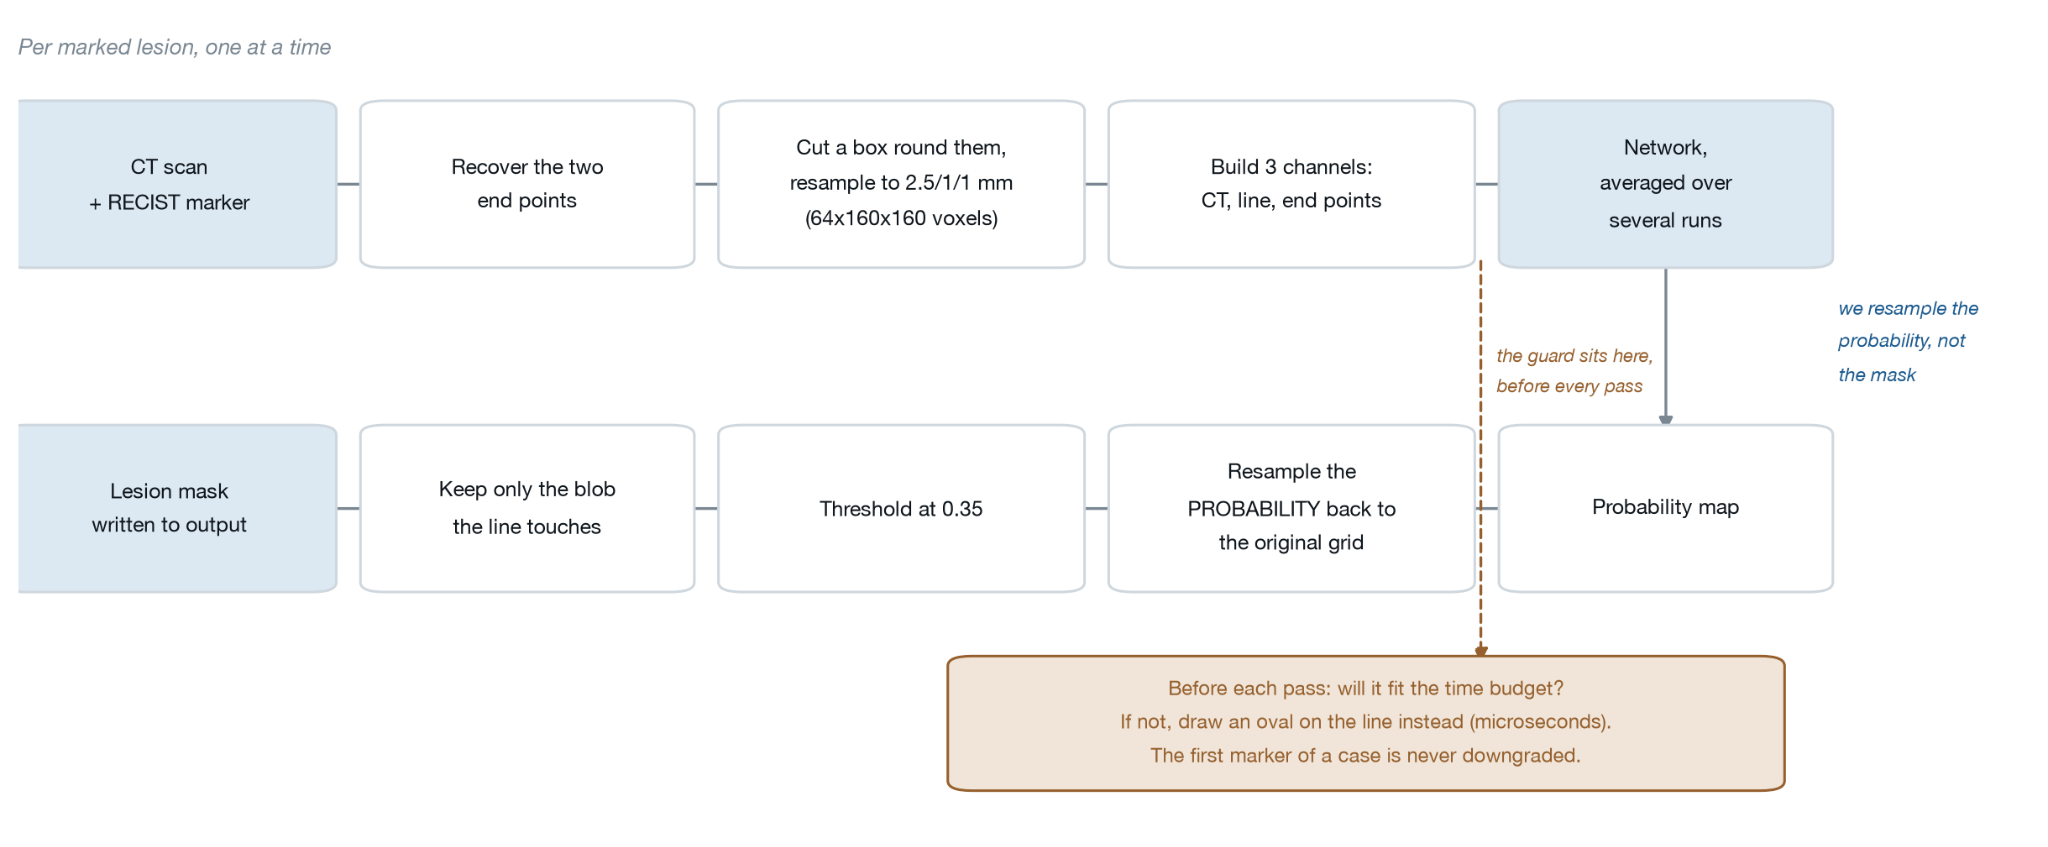
主要步骤包括:
准备CT扫描图像及RECIST标记线。
将RECIST标记线编码为模型可识别的输入数据。
对图像进行裁剪和重采样,使其符合统一的网格格式。
利用三维分割模型预测肿瘤的位置及范围。
优化概率分布图的结果,将其转换为二值掩膜图像。
控制计算资源的消耗,确保整个处理过程在规定的时间和内存范围内完成。
先决条件
如果您具备以下经验,那么学习本教程会更加顺利:
Python编程语言
NumPy库
PyTorch框架
对卷积神经网络的基本了解
本教程并不要求读者具备深厚的医学背景,其中涉及的医学成像概念会在讲解过程中逐步说明。
该实现使用了NumPy、SciPy、PyTorch以及MONAI——这个基于PyTorch构建的医学影像分析框架。
步骤1:在开始编码之前先审查你的数据
我们使用的是以`.npz`格式保存的数据文件,这种格式是NumPy用于存储压缩数组的格式。
每个文件中都包含以下类似的结构:
imgs       # CT扫描结果,表现为三维数组
recist     # 标记线信息,形状与图像相同,每个肿瘤对应一个整数
spacing    # 体素之间的距离(以毫米为单位)
origin     # 扫描数据在扫描仪坐标系中的位置
direction  # 扫描数据的旋转方向
gts        # 真实分割结果,仅用于训练
在构建模型之前,我们仔细检查了这些数据的图像值、数组结构以及空间元数据。
其中有两个细节尤为重要。
扫描数据已经过亮度调整
通常情况下,CT扫描仪会使用Hounsfield单位来存储图像数据。水的Hounsfield值为0左右,而骨头的值则可能超过1000。
在这个数据集中,所有扫描数据的数值范围已经被统一调整为0到255之间。因此我们无法直接使用常规的CT数据处理方法来处理原始数据。
为此,我们必须先测量所提供的数据中的强度分布情况。例如,在这些数据中,有53.4%的体素的数值恰好为0,这对应于人体外的空气。
坐标顺序非常重要
`spacing`数组的实际存储顺序是`(X, Y, Z)`,而NumPy数组的索引顺序却是`(Z, Y, X)`。
如果将这两种顺序混用,就会导致空间测量结果出现错误。
我们在数据输入阶段对坐标进行了转换,使其符合`(Z, Y, X)`的索引规则:
def _to_zyx(vec3, order):
    vec3 = np.asarray(vec3, dtype=float).ravel()
    if order == "xyz":
        return vec3[::-1].copy()      # (x, y, z) -> (z, y, x)
    if order == "zyx":
        return vec3.copy()
    raise ValueError(f"未知的几何顺序 {order!r}")
一个重要的经验是:在设计预处理流程之前,一定要仔细检查多个数据文件。
需要检查的内容包括:
数组的结构
数据的强度范围
体素之间的间距
坐标的表示方式
相关的元数据
可用的标签信息
千万不要假设这些数据遵循其他CT数据集或教程中的约定。
步骤2:将RECIST标记线转换为神经网络可以处理的输入格式
神经网络接收的是一系列输入数据。CT扫描结果就是第一个输入通道;接下来,我们需要将RECIST标记线转换成网络能够识别的形式。
我们最终使用了三个输入通道来处理这些数据:
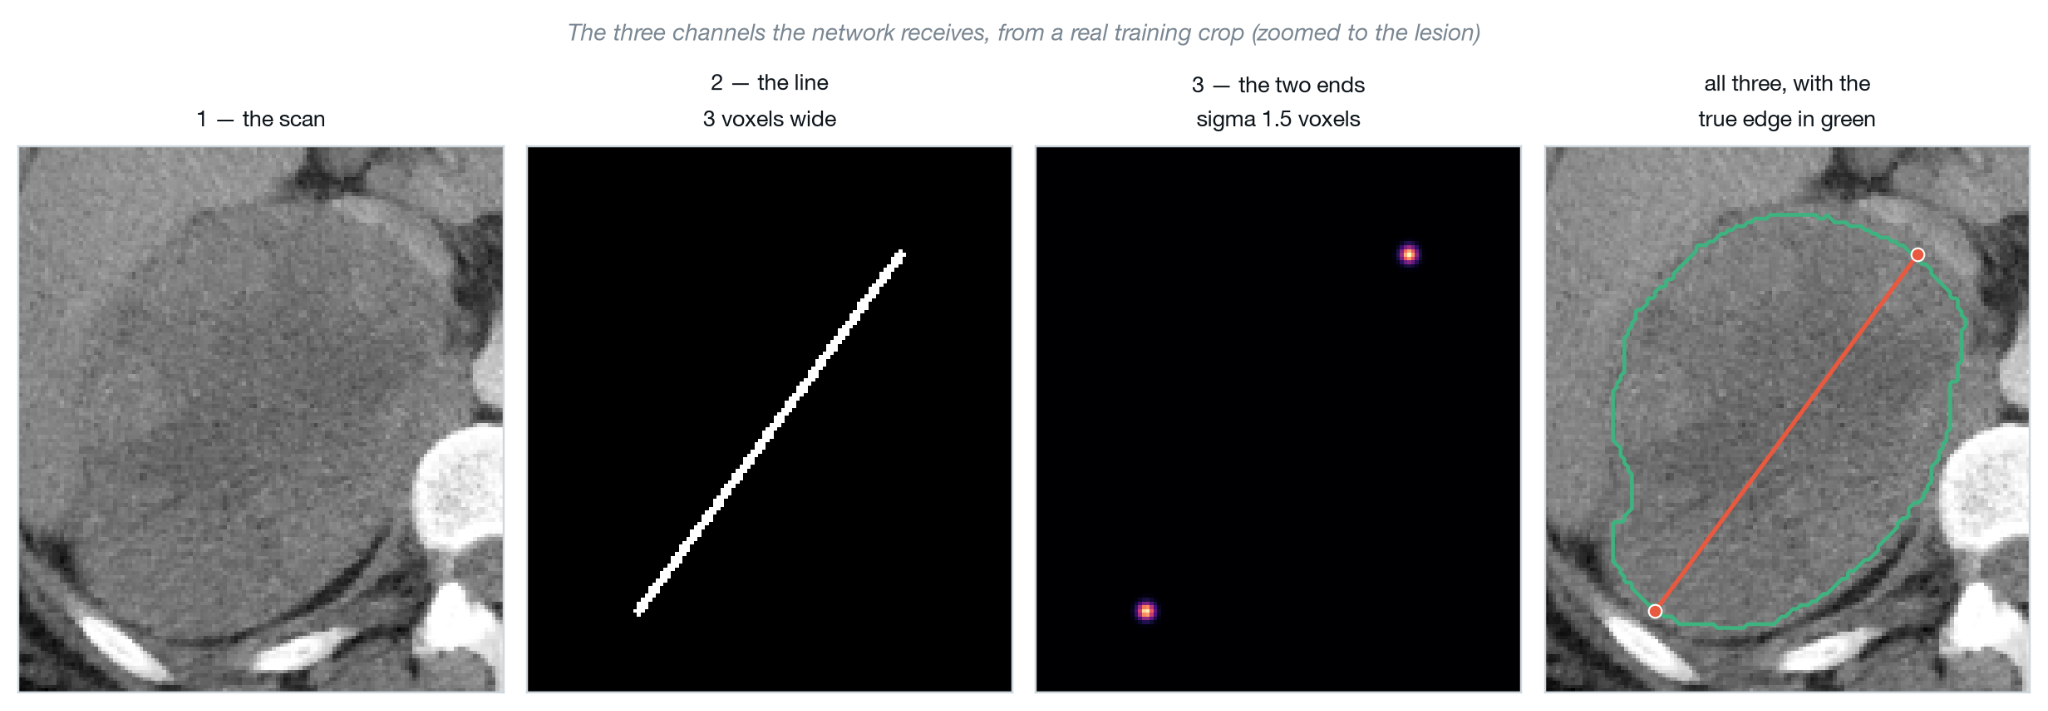
CT扫描结果
RECIST线条,厚度为3个体素
终点热图,每个终点周围都标有高斯分布区域
这两个终点决定了所测量的直径值,并为网络提供了RECIST测量结果的位置和长度信息。
终点信息是通过高斯函数来表示的。每个高斯分布函数在靠近终点的位置数值较大,随着距离的增加数值会逐渐减小。
def _endpoint_heatmap(endpoints_zyx, shape, sigma):
    d, h, w = (int(s) for s in shape)
    heat = np.zeros((d, h, w), dtype=np.float32)

    rad = max(1, int(np.ceil(3 * sigma)))
    two_s2 = 2.0 * sigma * sigma

    for z0, y0, x0 in np.asarray(endpoints_zyx, float):
        zc, yc, xc = int(round(z0)), int(round(y0)), int(round(x0)))

        zl, zr = max(0, zc - rad), min(d, zc + rad + 1)
        yl, yr = max(0, yc - rad), min(h, yc + rad + 1)
        xl, xr = max(0, xc - rad), min(w, xc + rad + 1)

        zz, yy, xx = np.mgrid[
            zl:zr, yl:yr, xl:xr
        ].astype(np.float32)

        g = np.exp(
            -((zz-z0)**2 + (yy-y0)**2 + (xx-x0)**2) / two_s2
        )

        np.maximum(
            heat[zl:zr, yl:yr, xl:xr],
            g,
            out=heat[zl:zr, yl:yr, xl:xr]
        )

    return heat
高斯分布函数仅在每个终点周围的小范围内进行计算。
当sigma = 1.5时,距离终点几个体素远的地方,数值就会变得非常小。因此,如果在整个体积范围内计算高斯分布函数,就会造成不必要的计算开销。
以所需的分辨率绘制线条
我们还会根据网络要求的分辨率,从这两个终点重新绘制RECIST线条。
我们不会先以一种分辨率绘制线条,然后再根据图像的大小对其进行调整。因为调整细线的大小可能会导致线条变得更细,甚至使其断裂;而从头开始根据终点重新绘制线条,则能确保提示信息与图像的分辨率保持一致。
步骤3:将所有肿瘤对齐到同一个网格上
不同的CT扫描结果,其体素间距可能是不同的。
例如,某次扫描可能采用较薄的切片层,而另一次扫描则可能使用较厚的切片层。因此,即使是用相同数量的体素来表示同一物体,其实际尺寸也可能会有所不同。
对于每一个被标记的肿瘤,我们都会创建一个固定大小的裁剪区域,并将其重新采样为固定的体素间距。
我们的配置如下:
target_spacing: [2.5, 1.0, 1.0]     # 每个体素的距离:z轴、y轴、x轴
crop_size:      [64, 160, 160]      # 体素数量:z轴、y轴、x轴
这些平面尺寸所对应的实际视野大小为:
160 × 160 毫米因此,该网络接收到的输入数据尺寸为 64 × 160 × 160。
我们根据训练数据来确定目标像素之间的间距。所选择的2.5毫米的切片间距接近于训练数据集中各切片间距的中位数。
由于训练数据中病变大小的分布情况,我们选择了160毫米的裁剪范围;这个范围能够覆盖99%的病变区域。
强度归一化
我们还利用从训练数据中计算出的统计数值来对CT图像的强度值进行归一化处理:
intensity_mean: 96.88
intensity_std: 79.00
归一化公式为:image = (image - 96.88) / 79.00
这些统计数值完全是根据训练数据计算得出的。
我们在验证数据和测试数据上也使用相同的归一化参数。我们不会重新从验证集或测试集中计算这些数值,因为这样做会使得这些数据影响预处理过程。
对于Lumina来说,训练数据对应的强度平均值是 96.88,标准差为 79.00。我们将这些数值保存在配置文件中,在训练、验证以及推理过程中都使用相同的预处理方法。
步骤4:构建3D分割网络
在这里,我们将使用MONAI框架中的DynUNet模型。
DynUNet是一种基于nnU-Net架构设计的3D U-Net模型,它允许用户配置网络的结构深度、核函数大小、步长以及残差连接的数量。
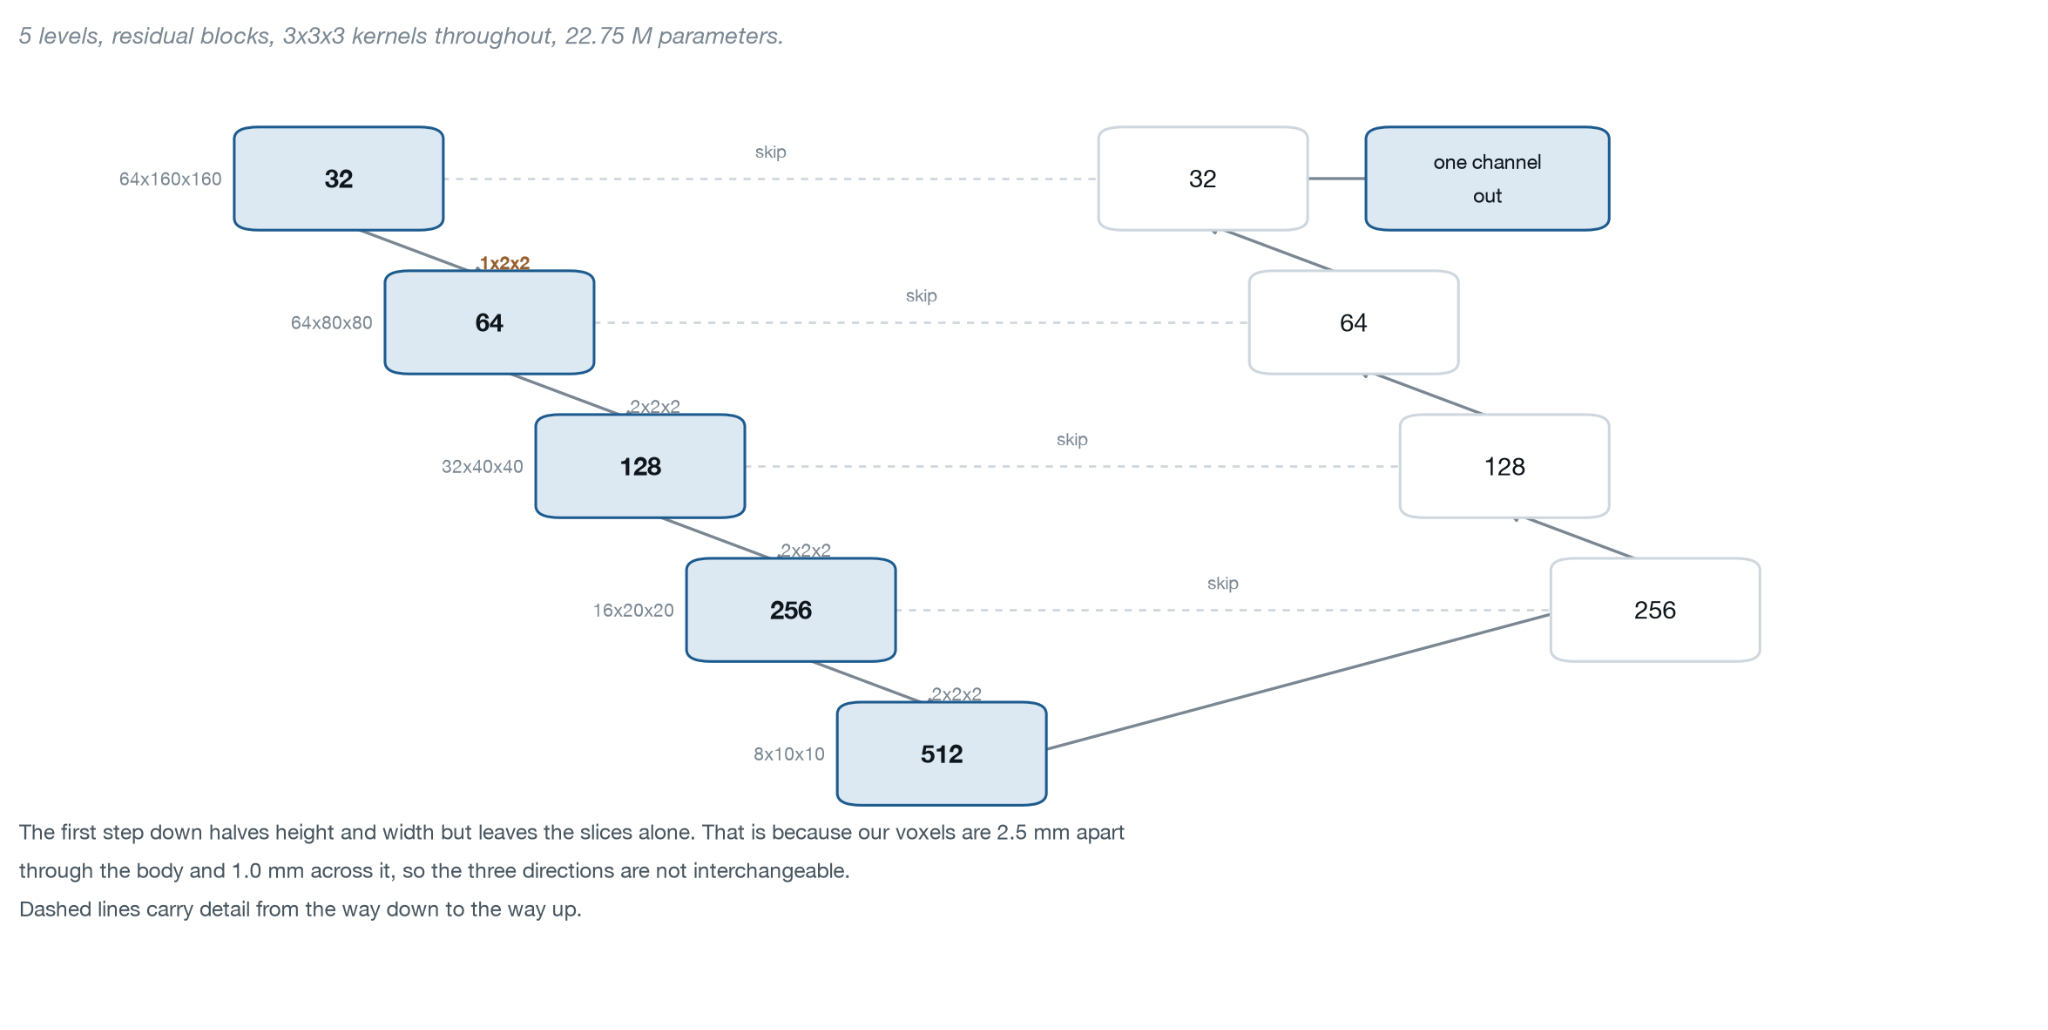
U-Net模型由两个主要部分组成:
编码器会逐步降低空间分辨率,同时提取更高层次的特征。
解码器则会恢复空间分辨率,从而生成最终的分割结果。
跳跃连接机制能够将编码器中保留的精细空间信息直接传递给解码器,这有助于解码器在生成最终分割结果时准确识别肿瘤边界。
对于Lumina来说,该网络接收三种类型的输入数据:
CT扫描图像
RECIST评分相关的信息
表示病变端点的热图数据
模型的具体配置如下:
from monai.networks.nets import DynUNet

# 共5层结构;第一层下采样时会跳过z轴方向的数据。
kernels = [[3, 3, 3]] * 5
strides = [[1, 1, 1], [1, 2, 2], [2, 2, 2], [2, 2, 2], [2, 2, 2]]

model = DynUNet(
    spatial_dims=3,
    in_channels=3,          # 包含CT数据、RECIST评分相关信息和病变端点热图
    out_channels=1,         # 每个体素对应一个概率值
    kernel_size=kernels,
    strides=strides,
    upsample_kernel_size=strides[1:],
    filters=features,
    res_block=True,
)
strides列表是配置中非常重要的一个部分。我们的体素大小各不相同:在不同切片之间,它们之间的距离为2.5毫米,但在同一切片内部,这一距离仅为1.0毫米。如果我们在所有维度上都进行降采样处理,那么层与层之间的细节信息就会很快丢失。因此,在第一步降采样过程中,我们会保持z维度的数值不变。这样就能确保三个方向上的有用信息都能得到保留。
Lumina的主要设计工作集中在输入数据的表示方式、预处理流程、训练策略、后处理方法以及CPU推理性能等方面。
步骤5:使用包含边界信息的损失函数
在训练过程中,网络需要一种方法来衡量自己的预测结果与真实分割结果之间的差异。这种测量方式被称为损失函数。网络会通过调整自身的权重来减少这种差异。
对于Lumina来说,我们结合使用了两种常见的损失函数:Dice损失函数和二进制交叉熵损失函数(BCE)。
Dice损失函数
Dice损失函数主要关注预测出的肿瘤区域与真实肿瘤区域之间的重叠程度。
当我们希望预测区域的整体大小和形状能与参考分割结果保持一致时,这种损失函数非常有用。
二进制交叉熵损失函数
二进制交叉熵损失函数是在体素层面进行计算的。对于每一个体素,网络都会预测出一个介于0和1之间的概率值。
真实标签的值如下:
如果该体素属于肿瘤区域,则概率值为1
如果该体素属于背景区域,则概率值为0
当网络的预测概率与真实标签值不一致时,二进制交叉熵损失函数会对此进行惩罚。
例如,如果一个肿瘤体素的预测概率接近1,那么惩罚幅度就会很小;而如果网络错误地将某个肿瘤体素判断为背景区域,那么惩罚幅度就会很大。
我们通过将这两种损失函数相加来合并它们的效果:
loss = dice_loss + bce_loss这两种损失函数提供了不同的训练信号:
Dice损失函数:有助于促进整体区域的重叠程度。
二进制交叉熵损失函数:有助于确保每个体素的预测结果都是正确的。
添加边界信息
Dice损失函数和二进制交叉熵损失函数都不会对病变区域的边界进行特殊处理。
这一点非常重要,因为即使整体区域的重叠程度很好,但如果边界划分不准确,分割结果仍然可能不够理想。
Lumina的评价标准包括以下两个方面:
Dice损失函数,用于衡量区域重叠程度
NSD(标准化表面Dice值),用于评估指定距离范围内的表面一致性
官方规定的容差值为1毫米。
为了给网络提供更多关于边界的信息,我们额外添加了一个边界信息相关的损失项。
我们通过扩大或缩小目标掩膜,在真实病灶周围生成一条狭窄的边界带:
shell = dilate(target) & ~erode(target)

loss = (
    dice_loss
    + bce_loss
    + 0.5 * bce_loss_on(shell)
)
因此,这三项指标各自承担不同的功能:
Dice损失:用于衡量整体区域重叠程度
BCE损失:表示体素级别的预测准确性
边界带损失:专门用于关注病灶附近的体素
其中,边界带损失的权重为0.5。
比较不同边界损失方法的效果
MONAI还提供了HausdorffDTLoss这一损失函数,它采用基于距离变换的算法机制。
我们可以在训练过程中比较这些不同方法的计算成本:
| 损失类型 | 每步计算耗时 |
|---|---|
| Dice损失 + 交叉熵损失 | 7毫秒 |
| 我们的边界带损失方法 | 203毫秒 |
| MONAI的HausdorffDTLoss | 957毫秒 |
使用Hausdorff距离损失的算法需要cupy库,但我们的训练环境中无法构建该库,因此其CPU实现方式的计算成本相对较高。
而我们的边界带损失方法基于最大池化等形态学操作,其计算成本较低。
对于较大的肿瘤,边界带损失使Dice分数提高了0.0136;而对于较小的肿瘤,实验结果则参差不齐:有15例患者的分数有所改善,而13例患者的分数反而下降了。
步骤6:将概率图转换为分割掩膜
分割网络会生成一张概率图,该图中每个体素的值介于0到1之间,这个数值代表了该体素属于肿瘤的概率。现在我们可以将这张概率图转换成最终的三维分割掩膜,具体步骤如下:
将概率图重新采样回原始的CT图像网格中。
应用阈值处理,生成二值掩膜。
保留与RECIST标准相符的连通组件。
重新采样概率图
在预处理阶段,我们会将CT图像裁剪并重新采样为64 × 160 × 160体素的尺寸。因此,网络也会在这个处理后的网格上进行预测计算。
在生成最终的分割掩膜之前,我们需要先将概率图重新采样回原始的CT图像网格中。
prob_original = resample_to_original_grid(
    probability_map,
    original_image
)
我们之所以在应用阈值处理之前进行这种重新采样操作,是为了确保概率值能够在原始网格上进行插值计算,这样最终得到的边界轮廓才能更加精确。
应用阈值
该算法会为每个体素生成一个介于0和1之间的概率值。我们使用0.35这一阈值,将这个概率分布图转换成二值分割掩膜。
mask = prob_original >= 0.35那些概率值至少为0.35的体素会被认定为肿瘤的一部分,而其余体素则被视作背景。
选择0.35这一阈值的依据是Lumina在验证实验中的经验,这一阈值也成为了最终推理流程中不可或缺的一部分。
确保肿瘤与RECIST线保持连接
经过阈值处理后的掩膜中可能会存在一些相互分离的小区域,其中某些区域可能并不属于肿瘤组织。
由于我们已经知道了肿瘤的具体位置,因此会利用RECIST线来筛选出那些与肿瘤相连的区域。
components = connected_components(mask)
tumor_mask = select_component(
    components,
    recist_line
)
我们最终保留的是那些与RECIST线有交集的区域,将其作为最终的肿瘤分割结果。
概率分布图
      ↓
重新采样至原始CT网格
      ↓
应用阈值(0.35)
      ↓
进行连通分量筛选
      ↓
得到最终的3D肿瘤掩膜
为什么要在阈值处理之前进行重新采样?
步骤7:加快CPU推理速度并确保其一致性
固定线程数
0.35这样的阈值附近,概率值的微小变化就可能会决定某个体素是否会被包含在最终的分割掩膜中。torch.set_num_threads(8)在多次运行中使用相同的线程配置有助于确保推理过程的可重复性。
为推理过程分配预算
我们采用集成方法,因为结合多个模型训练得到的预测结果能够提升分割效果。
该集成系统会使用来自不同输入的数据进行预测,这些数据包括图像的翻转版本,以及经过单独训练的SegResNet模型产生的预测结果。
每次扫描检测到的病变数量可能会有所不同。如果对每个病变都进行4次模型训练,那么对于一个包含5个病变的扫描来说,总共需要20次模型训练,这可能会超出任务规定的运行时间限制。
因此,我们为每次扫描设置了最大的训练次数,并根据实际检测到的病变数量来调整训练次数。
want = max(
    1,
    min(len(members) + 1, cap // max(len_ids), 1))
)
| 肿瘤数量 | 每个肿瘤对应的训练次数 |
|---|---|
| 1个 | 4次 |
| 2个 | 3次 |
| 3个 | 2次 |
| 超过3个 | 1次 |
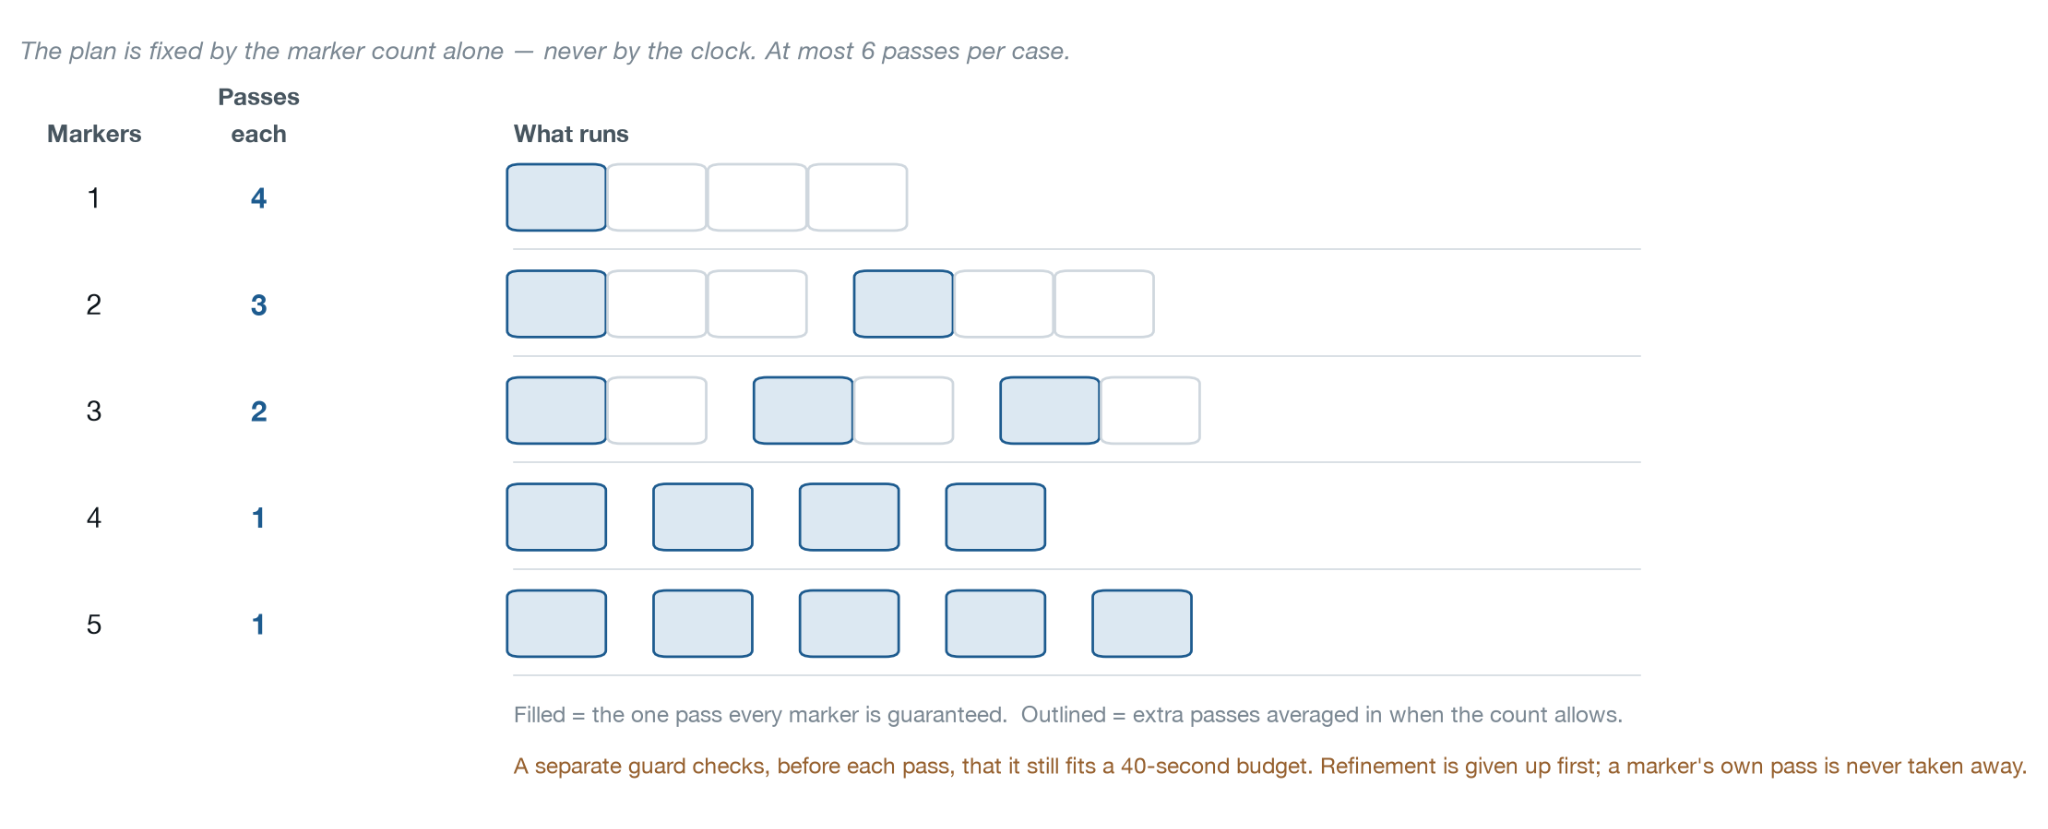
在开始推理之前,就会根据标记的病变数量来确定具体的处理方案。这样就可以确保计算量的可预测性,同时避免结果受到执行剩余时间的影响。
测试得到的结果如下:
| 设置方式 | 得分 |
|---|---|
| 不使用集成方法 | 0.7242 |
| 限制训练次数为4次 | 0.7324 |
| 限制训练次数为6次 | 0.7361 |
| 不限制训练次数(始终进行4次训练) | 0.7410 |
虽然不加限制地使用集成方法能够获得最高的得分,但会超出运行时间限制。而将训练次数限制为6次可以在保证效果的同时,使推理过程在规定的时间内完成。
处理个别故障
在处理多个案例时,某个案例出现故障不应导致整个流程停止。
如果某个案例无法被成功处理,我们会生成一个空的掩码并记录错误信息,然后让流程继续处理剩余的案例。
这样,即使有个别案例出现问题,整个批次的数据处理也能顺利完成。
测试结果
在217份隐藏测试数据中,Lumina取得了以下成绩:
Dice得分:0.7619
NSD得分:0.6094
NSD得分是使用官方规定的1毫米容差范围进行计算的。
平均每个案例的推理时间为20.3秒,最慢的运行时间也为31.8秒。
在8GB的内存限制下,程序的最大内存使用量为2.22GB。
Docker镜像的大小约为559 MB。
定性分析结果
边界清晰的大型病变
第一个例子是一个体积为272.9立方厘米的大型病变,其评估结果如下:
DSC值:0.961
NSD值:0.850
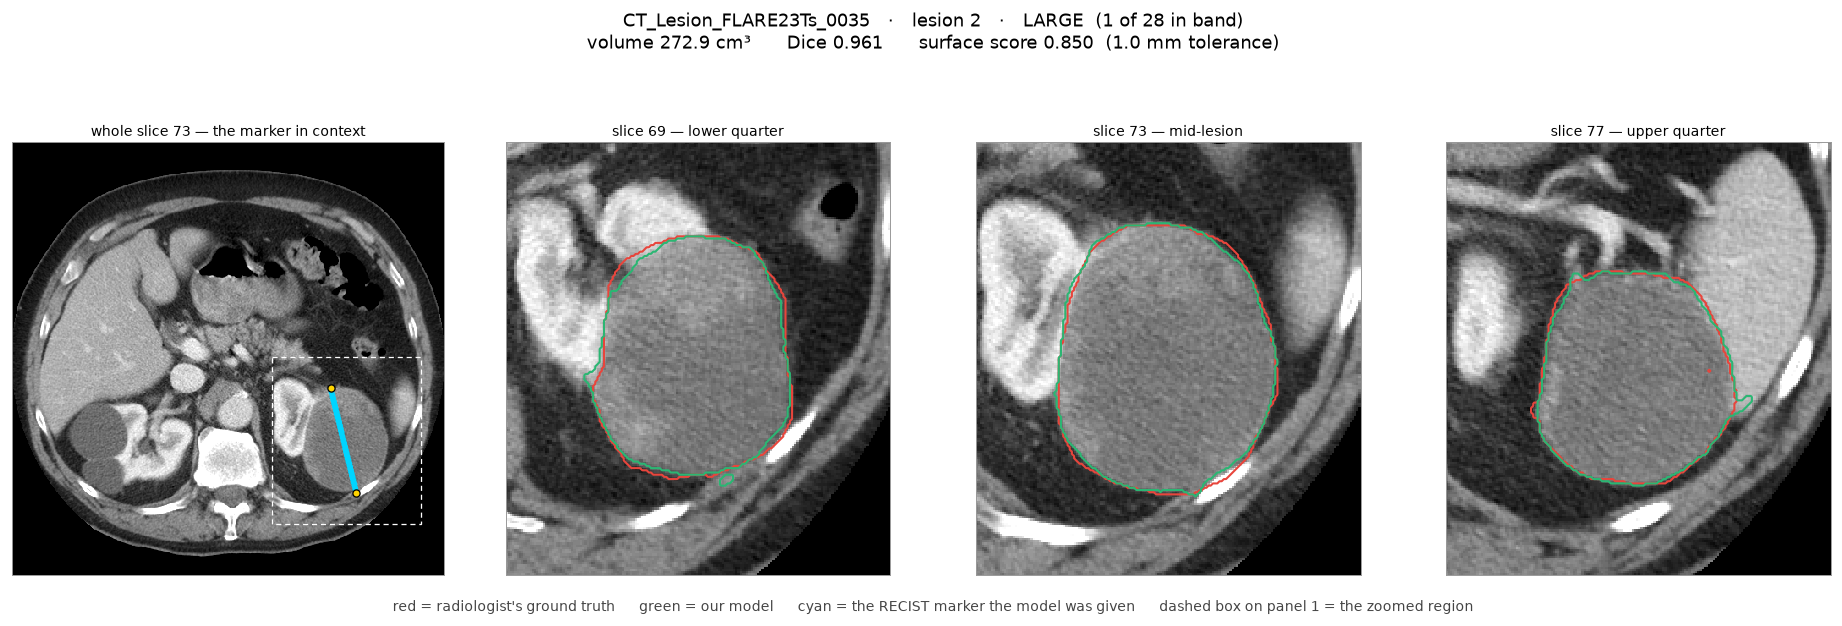
该病变的边界非常清晰,与周围脂肪组织的分界也十分明显。
预测得到的分割轮廓在病变可见范围内与参考边界高度吻合。
边界不明确的中等大小病变
第二个例子是一个体积为28.4立方厘米的中等大小病变,其评估结果如下:
DSC值:0.563
NSD值:0.114
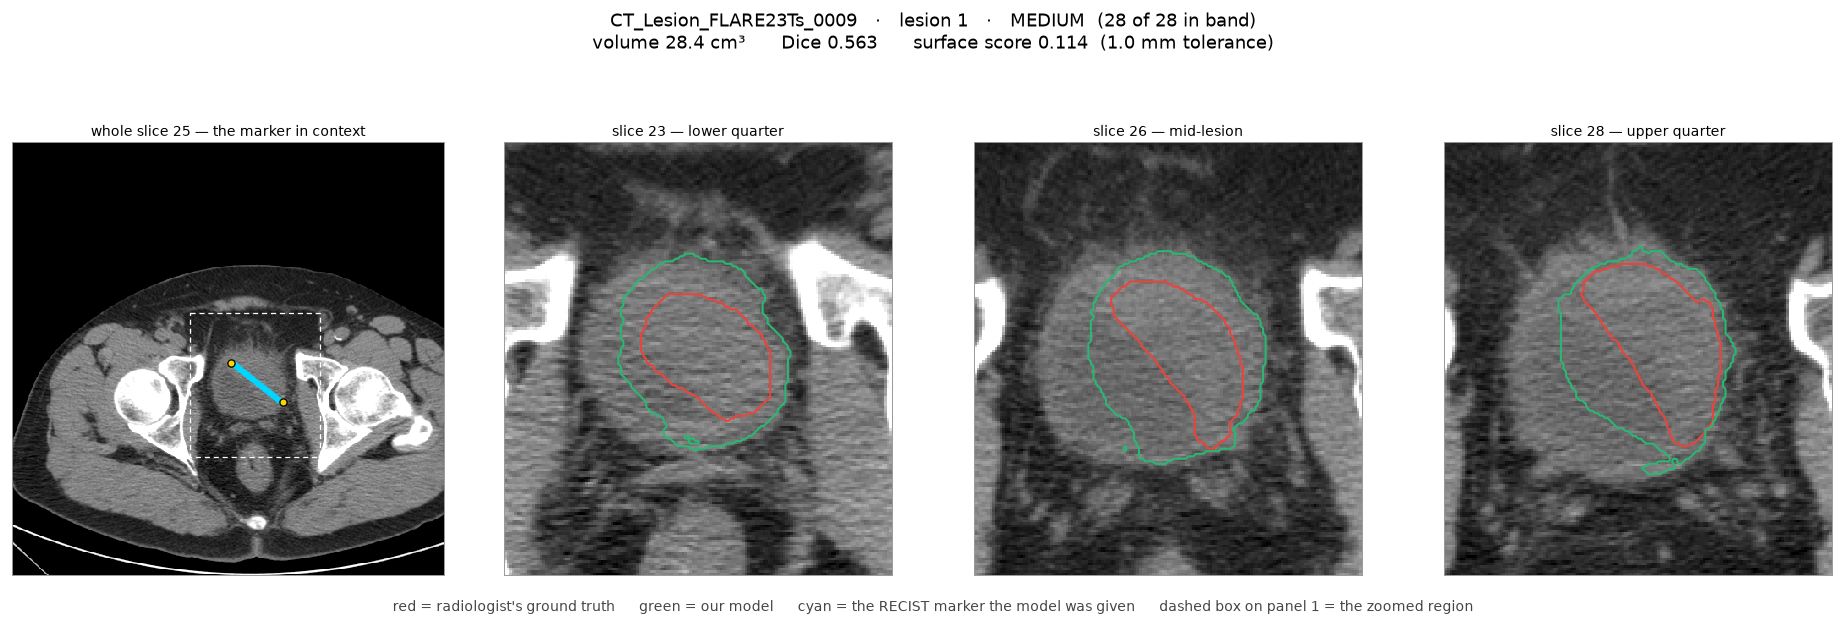
预测结果所覆盖的区域确实比参考标注的范围要大。
放射科医生的审核指出,这类病例中,参考边界的界定本身就可能存在不确定性。因此,较低的数值评分并不一定意味着预测得到的分割轮廓在临床上是不可接受的。
放射科医生审核的结果
我们还请放射科医生对30个病变案例进行了审核,以便更深入地了解Lumina算法所犯的错误类型。
审核结果显示,病变的大小并不是影响分割结果的唯一因素。
边界清晰的病变通常更容易进行分割;而那些边缘模糊或与周围组织外观相似的病例,则会带来更大的分割难度。
主要出现的错误包括:
分割不足:部分病变区域被遗漏了。
分割过度:周围正常组织也被包含在了分割结果中。
边界错误:预测得到的轮廓没有正确反映病变的边界位置。
审核还指出,数值指标应该结合病变的实际边界情况来进行解读。
在某些情况下,参考边界的界定本身就非常困难。因此,较低的评分并不一定意味着预测结果在临床上是不可接受的。
这一现象也与我们在那些分割难度较大的病例中观察到的结果一致——在这些病例中,细微的边界差异就会对NSD值产生显著影响。
适用于其他项目的三条经验
1. 确保验证数据的代表性
验证数据集应能够反映最终系统评估时所使用的实际数据分布情况。
我们用于内部验证的数据来自训练数据集,其中肿瘤体积的中值为814立方毫米。
而竞赛用验证数据集中的肿瘤体积中值为16,805立方毫米,这个数值要大得多。
这种差异直接影响了开发过程中某些改进措施的实际效果。
例如,在内部验证数据集上,某种改进方法在多个训练周期内几乎没有任何效果;但在包含更大规模病变的公开验证数据集中,这种改进方法却显现出了明显的效果。
如果某项改进措施是针对数据分布中的特定部分进行的,那么在验证数据集中也必须体现这一数据分布特征。
2. 测量预处理方法的局限性
在Lumina项目中,将图像裁剪为160毫米大小是一个重要的设计决策。
然而,有些较大的病变区域超出了这个裁剪范围。
在调整裁剪尺寸之前,我们首先测量了裁剪和重采样操作所引入的误差。
我们将真实标记好的病变区域数据通过相同的裁剪和重采样处理流程,然后测量处理后的结果。
对于较大的病变而言,预处理方法所能达到的精度上限为0.9699 NSD,而模型实际实现的精度仅为0.5353 NSD。
这一数据说明,预处理流程在保留病变区域轮廓方面表现尚可,但仅靠预处理本身还是无法解释剩余的误差差距。
我们还尝试了多种方法来扩大图像的视野范围,包括:
使用重叠的图像块
自适应缩放功能
增加裁剪区域的大小
然而这些尝试并未提升最终评估结果。
通过测量预处理方法的局限性,我们明确了后续开发工作的重点方向,应该继续优化模型本身及推理流程。
3. 记录各项数值的来源
模型开发过程中会涉及许多配置参数:
阈值设置
裁剪尺寸
体素间距
损失函数权重
采样权重
集成学习相关设置
运行时限制条件
每一个配置参数都应当有明确的来源记录。
例如,应该详细记录以下内容:
具体测量了哪些指标
使用了哪套数据集
测量是在什么时间进行的
测试过哪些替代方案
最终为何选择这个数值
这样就能方便日后复现实验过程,并理解各项设计决策的依据。
结论
Lumina项目的实践证明,仅凭一条RECIST标准线,就能够从CT扫描图像中准确还原肿瘤的三维结构。
该系统结合了基于提示的输入方式、固定的图像裁剪机制、3D DynUNet模型、具有边界识别功能的训练流程、基于概率的后处理技术,以及受控的CPU推理机制。
在217个未被用于训练的样本上,Lumina在官方规定的1毫米误差容忍范围内,取得了0.7619的Dice分数和0.6094的NSD值。
其平均推理时间为20.3秒,最大内存使用量仅为2.22 GB,完全符合该挑战任务的要求。
实验结果还表明,边界识别的准确性仍然是需要进一步改进的重点,尤其是对于那些面积较大、边界模糊的病变区域而言。
几何上限分析显示,图像裁剪与重采样流程能够有效保留病变区域的轮廓信息,这意味着未来的优化工作应该重点提升分割结果的准确性与稳定性。
总体来说,Lumina展示了一种切实可行的方法:在严格遵守计算资源限制的前提下,将2D RECIST测量结果转化为3D病变分割结果。
相关文章
文章:正在接受测试的大语言模型可靠性指标:准确性、成功率以及验证方法的局限性
验证层是通过对输出结果进行信任度排序来处理数据,而不是直接修正错误。在针对六种不同可靠性机制的测试中,投票机制和自我纠正功能并未能够提升数据的准确性,它们仅仅只是过滤掉了那些可疑的数据记录而已。而在实际的生产系统中,通过用确定性查找方式替代数据生成过程、更加关注系统的产出效率而非纯粹的准确性,并在进行多重验证之前解决数据提取过程中出现的瓶颈问题,才能够显著提高系统的可靠性。 作者:Pushpdeep Mishra, Wejdan Bagais
阅读全文
如何在问题真正发生之前发现运营中的异常变化?
在 我之前的文章中 ,我探讨了“操作符合性”这一概念:即如何判断观察到的实际情况是否满足既定的操作规范。 这就引出了一个很有意义的问题: 当前这个系统是否仍然符合这些规范? 然而,生产环境中的系统是不会一成不变的。 流量会发生变化,依赖关系可能会恶化,证书也会过期,配置设置会被修改,功能开关的状态也会改变,数据量会不断增加,人们还会进行手动操作,各种代理程序也会执行相应的动作,基础设施也会被替换等等。 一个系统在部署后可能最初是符合规范的,但几小时或几天后就可能不再符合这些规范了。 这就是我想在这里探讨的问题。 “操作漂移”指的是系统的实际运行状态与既定操作规范之间的差异会随着时间逐渐增大。
阅读全文
智能代理的可靠性:为工具的使用、安全机制、循环流程以及工作流程的输出结果构建相应的测试框架 [完整书籍]
一个完美的最终结果并不能证明某个具有自主行为能力的人工智能系统的工作流程是正确的。 本书提出了一种基于代码的方法,用于验证系统执行过程及所产生的业务成果,并利用这些证据来决定是否允许该系统正式投入使用。 书中还提供了一个可运行的离线测试工具,用以演示各种核心技术。第19章专门区分了那些已经实现的功能与那些仍处于开发阶段、尚未投入实际应用的扩展功能。 目录 引言 第一部分:可靠性差距 第二部分:基础原理 第三部分:核心结论 第四部分:行为特征 第五部分:跨领域问题 第六部分:决策过程 第七部分:诚实性与普及度 结论 术语表 参考文献 生产就绪性检查清单 引言 那个“虚假的演示” 许多具有自主行为
阅读全文
“从设计层面确保安全性”:在编写任何代码之前,如何将安全机制纳入系统架构之中
在大多数工程团队中,都会进行这样的对话——不过往往为时已晚。 想象一下:某个功能被部署到生产环境中之后,才会进行安全审查;或者在进行渗透测试时发现了问题;更糟糕的是,还会收到事故报告。 这些漏洞确实是存在的,修复它们也需要投入大量成本。而在这些讨论中,总会有人说:“我们需要为这个功能添加安全措施。” 但这个问题就出在这里:安全并不是事后才添加到软件中的东西,而应该从项目一开始就被纳入设计之中。一旦开始考虑为已经存在的东西添加安全功能,那就意味着你已经进入了“事故应对模式”。 “安全驱动设计”是一种完全不同的思维方式——在制定架构决策之前,就应该明确安全要求;在编写任何代码之前,就必须了解潜在的
阅读全文