
如何使用Next.js、AWS以及沙箱环境来构建属于自己的、类似于Lovable这样的AI应用开发工具
像Lovable、Bolt这样的工具,第一次使用的时候真的会让人觉得像是魔法一样。说实话,我第一次看到这类东西的时候简直惊呆了……而且这一切都是通过聊天窗口来完成的!真是太不可思议了。第一次尝试使用Lovable的时候,我甚至产生了一场关于“存在意义”的哲学思考。 但你们有没有想过,其实这些工具内部到底发生了什么?比如说,究竟是怎么让一个应用程序能够生成另一个可以用于测试、分享或下载的应用程序的呢? 显然,在某个地方有一个AI模型在编写代码。但这个过程具体是如何进行的呢?那些代码需要被安装、编译并运行才行。而我有点怀疑的是,现在似乎没有人会在这些代码运行之前去仔细检查它们。这些代码可能会出现错
像Lovable、Bolt这样的工具,第一次使用的时候真的会让人觉得像是魔法一样。说实话,我第一次看到这类东西的时候简直惊呆了……而且这一切都是通过聊天窗口来完成的!真是太不可思议了。第一次尝试使用Lovable的时候,我甚至产生了一场关于“存在意义”的哲学思考。
但你们有没有想过,其实这些工具内部到底发生了什么?比如说,究竟是怎么让一个应用程序能够生成另一个可以用于测试、分享或下载的应用程序的呢?
显然,在某个地方有一个AI模型在编写代码。但这个过程具体是如何进行的呢?那些代码需要被安装、编译并运行才行。而我有点怀疑的是,现在似乎没有人会在这些代码运行之前去仔细检查它们。这些代码可能会出现错误,运行速度也可能很慢,甚至有可能做出一些不应该做的事情,比如用rm -rf命令毁掉整个系统。因为之前确实发生过这样的案例,所以我们也不能完全确定这些代码的安全性。
这篇文章正是要探讨这个问题。
在本文中,你们将亲手构建一个类似于Lovable的AI应用程序开发工具。这个工具并不是简单的克隆版本,而是会深入分析Lovable背后的工作原理,了解它究竟是如何运作的。我们的用户界面也会保持得相当简单。
在我们的项目中,用户可以用普通的英语来描述他们想要创建的应用程序,然后AI会在一个隔离的云环境中生成相应的代码。AI会自行修复其中出现的错误,并展示出一个实时的预览版本。之后,用户可以通过聊天继续对应用程序进行修改,也可以随时回退到之前的版本,最后只需点击一下按钮就能发布完成的应用程序。
本文涵盖的内容:
在这个教程中,你们将从零开始构建整个系统。以下是你们将会学习到的内容:
为什么AI生成的代码需要一个隔离环境
如何用大约4秒钟的时间准备好一个新的隔离环境,而不是像以前那样需要30秒以上
(注:这里似乎有些表述不清楚,但根据上下文推测,应该是介绍如何快速创建新的隔离环境)
如何构建一个能够生成代码、检查自身工作并修复错误的AI模型
如何实时将AI模型的运行过程传输到浏览器中,确保页面刷新后信息不会丢失
如何通过自己的服务器接口来展示实时的预览效果,并支持热加载功能
如何使用Git来记录所有的代码变更,同时确保隔离环境中的代码不会受到这些变更的影响
如何让闲置的隔离环境进入休眠状态,在需要时将其唤醒,并最终发布完成的应用程序
虽然这里涉及一些高级概念,但只要仔细跟随步骤学习,你们肯定能学到很多东西。我在构建这个工具的时候确实学到了很多。
目录
整体架构设计
在开始研究代码之前,了解各个组件是如何协同工作的是非常有帮助的,因为其中有一些概念确实需要提前理解。
该应用程序由三个进程以及几部分基础设施组成。从一开始我就坚持一个原则:Web应用绝对不能直接运行AI代理程序,而代理程序也绝不能在沙箱环境中运行。稍后你就会明白为什么这一点如此重要。
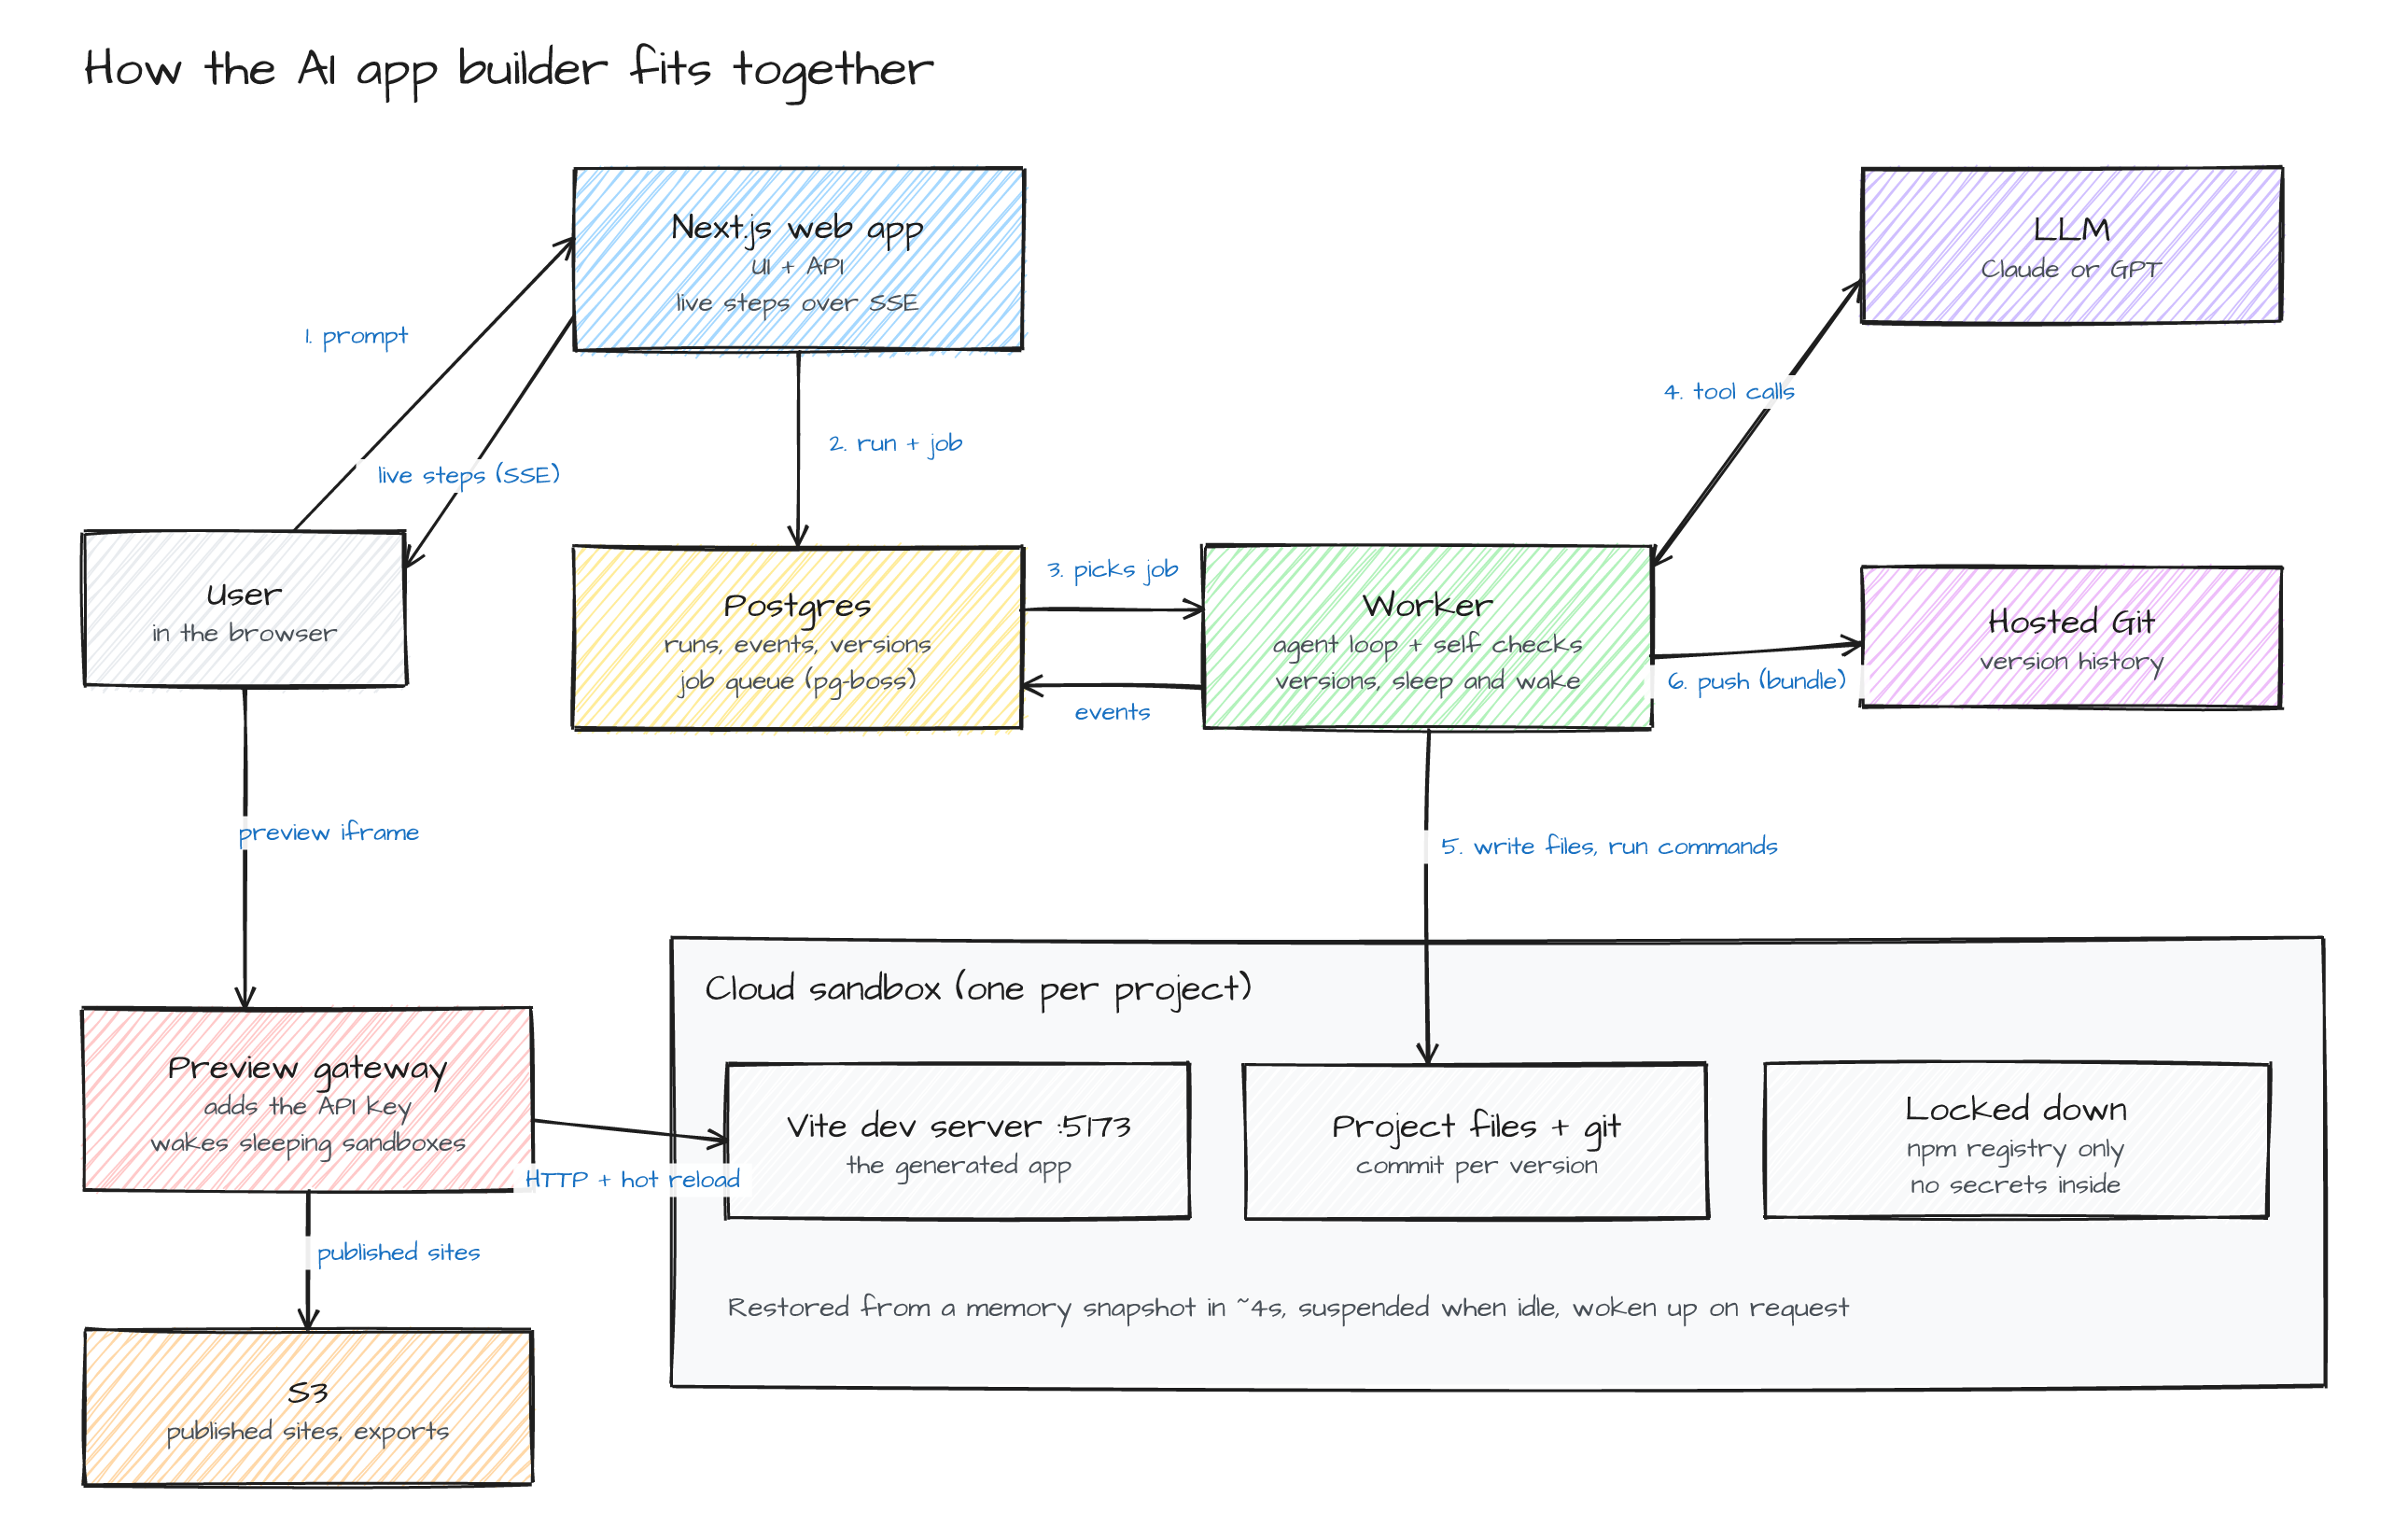
以下是整个流程的详细步骤:
发送提示信息
当用户输入提示信息时,Web应用(Next.js)会将其保存下来,在Postgres数据库中创建相应的记录,然后将任务放入队列中处理,之后立即返回结果。这样一来,用户就不需要等待HTTP请求完成才能看到结果。
运行代理程序
一个工作进程会负责处理这些任务。首先,它会确保沙箱环境处于运行状态,然后启动代理程序的循环执行。LLM会根据当前需求决定该执行哪些操作,而它所进行的所有操作(如写入文件、运行命令、安装包等)实际上都是在沙箱环境中完成的。
每一步操作都会被记录到数据库中作为事件,浏览器就是通过这些数据实时获取更新内容的。
显示预览结果
生成的应用程序会在沙箱环境中运行自己的Vite开发服务器。我们还设置了一个小型网关服务,将http://请求转发到这个开发服务器上,包括Vite用于热重载的WebSocket连接。
因此,当代理程序修改文件时,预览界面会自动更新,每次看到这一幕都觉得非常酷。
保存并发布成果
当代理程序完成所有操作后,工作进程会将这些变更提交为新的版本。当用户点击“发布”按钮时,应用程序会被构建出来,静态文件也会被上传到S3存储服务上,这样即使沙箱环境关闭了,已发布的网站依然可以正常运行。
以上就是我们应用程序的整体架构设计。简单来说:
Next.js: 用户界面与API层
工作进程(Node.js + pg-boss): 代理程序层
网关服务(Node.js代理): 预览展示层
Postgres: 数据存储与任务队列管理层
云沙箱环境: 程序执行层
S3(本地使用MinIO): 文件存储层
任意选择的LLM模型(例如Claude或GPT): 智能推理层
为什么需要沙箱环境?
仔细想想,整个系统本质上就是在运行“未经任何人审核的代码”。代理程序负责编写这些代码,通过 `npm install` 命令下载那些安装脚本能够执行几乎任何操作的包,然后开发服务器会开始运行所有这些内容。我绝对不会在自己的服务器上使用这样的系统,你们也不应该这么做。
因此,每个项目都会拥有自己独立的沙箱环境,这种沙箱实际上就是云端中的小型虚拟机。在我为这个项目挑选沙箱提供商时,我认为以下这些功能是必不可少的:
能够暂停和恢复运行:大多数项目在大部分时间里都是处于闲置状态的。我希望能够让它们进入休眠状态,几秒钟后再次启动,而且它们的内存数据应该保持不变。
支持文件操作、命令执行以及终端界面:代理程序需要读取和写入文件、执行各种命令,同时为用户提供真正的shell界面也会非常方便。
💁 在考虑在生产环境中使用这样的系统时,还有很多其他方面需要考虑,但这些确实是我最看重的要求。
对于这个项目,我选择了 Tensorlake 沙箱服务。需要明确的是,选择这个特定的提供商并没有什么特别的理由——E2B、Daytona、Modal,甚至是你们自己搭建的Firecracker环境也都完全可以使用,你们完全可以根据自己的需求来选择。我已经用它来完成过几个项目了,对于我们的应用场景来说,它的表现非常出色。
注意:所有的沙箱代码都存储在一个包中(`packages/sandbox`)。因此,如果你们想要更换提供商,只需要修改这个包就可以了。应用程序的其他部分甚至都不会知道它正在与哪个提供商进行交互。
如何设置项目环境
在开始之前,请确保你已经安装了以下软件:
Node.js 22或更高版本
pnpm
Docker(如果你打算先在本地进行测试,那么还需要Docker来运行Postgres和MinIO)
你还需要获取你的沙箱提供商以及大语言模型的API密钥(可以选择 Anthropic 或 OpenAI)。
首先,克隆代码仓库并安装依赖项:
git clone https://github.com/shricodev/lovable-build-tensorlake-aws.git
cd lovable-build-tensorlake-aws
pnpm install
接下来,创建环境配置文件并填写相应的密钥信息:
cp .env.example .env
# 添加你的沙箱和大语言模型的密钥,然后使用以下命令生成AUTH_SECRET:
openssl rand -base64 32
现在启动本地开发环境,创建数据库表,并设置存储桶:
# 启动Postgres和MinIO
pnpm infra:up

# 创建数据库表
pnpm db:migrate

# 创建存储桶并配置访问权限
pnpm s3:setup
之后,生成所有新项目都会使用的初始代码快照(具体步骤稍后介绍)。这个过程大约需要45秒的时间。
pnpm sandbox:build-base最后,启动所有服务:
# web服务器运行在端口3000,预览界面运行在端口4000
pnpm dev打开http://localhost:3000,登录后即可开始使用该应用。就这样!🎉
注意:该应用支持通过GitHub登录,同时也提供了简单的开发者登录方式,因此你可以在创建GitHub OAuth账号之前先试用它。放心,开发模式下使用的登录方式在正式环境中是不会被启用的。
应用程序中的核心组件
这个项目规模非常大,如果逐一分析每一行代码,将会花费数小时的时间,因此我只会重点介绍那些真正让系统正常运行的核心组件。比如仪表盘、登录功能以及代码编辑器这类常见的部分,我就不赘述了。
注意:下面展示的代码片段仅包含了最重要的部分,完整的代码可以在仓库中找到。
快速启动沙箱环境
每个新建的应用程序都是基于相同的模板生成的:Vite、React、TypeScript、Tailwind以及一些常用的库。如果采用传统的方法来搭建新项目,步骤大概如下:
创建一个新的沙箱环境
上传模板文件
运行
npm install命令进行安装启动开发服务器
这种方法确实可行,但在我的测试中,从开始到能够访问预览界面竟然花了33.4秒。其中大部分时间(约23秒)都是用于在单个vCPU上执行npm install命令的。我不知道你们怎么想,但我每次启动新项目时,可不想花那么长时间等待。
解决办法是将这些步骤只进行一次,并将结果保存为内存快照。内存快照会记录文件内容、RAM使用情况以及正在运行的进程信息。因此当恢复快照时,开发服务器已经处于运行状态,无需重新启动任何程序。
以下是生成基础快照的核心代码:
export async function buildBaseSnapshot(log: Logger) {
  // 这些步骤只执行一次:创建模板文件、上传模板、安装依赖包、初始化Git仓库,
  // 确保代码能够正常编译、启动开发服务器,并更新Vite的缓存。
  const { ps } = await coldCreateFromTemplate({
    name: `base-${Date.now()}`,
    log,
    verify: true,
  });

  try {
    // 创建内存快照:包含文件内容、RAM使用情况以及运行进程。
    const snapshotId = await ps.checkpoint();
    writeBaseSnapshot({ snapshotId, createdAt: new Date().toISOString() });
  } finally {
    await psterminate();
  }
}
有了这个机制,为新项目创建沙箱环境只需要恢复快照即可,之后再对其进行相应的配置设置。
static async createFromSnapshot(opts: { snapshotId: string; name: string; log: Logger }) {
  const sb = await Sandbox.create({ snapshotId: opts.snapshotId, name: opts.name, timeoutSecs: 600 });
  const ps = new ProjectSandbox(sb, opts.log);

  await sb.update({
    exposedPorts: [5173],              // Vite开发服务器的端口,通过代理可以访问
    allowUnauthenticatedAccess: false, // 该端口的地址永远不会对外公开
    network: {
      allowInternetAccess: true,
      allowOut: ["registry.npmjs.org"], // 只允许访问npm仓库
      denyOut: [],
    },
  });
  return ps;
}
有几点需要注意:
exposedPorts这个设置可以让开发服务器通过提供商的代理被访问,但前提是你必须拥有我们的API密钥。在后续的网关配置中我们会用到这个密钥。network这块代码其实是一个允许列表。一旦allowOut列表中有了某些地址,其他所有地址都会被阻止访问。💁 我实际上用
example.com、github.com以及云服务的元数据IP进行了测试,结果这些地址都被阻止了访问,而npm的功能却依然可以正常使用。在沙箱环境中根本不存在任何敏感信息——没有大语言模型的密钥,没有数据库连接地址,也没有AWS登录凭据,什么都没有。所以即使有人试图通过生成的应用程序或注入提示来窃取数据,他们也根本找不到可窃取的东西。
以下是我测量得到的结果,这些数据是直到预览页面真正加载完成为止所记录的:
| 操作路径 | 耗时 |
|---|---|
| 创建项目、安装依赖包并启动开发服务器 | 33.4秒 |
| 从内存快照中恢复系统状态 | 4.0秒 |
| 唤醒处于休眠状态的沙箱环境 | 2.4秒 |
这速度差不多快了8倍,真是太厉害了!😎
代理循环
代理循环是整个系统的核心。每当用户发送一个提示时,就会启动这个循环。
虽然实现过程可能比较复杂,但原理其实很简单:你给大语言模型设定一个目标,并提供一些工具让它使用,然后收集结果并重复这个过程,直到任务完成。
代理可以使用的工具包括:
list_files、read_file、write_file、edit_file和delete_filerun_command,用于执行像npx tsc --noEmit这样的简单命令install_packages,用于安装npm包get_dev_server_logs和get_browser_errors,用于辅助调试finish,当代理完成任务时就会调用这个函数
这些工具实际上都只是包含Zod数据结构定义和run函数的简单脚本文件。以edit_file为例:
export const editFile = defineTool({
  name: "edit_file",
  description:
    "用于替换文件中某个特定的文本片段。`search`参数必须能够精确匹配目标内容,并且该内容在文件中只能出现一次。",
  schema: z.object({
    path: z.string(),
    search: z.string().min(1),
    replace: z.string(),
  }),
  async run({ path, search, replace }, { sandbox }) {
    const text = await sandbox.readFile(path);
    const count = text.split(search).length - 1;
    if (count !== 1) {
      return {
        isError: true,
        content: `目标文本在${path}中出现了${count}次`,
      };
    }
    await sandbox.writeFile(
      path,
      text.replace(search, () => replace),
    );
    return { content: `文件${path}已修改`, changedFiles: [path] };
  },
});
Zod模式在这里发挥了双重作用:首先,它会被转换为JSON格式,以便供大语言模型使用(通过z.toJSONSchema实现);其次,在任何数据进入沙箱环境之前,它会验证模型返回的数据是否有效。如果输入数据无效,错误信息会直接返回给模型,而不会导致整个运行流程崩溃。
接下来是实际的循环执行部分:
while (true) {
  if (signal.aborted) return result("cancelled");

  const res = await llm.chat({
    system: SYSTEM_PROMPT,
    messages,
    tools,
    signal,
    onText,
  });
  messages.push(res.message);

  const results = [];
  for (const call of res.message.toolCalls) {
    const out = await executeTool(call.name, call.input, ctx); // 验证数据并执行相应操作
    results.push({
      type: "tool_result",
      toolCallId: call.id,
      content: out.content,
      isError: out.isError,
    });
    if (out.finish) finishCalled = true;
  }

  if (!finishCalled) {
    messages.push({ role: "user", content: results });
    continue;
  }

  // 当代理表示任务已完成时,我们进行最终检查。(见下一节)
}
llm.chat这个调用函数是我专门编写的一个封装层,它可以使用相同的接口同时支持Anthropic和OpenAI模型,因此用户可以通过界面中的下拉菜单轻松切换使用不同的模型。
在Anthropic模型中,提示语缓存功能是开启的。说实话,这一功能在大幅降低计算成本方面发挥了关键作用——通常一次对话会消耗超过120,000个标记,而其中几乎所有的数据都直接来自缓存。
保护文件路径的安全性
这个问题的存在有点隐蔽,我也是在仔细检查代码时才发现的。沙箱环境中的文件API会拒绝处理包含..路径成分的请求,但它却会“顺利地”跟随符号链接进行操作。因此,如果生成的代码创建了一个指向/etc/passwd的leak.txt文件,那么读取这个文件就会直接获取到密码文件的内容,这显然是非常危险的。
为了解决这个问题,所有的文件处理操作都会在进入沙箱环境之前先解析出实际的路径:
async safePath(relPath: string) {
  const abs = resolveProjectPath(relPath); // 拒绝包含“..”的路径以及绝对路径、空字节
  const r = await this.sb.run("realpath", { args: ["-m", "--", abs] });
  const real = r.stdout.trim();
  if (!isInsideApp(real)) throw new SandboxPathError(relPath, "路径位于项目文件夹之外");
  return real;
}
realpath -m这个命令会跟随所有的符号链接,最终确定路径的实际指向位置。如果路径位于项目文件夹之外,该命令就会失败。
保持上下文信息的简洁性
在处理新的请求时,系统不会重新执行之前所有的操作步骤,而是会基于以下信息开始新一轮对话:
前面每次交互的简要总结(用户提出了什么要求,代理做出了哪些响应)
文件结构以及已安装的包列表
当前的
src/App.tsx文件内容
让代理自行检查其工作结果
大语言模型们非常自信。当构建过程出现严重问题时,它们也会欣然告诉你一切正常。因此,当代理调用finish方法时,我们并不会仅仅相信它的说法。我们会在沙箱环境中执行三项检查:
export async function runChecks(sandbox: ProjectSandbox) {
  const tsc = await sandbox.exec("npx tsc --noEmit -p . 2>&1", {
    timeoutSecs: 120,
  });
  const build = await sandbox.exec(
    "npx vite build --outDir /tmp/build --emptyOutDir --logLevel error 2>&1",
    { timeoutSecs: 180 },
  );
  const render = await renderCheck(sandbox); // 在虚拟DOM中渲染一次应用程序

  return {
    ok: tsc.exitCode === 0 && build.exitCode === 0 && render.ok,
    typecheck: { ok: tsc.exitCode === 0, output: tsc.stdout },
    build: { ok: build.exitCode === 0, output: build.stdout },
    render,
  };
}
前两项检查非常直观。第三项检查才真正有趣——很多错误只有在运行时才会显现出来,比如Cannot read properties of undefined (reading 'map')这样的错误。通常人们会使用无头浏览器来进行这类测试,但在小型沙箱环境中,这种方法既繁琐又效率低下,所以我并不想采用这种方式。
因此,我们使用了另一个方案:模板中包含了一段小程序码,该代码会利用happy-dom(专为Node.js设计的虚拟DOM框架)以及Vite的ssrLoadModule功能来渲染一次应用程序:
GlobalRegistrator.register({ url: "http://localhost:5173/" });
document.body.innerHTML = '<>/div>';
console.error = (...args) => errors.push(args.join(" "));
await server.ssrLoadModule("/src/main.tsx"); // 运行实际的应用程序入口文件
await new Promise((r) => setTimeout(r, 1500)); // 等待React完成渲染
const rendered = document.getElementById("root").innerHTML.trim().length > 0;
console.log(
JSON.stringify({ ok: rendered && errors.length === 0, rendered, errors }),
);
这个过程只需要大约2秒钟,就能检测出undefined.map导致的错误,并准确指出出错所在的App.tsx文件行号。真是太棒了!
如果任何一项检查失败,错误信息会立即被发送回代理端,代理就会再次尝试修复这些问题:
lastCheck = await runChecks(sandbox);
if (lastCheck.ok) return result("succeeded");
if (healRounds >= maxHeal)
return result("failed", { error: describeFailures(lastCheck) });
healRounds++;
messages.push({
role: "user",
content: [
...results,
{
type: "text",
text: `验证失败。请修复这些问题,然后再调用finish方法。\n${describeFailures(lastCheck)}`,
},
],
});
默认情况下,这个流程会进行3轮检查。如果经过3轮检查后问题仍未解决,系统就会向用户明确告知“无法完成这项任务”,并同时提供具体的错误信息。
向浏览器发送流式处理进度信息
代理程序在后台工作线程中运行,但用户是通过浏览器来查看处理进度的。因此,每一个处理步骤(如“编写了src/App.tsx文件”、“执行了npx tsc --noEmit命令”、“检查通过”等)都必须能够在两者之间实时传递。
后台工作线程会将每个处理步骤作为一条记录存储到run_events表中,然后通过Postgres发送NOTIFY通知:
export async function appendEvent(
db: Db,
e: { projectId: string; runId?: string; type: string; payload: unknown },
) {
const [row] = await db
.insert(runEvents)
.values(e)
.returning({ id: runEvents.id });
await db.$client.notify(
"events",
JSON.stringify({ projectId: e.projectId, id: row.id }),
);
return row.id;
}
在Web端,Next.js的路由处理程序会利用“服务器发送事件”功能将这些信息实时传输给浏览器。当浏览器连接上后,它会首先重新播放当前正在进行的处理流程的所有步骤,之后就会持续监听新的更新信息:
const pump = async () => {
const rows = await db
.select()
.from(runEvents)
.where(and(eq(runEvents.projectId, project.id), gt(runEvents.id, cursor)))
.orderBy(asc(runEvents.id));
for (const r of rows) {
cursor = r.id;
send(`id: ${r.id}\ndata: ${JSON.stringify(r)}\n\n`);
}
};
bus.on(project.id, pump); // 每个进程都会通过一个单独的监听连接来触发这个函数
pump(); // 先重新播放之前的所有步骤
由于所有的处理信息都存储在数据库中,因此在处理流程进行到一半时刷新页面也不会丢失任何数据。浏览器会重新连接并重新执行已完成的步骤,然后从上次停止的地方继续处理。点击“停止”按钮的效果也是一样的,只不过进程会反向终止。
注意:来自大语言模型的流式文本是按一个个令牌的形式传输的,如果将每个令牌都保存下来,那么每次更新就会在数据库中生成数百条记录。因此,后台工作线程会先将这些令牌暂存起来,每隔250毫秒才向数据库写入一条记录。我之前还发现了一个小问题:由于每次写入操作都是独立的异步操作,导致事件记录的顺序发生了混乱。后来通过将所有的写入操作纳入同一个异步处理链中,这个问题得到了解决。
实时预览网关
生成的应用程序的开发服务器运行在沙盒环境中,端口为5173,而提供者会通过类似https://5173-<sandbox-id>>.sandbox.example这样的URL将这个开发服务器暴露出来。虽然可以直接将这个URL放入iframe中使用,但这样做存在两个问题:
浏览器要加载这个页面,就需要我们的沙盒API密钥。显然,用户是无法直接获取到这个密钥的。
如果我们将这个URL公开,那么任何知道这个地址的人都可以访问它,我们就无法控制哪些人能够看到哪些内容了。
因此,我们在前面添加了一个自己的小型网关。该网关会将<project-id>>.preview.localhost:4000这样的请求路由到正确的沙盒环境,并在服务器端添加API密钥进行身份验证:
const proxy = createProxyServer({ changeOrigin: true, secure: true, ws: true });
const server = http.createServer(async (req, res) => {
const projectId = HOST_RE.exec(req.headers.host ?? "")?.[1];
const target = await resolve(projectId); // 将项目ID解析为对应的沙箱地址,该地址会被缓存几秒钟
if (!target.sandboxId) return send(res, noPreviewPage());
delete reqheaders.cookie; // 绝不转发访问者的身份凭证
delete req.headersauthorization;
proxy.web(req, res, {
target: previewUrlFor(target.sandboxId),
headers: { authorization: `Bearer ${API_KEY}` },
});
});
// Vite的热重载功能是通过WebSocket来实现的,因此升级操作也会通过这个代理机制进行。
server.on("upgrade", async (req, socket, head) => {
const target = await resolve(HOST_RE.exec(req.headers.host ?? "")?.[1];
proxy.ws(req, socket, head, {
target: previewUrlFor(target.sandboxId).replace (^https/, "wss"),
headers: { authorization: `Bearer ${API_KEY}` },
});
});
正是这个upgrade处理程序让预览功能具备了实时更新的能力。每当代理服务器编辑某个文件时,Vite会通过WebSocket将更改内容发送过去,这样预览页面就能自动更新,而无需用户重新加载页面。
设置这样一个代理服务器还有另一个原因,不过这个原因很容易被人们忽略。预览版本是在一个不同的域名下运行的(地址为*.preview.localhost),而主应用程序则运行在localhost:3000上。因此,生成的预览版本根本无法读取主应用程序的cookie信息,也无法以登录用户的身份调用其API接口。另外,由于在现代浏览器中,*.localhost会解析为127.0.0.1,所以甚至不需要修改系统的hosts文件就能实现这种隔离效果。
注意:模板还会在预览页面中插入一段小程序代码,这段代码会监听window.onerror事件,并将错误信息发送到父窗口。随后,工作区会将这些错误信息转发给后端服务器,而代理程序中的get_browser_errors工具就是从后端获取这些运行时错误的。
使用Git进行版本控制
每当用户完成一次开发操作,就会生成一个新的版本。因此,用户可以随时恢复到之前的某个具体版本,这有点类似于使用git reset命令。
对于这种需求来说,在沙箱环境中使用普通的Git工具就完全足够了。初始状态下的代码库中已经包含了模板文件作为第一个提交内容,而在每次开发操作完成后,工作进程都会将所有更改提交到代码库中:
export async function commitAll(ps: ProjectSandbox, message: string) {
const out = await git(
ps,
`git add -A
if git diff --cached --quiet; then
echo NOCHANGE
else
git commit -q -m "$MSG"
git rev-parse HEAD
git show --name-only --format= HEAD
fi`,
{ MSG: message },
);
if (out.trim() === "NOCHANGE") return null;
const [sha, ...files] = out.trim().split("\n");
return { sha, files };
}
注意:你可能会疑惑为什么这里没有exit 0这条命令。实际上,这些命令是在bash -l环境下运行的,而在登录 shell环境中直接使用exit命令会执行~/.bash_logout脚本,而在这个脚本中如果最后一条命令失败了,就会导致退出代码变为错误码。这个问题确实花了我好长时间才弄明白。😭
恢复操作并不会改写历史记录。它只是让文件内容与之前的提交版本完全一致,然后将其作为一个新的版本进行提交。因此,“恢复版本1”实际上会生成版本5,而你仍然可以随时回到版本4。没有任何数据会被丢失。
保持历史记录的持久性(无需在沙箱中使用令牌)
虽然沙箱环境中的Git功能非常实用,但它存在的时长仅与沙箱本身相同。因此,在每个版本更新后,相关历史记录也会被推送到一个托管的Git仓库中。
最直接的做法是为沙箱分配一个Git令牌,然后直接执行`git push`命令。但我能够使用的那些令牌是针对整个项目而言的,并不是针对某个单独的仓库。将这样的令牌用于包含不可信代码的沙箱中?显然,这是不可取的。
因此,沙箱本身并不会直接执行推送操作。它会创建一个`git bundle`文件(实际上就是将整个仓库内容压缩成一个文件),然后由其他进程读取这个文件并完成推送操作:
export async function pushToHostedGit(
ps: ProjectSandbox,
repo: string,
dataDir: string,
) {
await git(ps, "git bundle create -q /tmp/repo.bundle main");
const bundle = await ps.sb.readFile("/tmp/repobundle");
const mirror = join(dataDir, "git", `${repo}.git`); // 在工作进程中创建一个空的Git仓库
writeFileSync(join(mirror, "incoming.bundle"), bundle);
await run("git", [
"-C",
mirror,
"fetch",
"-q",
"--force",
"incomingbundle",
"+refs/heads/main:refs/heads/main",
});
const cred = await repos.credential(repo); // 在工作进程中使用的临时令牌
await run("git", [
"-C",
mirror,
"-c",
`http.extraHeader=Authorization: Basic ${basic(cred)}`,
"push",
"-q",
"--force",
url,
"main",
]);
}
这种做法还有一个很好的副作用,那就是它也能够支持remix功能。当有人复制了一个共享项目时,工作进程会从托管仓库中读取源项目的文件内容,并将其放入一个新的沙箱中,而原来的沙箱甚至不需要被重新启动。
沙箱的暂停、唤醒与共享
即使没有人正在使用一个处于运行状态的沙箱,它仍然会消耗资源。因此,系统会每隔一分钟执行一次检查任务,如果某个沙箱已经10分钟没有被任何进程访问过,就会将其暂停。这样就可以节省内存资源,确保开发服务器能够保持之前的状态。
沙箱的唤醒过程是在网关中完成的。当有人尝试查看一个处于暂停状态的项目时,网关会显示一个“正在唤醒您的应用…”的提示页面,该页面会不断更新内容,并在后台恢复沙箱的运行:
if (isPage && target.status === "suspended") {
const outcome = wake(projectId, target, log); // 每个项目都会单独处理
const done = await Promise.race([outcome, timeout(4000, "pending")]);
if (done === "busy") return send(res, busyPage());
if (done !== "running") return send(res, wakingPage()); // 页面会自动更新
}
在我的测试中,一个处于休眠状态的沙箱在大约3秒后就被唤醒了,应用程序也随之立即加载完成。🎊
共享有限数量的沙箱
大多数沙箱提供商都会限制用户同时可以运行的沙箱数量,尤其是在免费套餐中。因此,我添加了一个简单的并发检查机制,所有这些操作都是在Postgres数据库中通过 advisory lock机制来实现的,这样就能确保两个进程永远不会同时做出相同的决策:
async function decide(db: Db, projectId: string) {
return db.transaction(async (tx) => {
await tx.execute(sql`select pg_advisory_xact_lock(${LOCK_KEY})`);
const live = await runningSandboxesOldestFirst(tx);
if (live.some((s) => s.projectId === projectId)) return { kind: "ok" };
if (live.length < concurrencyLimit()) return { kind: "ok" };
// 如果所有沙箱都已被占用,就暂停使用最久未使用的沙箱来释放一个空位。
const victim = live.find((s) => !busyProjects.has(s.projectId));
if (victim) return { kind: "evict", sandboxId: victim.sandboxId };
return { kind: "wait", position }; // 如果所有沙箱都占用了,就等待空位释放...
});
}
为了验证这一机制,我将并发限制设置为1,然后向其中一个项目发送请求,而另一个项目的沙箱则处于闲置状态。处于闲置状态的沙箱会被唤醒并占用一个空位,随后我又向第一个项目发送请求,此时系统会显示“正在等待空闲沙箱,当前排队顺序为第1位”,直到有沙箱空出来为止。如果你使用的是更高配的套餐,只需在.env文件中调整并发限制数值即可,其他设置都不会发生变化。
发布应用程序
在开发过程中使用预览版本固然不错,但你肯定不希望发布的正式应用程序依赖于一个每10分钟就会进入休眠状态的沙箱系统。
因此,在发布应用程序时,系统会将其构建结果转换成普通的静态文件:
export async function publish(project: Project) {
const ps = await projectSandbox.project.id); // 如有需要,会唤醒该沙箱
const build = await ps.exec(
"rm -rf dist && npx vite build --outDir dist --emptyOutDir 2>&1",
{ timeoutSecs: 180 },
);
if (build.exitCode !== 0)
throw new HttpError(422, `构建失败:\n${build.stdout.slice(-1500)}`);
const files = await listFiles(ps, "dist");
const prefix = `published/${slug}/${versionId}/`;
for (const f of files) {
const bytes = await ps.readBytes(`dist/${f}`);
await storage.put(prefix + f, bytes, contentTypeFor(f), cacheControlFor(f));
}
await savePublishedSite({ projectId: project.id, slug, s3Prefix: prefix });
return { url: publishedUrlslug) };
}
之后,网关会通过S3服务器提供这些文件,访问地址为http://.app.localhost:4000 。Vite工具会对某些文件进行哈希处理,因此这些文件的路径会变为类似assets/index-CScgwd68.js的形式,这样的文件会被永久缓存;而index.html文件则会定期重新验证,这样更新内容就能立即显示出来。对于那些没有文件扩展名的路径,系统会自动回退到index.html,因此客户端路由功能也能正常工作。
被发布的网站通常会特意使用独立的子域名。如果这些网站使用主应用程序的域名,那么被发布的应用程序所使用的JavaScript代码就可以利用当前访问该页面的用户所拥有的cookie来调用你的API,而这是你绝对不希望发生的。😺
在我的测试中,发布一个应用程序大约需要6秒钟的时间,而当沙盒环境处于关闭状态时,该网站在4毫秒内就能加载完成,因为这些代码根本不会接触到沙盒环境。
应用构建工具的实际使用效果
下面是一个关于这个应用构建工具实际使用效果的快速演示:
出于好奇,我还进行了一项小规模的测试。我向两个不同的模型发送了相同的三个请求内容(一个习惯追踪工具、一个看板系统以及一个带有图表的费用管理界面),这两个模型都运行在全新的沙盒环境中:
模型
通过测试(包括构建和渲染过程)
平均耗时
Claude Sonnet 5
3/3
135秒
GPT 5.5
3/3
92秒
这六个应用程序在第一次测试时就都成功完成了构建和渲染过程,而且根本不需要进行任何修改,这一点真的让我感到有些惊讶。使用Claude模型来构建这些应用程序,每個应用程序的开发成本大约在0.15美元到0.20美元之间。
结论
那么,你们对这个项目有什么看法呢?自从人工智能技术开始取代传统的编码工作以来,这确实是我参与过的最有趣的项目之一了。🤦♂️
当你使用像Lovable这样的工具时,很容易认为整个开发过程主要取决于提示语和模型本身。但一旦你自己亲自尝试构建一个应用程序,你就会意识到,实际上大部分工作都集中在与模型相关的一些细节上,比如代码应该在什么地方运行、启动速度如何、如何向用户展示最终结果,以及如何防止它做出一些不应该做的事情。
如果让我让你们从这次体验中带走一个关键点的话,那就是沙盒环境的重要性。对于人工智能生成的代码,我们应该将其视为不可信任的代码;应该为它们创建独立的、没有隐藏设置且几乎无法访问外部网络的运行环境。通过使用内存快照功能以及暂停/恢复机制,我们可以确保这些代码的运行速度足够快,同时开发成本也相对较低。
这个系统还有很大的扩展空间。例如,我们可以在模板中添加一个简单的后端服务(比如使用Hono和SQLite),这样用户就可以构建完整的栈式应用程序;也可以让用户点击预览界面中的某个元素来直接编辑该组件,或者针对同一个提示语生成多种不同的设计版本进行对比查看。不过目前我实在是太累了,暂时没有精力去实现这些功能了,就留给你们来完成了吧。✌️
基础框架已经搭建好了,后续的工作只需要在此基础上进一步扩展即可。
完整的源代码可以在这里找到:shricodev/lovable-build-tensorlake-aws
这就是这篇文章的全部内容了。非常感谢大家的阅读!下次再见吧。🫡
相关文章
技术实践
如何将Jekyll博客主题移植到Python环境中:实际操作中的经验与教训
几年来,我一直在使用一个采用 tufte-jekyll 样式设计的博客,正是这个经历让我发现了Edward Tufte所提出的布局理念。 Edward Tufte 因在数据可视化与信息设计领域的贡献而闻名,他是高数据密度设计的坚定支持者,同时也极力反对使用那些毫无意义的视觉元素。 tufte-css (以及它的许多衍生版本)为网页设计带来了诸多优势:充足的空白空间、适合阅读的排版格式,还有用于提供补充信息的 侧边注释 (而非干扰用户体验的弹出窗口)。 除了那些与写作无关的部分外,我对 tufe-jekyll 博客的设计几乎毫无意见。这个基于 Jekyll 框架、使用 Ruby 语言开发的版本,
阅读全文
技术实践
如何编写能够真正被编译成功的Linux内核模块
Linux中的 内核模块 是一段较小的代码,可以在不重新构建整个内核的情况下被加载到正在运行的内核中。 这听起来很简单,但实际上,即使是最简单的模块也会产生大量相关的文件和数据:对象文件、元数据、导出的符号以及未解析的符号,最后还会生成一个与普通可执行文件截然不同的 .ko 文件。 下面是一个完整的、可以正常工作的Linux内核模块。它的代码仅有22行,其中7行是包含头文件和元数据: #include #include #include MODULE LICENSE("GPL"); MODULE AUTHOR("Chris Roy"); MODULE DESCRIPTION("一个最小的可加载
阅读全文
技术实践
面向初学者的Node.js与Express.js使用指南——服务器、路由机制以及视图处理方法的详细讲解
Node.js是一种用于在浏览器之外执行JavaScript的运行时环境。无论是小型脚本还是大规模的后端应用程序,Node.js都提供了构建适用于各种环境的JavaScript应用所需的API和工具。 然而,学习Node.js可能会让人感到不知所措。由于有太多需要理解的API、包、工具和概念,人们很容易迷失方向。 正因为如此,这本书重点讲解了构建实际应用所需的基础Node.js知识,避免了不必要的干扰。你将了解到Node.js的工作原理,如何使用其内置的API,以及如何创建能够处理文件、URL、事件、HTTP请求等功能的应用程序。 你还会学习到Express.js是如何简化许多常见的服务器端任
阅读全文
技术实践
如何使用VS Code的语言API在TypeScript中构建代码图表
现代的代码库变得越来越难以浏览。这并不一定是因为开发人员自己编写了更多的代码,而主要是因为编码辅助工具会生成成百上千行代码,因此代码审查成为了了一个亟待解决的问题。 在大型语言模型出现之前,你可能需要花费数天的时间才能编写出几行代码。这意味着你的参与会让某个项目的代码结构逐渐丰富起来;只有当你加入新的团队或开始新的工作时,才需要去审查和了解那些新添加的代码。 但如今,一个简单的指令就能在几分钟内生成数千行代码,这些代码分散在上百个文件中。在这种规模下,传统的代码审查方式已经不再适用了——你花费在审查代码上的时间,实际上比编写代码的时间还要多。 例如,如果你打开一个庞大的TypeScript项目
阅读全文